

Python静态图表与交互式可视化库怎么选?适用场景全解析
全面解析Python静态可视化库与交互式图表库的核心差异、技术选型依据及适用场景,帮助开发者和数据分析师在学术出版、业务报表、Web看板等任务中准确选型。
在 Python 数据分析与可视化生态中,选定图表库的核心依据在于交付载体与交互诉求:需要交付打印论文、静态 PDF 报告或无浏览器的离线自动化任务时,优先选用以 Matplotlib 和 Seaborn 为代表的静态图表库;若交付场景为 Web 页面、BI 仪表盘,或读者需要通过缩放、悬浮钻取和联动筛选主动探索数据时,则应选择以 Plotly、Bokeh 或 Altair 为代表的交互式库。本文将围绕底层渲染差异、四个评估维度、核心场景匹配及典型代码工作流展开完整解析,提供明确的技术选型决策路径。
一、底层逻辑与技术架构差异
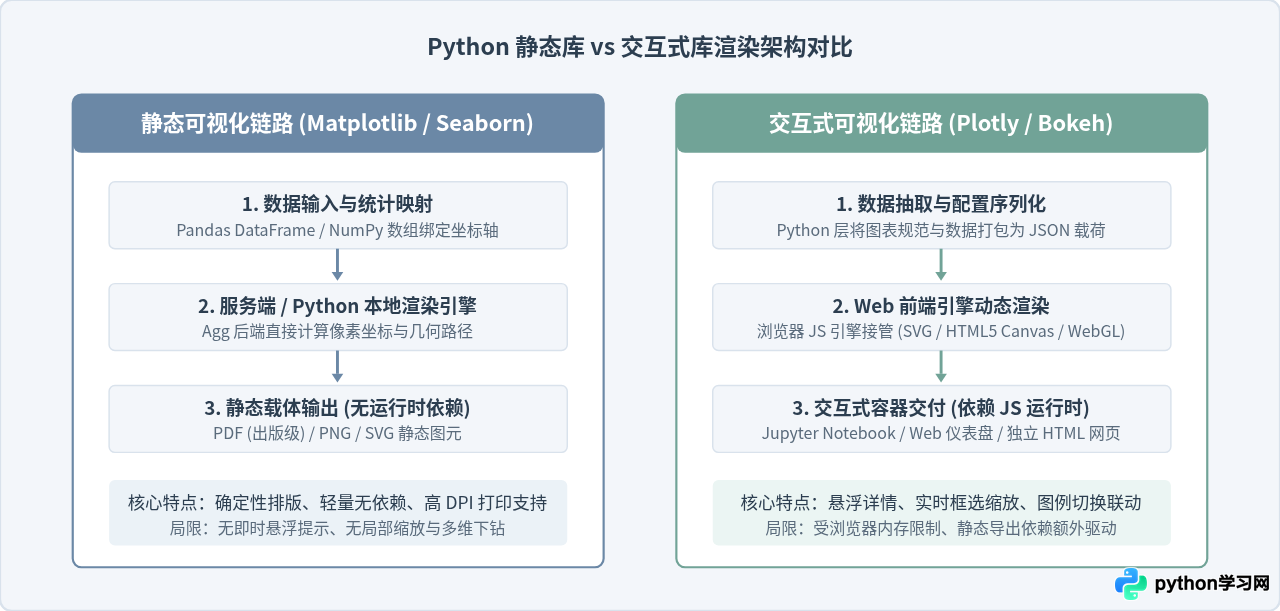
静态库与交互式库在底层的设计目标与渲染机制上存在本质差异。这种差异决定了二者无法相互取代,而是分别锚定不同的生产环节。
以 Matplotlib 为代表的静态库基于“后端画布渲染”机制。数据输入后,由 Python 进程在服务端或本地直接计算点阵或矢量坐标,生成确定性的栅格位图(PNG、JPEG)或矢量图形(PDF、SVG、EPS)。渲染完成后,图形是固定的静态像素或矢量路径集合,不再包含数据点上下文,内存开销在此阶段即已释放。Seaborn 则是在 Matplotlib 之上封装的统计绘图库,增强了对 Pandas DataFrame 的语义映射能力与统计模型表达,但底层依然遵循静态输出范式。
以 Plotly 与 Bokeh 为代表的交互式库则基于“数据驱动的前端渲染”机制。Python 代码的核心职责是将配置项和原始数据结构序列化为 JSON 规范,随后交由运行在浏览器环境中的 JavaScript 渲染引擎(如 Plotly.js 或 BokehJS)执行渲染。读者在浏览器中操作鼠标时,JavaScript 引擎会监听事件并重新计算视图,实现缩放、框选与浮动工具提示(Tooltip)。这意味着图形具备持续的上下文交互能力,但同时也带来了浏览器内存占用与前端计算开销。
二、四步选型决策路径
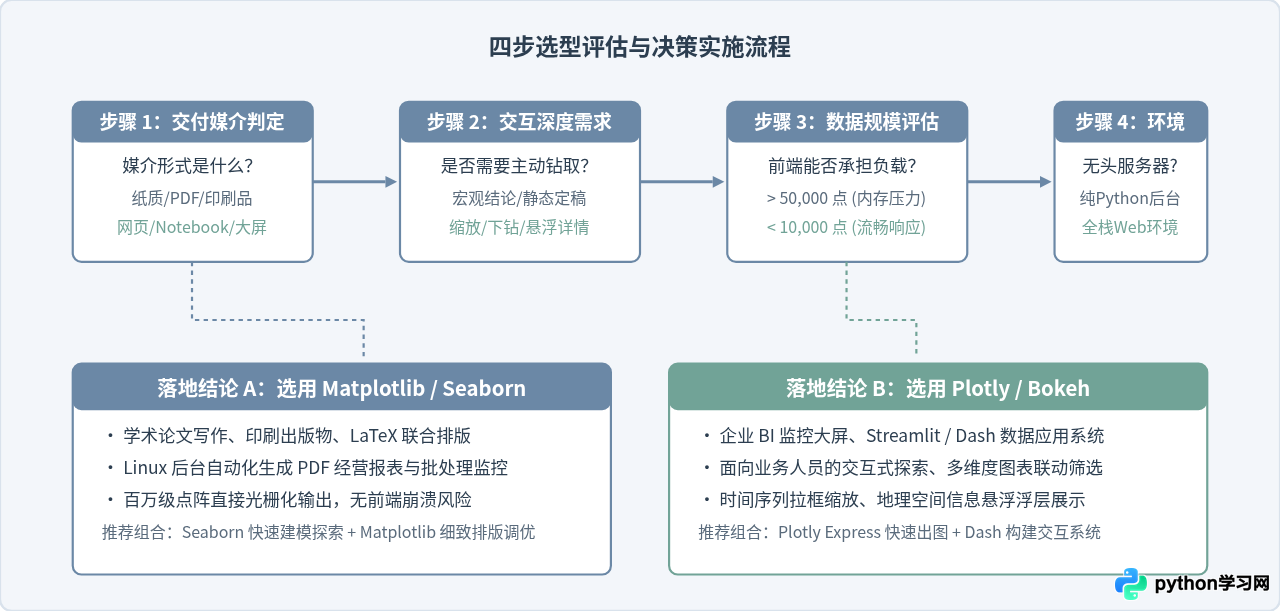
在面对具体项目时,无需机械背诵每个库的优缺点,按照以下四个顺序递进的问题进行评估,即可快速锁定最佳技术选型:
- 第一步:最终交付媒介是什么? 如果产物是 PDF 报告、Word 文档、印刷版期刊或纸质论文,读者无法进行鼠标交互,强制使用交互式库反而需要借助 Kaleido 或 Playwright 等额外工具做二次栅格化,徒增复杂度。此时必须首选静态库。若交付载体为网页端、企业内网监控屏或 Jupyter Notebook 交互分析报告,则交互式库优势显著。
- 第二步:是否需要数据动态探索? 当图表承载的信息密度极高(例如包含数千个散点或密集的股票分时线)时,静态图表很难在一张图内标注全部细节;交互式库的 Tooltip(鼠标悬浮显示详情)与 Box Zoom(区域拉框放大)能显著降低视觉重叠带来的干扰。若仅需展示清晰的整体趋势、比例或宏观对比,静态图表更清晰直接。
- 第三步:单图数据点规模是多少? 交互式库将所有数据点作为 DOM 元素或画布坐标存留在客户端内存中。普通 Plotly 图表在渲染 5 万个以上独立散点时可能导致浏览器出现明显卡顿;而 Matplotlib 在后端直接计算栅格,绘制数十万甚至数百万个点时依然稳定高效。因此超大规模点集的渲染应优先考虑静态库,或搭配 WebGL 与 Datashader 降采样技术。
- 第四步:运维环境是否有外部浏览器驱动依赖? 在 Linux 服务器的后台自动化任务、Docker 容器或定时 CronJob 中批量生成图表时,静态库无需图形界面和外部浏览器环境即可原生运行。而若要求交互式库输出可打印图片,必须在容器内预装无头浏览器及底层字体,运维和构建成本会成倍增加。
三、核心适用场景与典型代码对比
为了直观展现两类工具在具体实现上的逻辑差异,下面分别选取最典型的业务场景进行代码和用法对比。
场景 1:学术出版与高精细度静态版面控制(Matplotlib / Seaborn)
在撰写科研论文或工程技术报告时,通常需要精确控制图表的宽高比、字体大小(与正文字号一致)、线条粗细以及多子图拼贴布局。静态库允许通过面向对象 API 精细调整每个坐标轴元素,并无损导出为矢量 PDF 或 300+ DPI 的高质量栅格图。
import matplotlib.pyplot as plt
import seaborn as sns
import numpy as np

# 1. 统一设定出版级视觉规范与中英文字体回退
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False
plt.rcParams['figure.dpi'] = 300

# 2. 生成模拟实验数据
np.random.seed(42)
epochs = np.arange(1, 21)
loss_a = np.exp(-epochs / 5) + np.random.normal(0, 0.02, size=len(epochs))
loss_b = np.exp(-epochs / 7) + np.random.normal(0, 0.02, size=len(epochs))

# 3. 构建多子图画布,精确控制绝对物理尺寸 (单位: 英寸)
fig, ax = plt.subplots(figsize=(6, 4))
ax.plot(epochs, loss_a, marker='o', markersize=4, color='#6B88A6', label='模型 A (Base)')
ax.plot(epochs, loss_b, marker='s', markersize=4, color='#71A397', label='模型 B (Optimized)')

ax.set_title('训练收敛对比实验 (300 DPI 静态矢量导出)', fontsize=12, pad=10)
ax.set_xlabel('迭代轮次 (Epochs)', fontsize=10)
ax.set_ylabel('交叉熵损失 (Loss)', fontsize=10)
ax.grid(True, linestyle='--', alpha=0.5)
ax.legend(frameon=True, fontsize=9)

# 4. 导出为矢量 PDF,用于 LaTeX 排版或印刷
plt.tight_layout()
plt.savefig('model_convergence.pdf', format='pdf', bbox_inches='tight')
plt.close(fig)
场景 2:数据探索与 Web 交付交互图表(Plotly Express)
在面对多维业务数据时,分析师往往需要快速观察不同维度的分布情况,并通过鼠标悬浮获取具体样本编号与数值指标。Plotly Express 提供了简练的高级封装接口,一行代码即可实现包含悬浮窗、图例显隐切换和区域缩放功能的交互式 HTML 页面。
import plotly.express as px
import pandas as pd

# 1. 构建多维业务数据集
df = pd.DataFrame({
    '服务节点': ['Node-A1', 'Node-A2', 'Node-B1', 'Node-B2', 'Node-C1', 'Node-C2'],
    'CPU利用率(%)': [45.2, 78.6, 32.1, 89.4, 55.0, 68.3],
    '内存占用(GB)': [12.4, 30.2, 8.5, 48.0, 16.2, 24.5],
    '集群分组': ['集群东区', '集群东区', '集群南区', '集群南区', '集群西区', '集群西区'],
    '请求延迟(ms)': [12, 45, 8, 82, 18, 30]
})

# 2. 一行构建气泡散点图,映射颜色、大小及悬浮提示信息
fig = px.scatter(
    df,
    x='CPU利用率(%)',
    y='内存占用(GB)',
    size='请求延迟(ms)',
    color='集群分组',
    hover_name='服务节点',
    title='节点负载多维交互监控视图',
    color_discrete_sequence=['#6B88A6', '#71A397', '#E29578']
)

# 3. 优化交互配置与响应式布局
fig.update_layout(
    font_family='PingFang SC, Microsoft YaHei, sans-serif',
    template='plotly_white',
    hovermode='closest'
)

# 4. 直接输出为独立交互式 HTML 文件,可嵌入网站或内网仪表盘
fig.write_html('node_metrics.html', include_plotlyjs='cdn')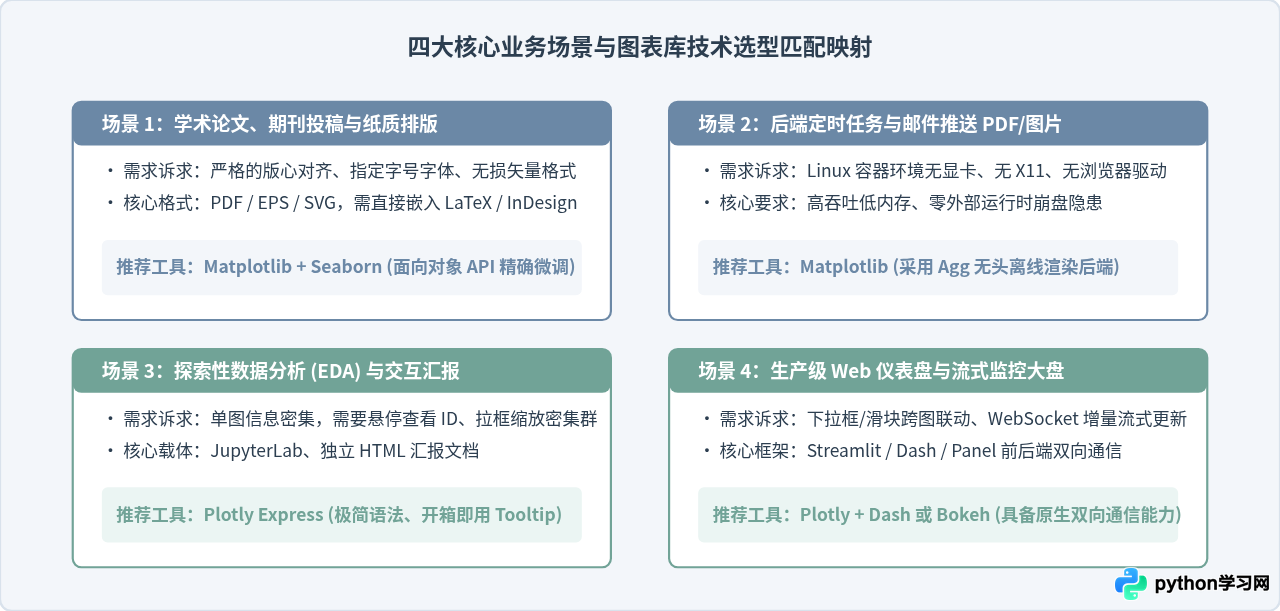
四、工程实践中的选型常见陷阱与规避建议
- 陷阱一:用交互式库生成包含数十万散点的全量图表导致前端崩溃。 由于每个数据点都可能被解析为 SVG DOM 节点或庞大的内存数组,数万点以上会导致浏览器滚屏停滞。针对超海量点集,如果必须交互,应使用
plotly.graph_objects.Scattergl(启用 WebGL 硬件加速)或引入Datashader在服务端进行像素聚合下采样后,再传递给前端展示。 - 陷阱二:在无头 Docker 镜像中因为导出静态图而导致部署体积暴增。 若使用 Plotly 生成报告但又需要导出为 PDF,必须安装
kaleido依赖包。在部分 Linux 发行版中,可能会触发 Chromium 等无头浏览器的复杂系统级依赖。如果项目仅需要静态输出,从一开始就使用 Matplotlib 可以保持极小的镜像体积和极低的部署复杂度。 - 陷阱三:混用面向对象 API 与全局状态机接口导致样式混乱。 在 Matplotlib 维护中,尽量坚持使用
fig, ax = plt.subplots()面向对象接口,避免大量使用plt.title()、plt.plot()等隐式状态接口。在多子图或并发绘图脚本中,隐式全局状态容易出现图层串画和内存泄露。每次画完记得显式执行plt.close(fig)释放内存。
五、综合选型对照与实施总结
为了便于在技术评审或项目启动时迅速达成共识,下表与总结矩阵归纳了各主流库在核心维度的能力表现与最终推荐决策:
| 对比维度 | Matplotlib | Seaborn | Plotly | Bokeh |
|---|---|---|---|---|
| 图表属性 | 静态位图 / 矢量图 | 静态位图 / 矢量图 | 交互式 Web 图表 | 交互式 Web 图表 |
| 上手门槛 | 中等(底层细节繁琐) | 较低(高级统计封装) | 极低(Express API 极简) | 中等(需理解模型与文档结构) |
| 交互能力 | 弱(仅本地 GUI 简易缩放) | 弱(无原生交互) | 极强(缩放/筛选/悬浮/联动) | 极强(支持高级自定义 JS 回调) |
| 排版定制自由度 | 极高(像素/毫米级微调) | 高(基于 Matplotlib) | 中等(受制于 Web 布局容器) | 高(支持布局容器与联动网格) |
| 大体量数据支持 | 极强(百万级光栅化无压力) | 良好(适合统计抽样) | 中等(普通模式易卡顿,需 WebGL) | 良好(支持服务端下采样渲染) |
| 静态导出便捷度 | 原生支持(PDF/PNG/EPS) | 原生支持(PDF/PNG/EPS) | 需附加依赖(Kaleido/Playwright) | 需附加依赖(Selenium/ChromeDriver) |
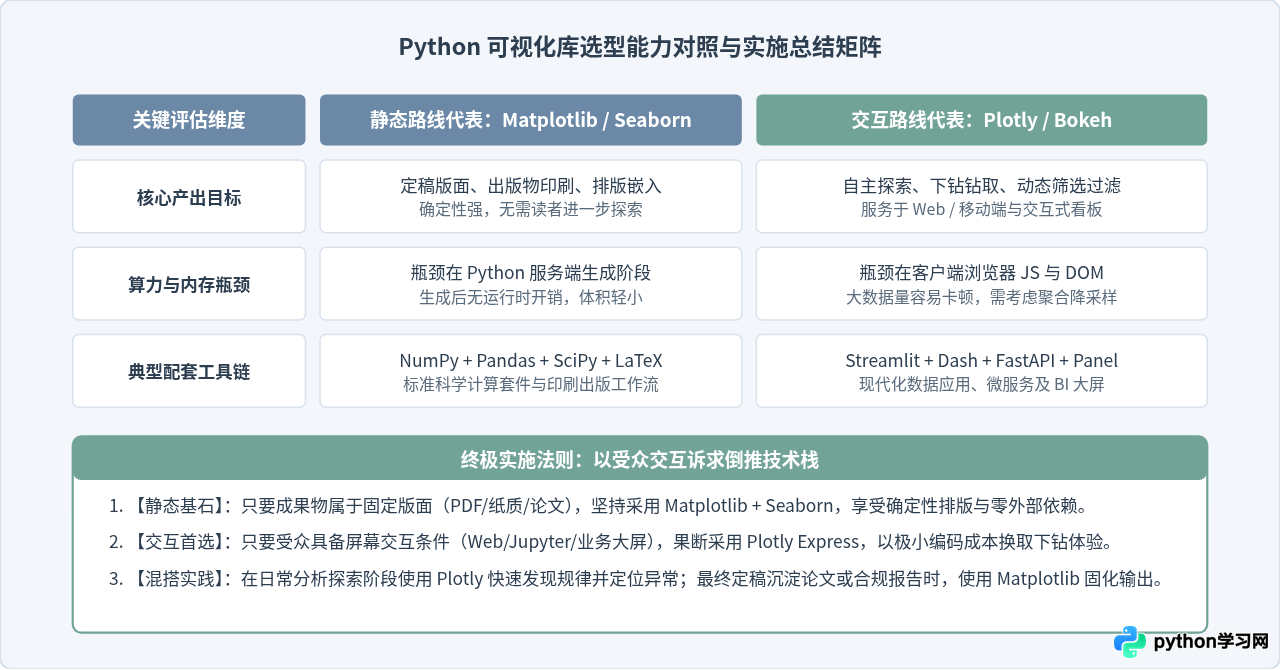
综上所述,Python 可视化生态并非“新库淘汰旧库”的单向更替,而是静态图元与交互式对象两套生产体系的优势互补。厘清最终交付媒介、读者探索需求、数据量级以及运行环境依赖,便能精准选择最契合项目目标的工具组合。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









