

适合新手阅读源码的Python开源项目网站有哪些
适合新手阅读源码的Python开源项目网站盘点与使用指南。从中文精选社区、精选仓库索引到标准库拆解站点,详解新手挑选与调试Python项目源码的具体步骤与避坑方法。
阅读优秀源码是提升 Python 编程思维与工程能力的高效路径,但初学者常因误入动辄数万行的大型工程而受挫。寻找源码的第一步不是盲目搜索,而是借助具备“分级筛选”、“中文导读”与“轻量标定”的开源索引平台。本文整理了四类适合新手获取 Python 源码的专业网站,并详细说明挑选适配项目与本地调试阅读的具体方法。
一、四类适合新手发现优质源码的平台
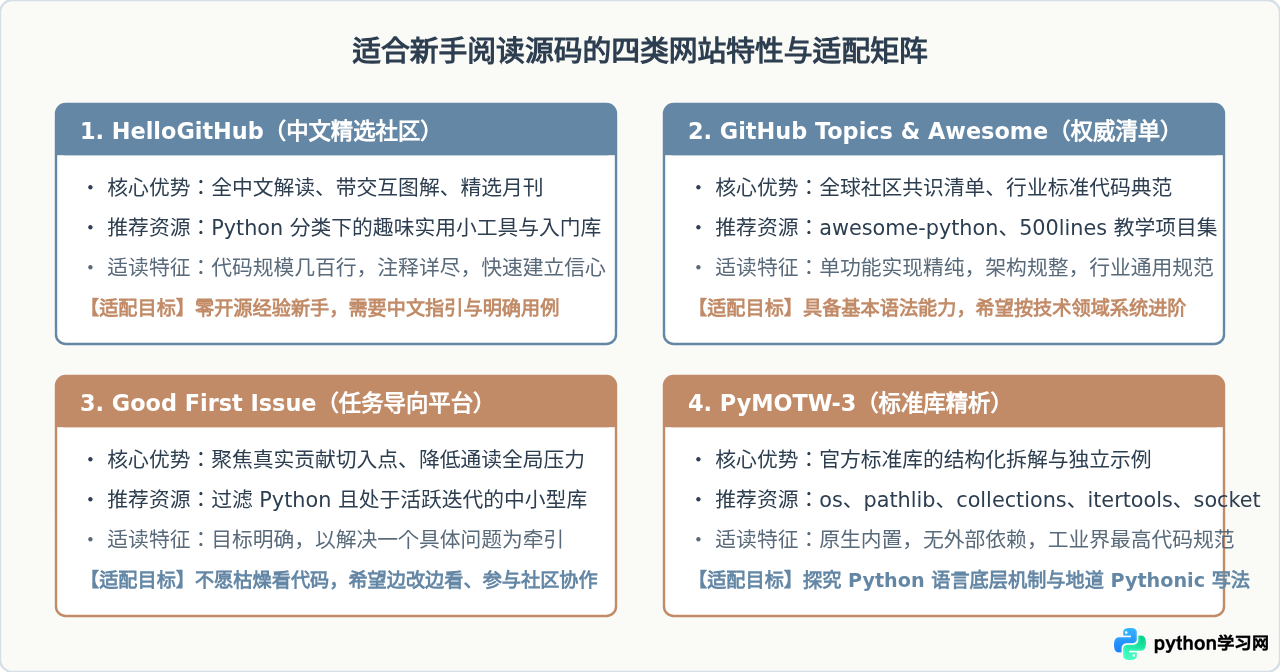
不同平台在项目呈现方式、技术深度和受众定位上各有侧重。初学者需要根据当前的学习目标,选择对应侧重点的平台:
1. HelloGitHub:中文开源新手导航平台
HelloGitHub 是专注于降低开源项目阅读门槛的中文社区,每月发布精选月刊。其最大特点在于每一期推荐的 Python 项目都附带清晰的中文背景说明、核心代码亮点和运行效果演示。
- 核心优势:筛选严格,排除了大量缺乏维护或文档缺失的项目;界面与解析全中文呈现,消除语言壁垒。
- 使用方法:直接访问网站的分类专栏,选择“Python”分类,或通过“入门级”、“实用工具”等标签筛选几百行左右的微型项目。
2. GitHub 专题列表:权威策划的主题合集
直接在 GitHub 搜索框键入关键词往往会得到海量工业级库,对于新手并不友好。更高效的方式是利用经过全球开发者持续维护的精选仓库(Curated Lists)和专题(Topics):
- Awesome Python:GitHub 上星标极高的高质量项目清单。它按 Web 框架、网络爬虫、数据处理等技术领域细分,每个门类下列出的都是社区公认的代码结构典范。
- 500 Lines or Less(AOSA 项目):由资深架构师联合编写的开源教学项目。每位作者使用不超过 500 行的纯 Python 代码实现一个完整的核心功能(如简单的 Web 服务器、模板引擎、ORM 框架或爬虫),并附带逐行设计思路说明。
- GitHub Topics(#good-first-issue / #beginner-friendly):直接定位带有新手友好标记的活跃仓库。
3. Good First Issue 与 Up For Grabs:任务驱动型开源网站
这两个网站是专门汇聚“适合新手修复的小 Issue”的聚合平台。如果你觉得泛读整个项目无从下手,带着具体的小 Bug 或文档改进任务切入是最高效的读代码方式。
- 核心优势:在网站上筛选语言为 Python,能直接列出各大开源仓库中被维护者贴上
good first issue标签的具体问题。 - 适用场景:通过阅读 Issue 描述,逆向追溯该模块对应的源码文件与测试文件,在局部改动中体会全局代码协作规范。
4. PyMOTW-3(Python 3 模块每周解析):标准库的源码导读站
Python 最规范、最经得起考验的源码就在其自带的 Standard Library(标准库)中。PyMOTW-3(Python 3 Module of the Week)虽为教程站,实则是阅读官方标准库的最佳伴侣。
- 核心优势:按模块拆解 Python 标准库(如
collections、itertools、contextlib等),提供大量简洁自洽的调用示例,代码纯度高且规范。 - 使用方法:在 PyMOTW 看到感兴趣的模块设计后,直接在本地 Python 安装目录的
Lib/文件夹中打开对应的.py源码对照精读。
二、挑选适合新手阅读的源码:三项硬性过滤标准
即便找到了上述网站,也不要随意打开一个热门仓库就读。大型工业级开源库(例如 Django、Pandas、Celery)经过多年迭代,充满了兼容旧版本、跨平台处理与深层抽象代码,极易阻断初学者的阅读节奏。初学者挑选项目应严格通过以下三道过滤指标:
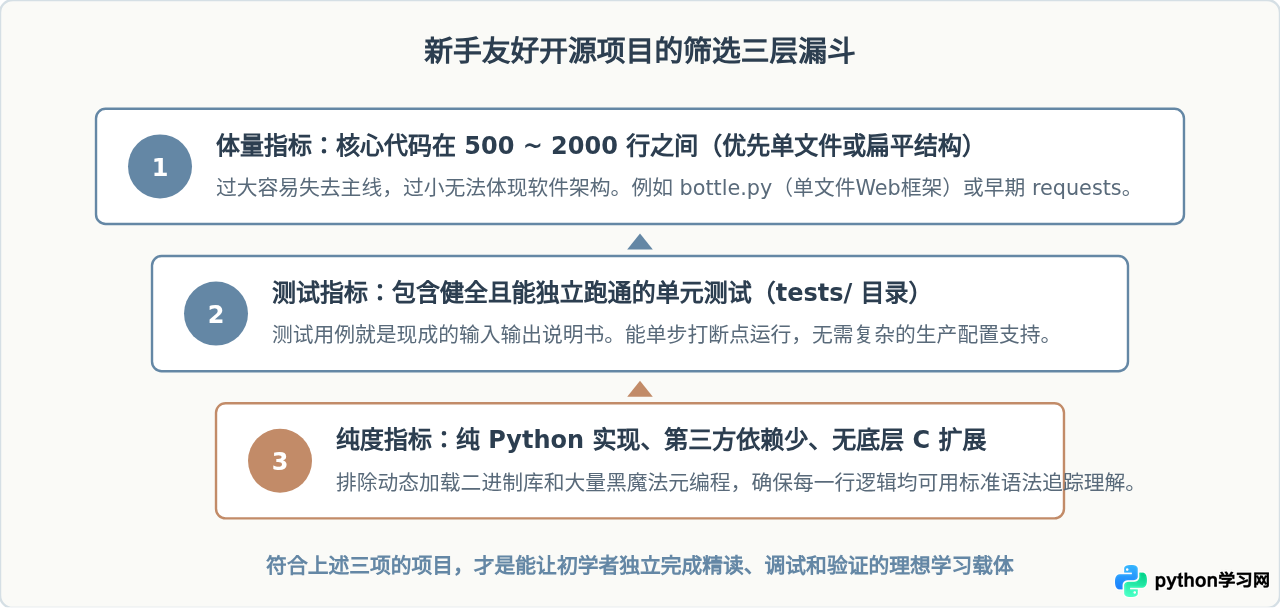
1. bottle.py:微型 Web 框架,整个框架仅包含一个 bottle.py 文件(约 4000 余行,核心路由与请求仅千余行),将路由分发、模板渲染、Cookie 与插件机制全盘交代清楚,无任何外部强制依赖。
2. markdown-it-py 或简易解析器:纯 Python 语法解析范例,适合学习词法分析与字符串状态机处理。
3. click:命令行解析利器,结构规范,是学习 Python 装饰器与上下文传递的教科书级代码。
三、从网站选定项目到本地阅读的完整步骤
阅读源码最忌讳“在网页上直接从第一个文件自上而下干瞪眼”。一个科学的阅读过程应像逆向工程一样,将其运行起来并单步跟踪。完整操作流程分为以下四步:
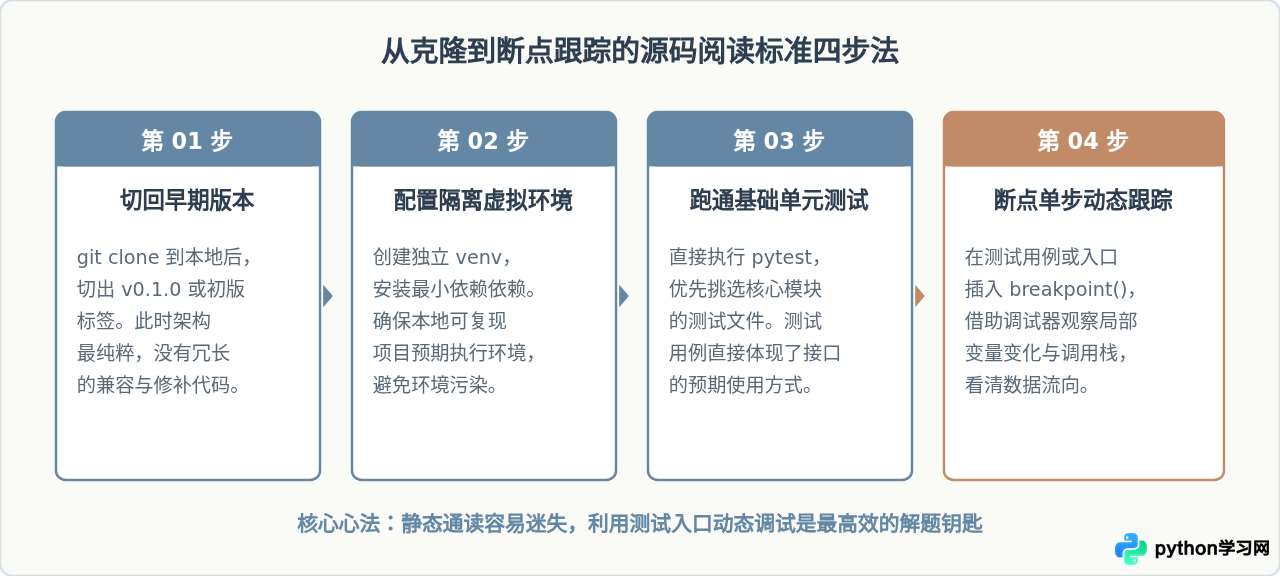
步骤 1:检出仓库的早期版本(v0.1.0 或 Initial Commit)
以 Python 著名开源项目 requests 为例,当前最新版本包含大量安全策略、连接池重试和多平台兼容代码,阅读压力大。但如果切换到最初发布的 v0.1.1 版本,整个核心实现其实仅一个文件、几百行代码,能让人瞬间看清其对 urllib2 的优雅封装理念。
# 1. 克隆代码仓库
git clone https://github.com/psf/requests.git
cd requests

# 2. 列出历史标签并切换到最初的轻量发布版
git tag -l "v0.1*"
git checkout v0.1.1
步骤 2:创建独立虚拟环境并配置依赖
切忌在系统的全局 Python 环境中直接安装项目依赖。创建专用虚拟环境能够保证环境干净,且方便随时推倒重来。
# 创建虚拟环境并激活
python3 -m venv .venv
source .venv/bin/activate  # Windows 环境使用: .venv\Scripts\activate

# 安装测试依赖
pip install pytest
步骤 3:直接定位并运行测试用例
项目自带的 tests/ 目录是作者写给使用者的“最权威行为说明书”。不要从头读起,先挑一个最简单的基础测试文件执行:
# 单独运行某一个测试用例文件
pytest tests/test_basic.py -v
看到测试全部通过后,打开 test_basic.py。测试代码通常遵循 “准备输入数据 → 调用目标类或函数 → 断言返回值 (assert)” 的简单逻辑。读懂测试用例,你就已经理解了该函数设计的核心输入输出契约。
步骤 4:插入断点进行单步执行
在测试用例调用项目函数的那一行,直接写上 Python 内置的 breakpoint()。再次运行测试时,程序会自动挂起并进入交互式调试界面:
def test_simple_request():
    url = "https://httpbin.org/get"
    # 在关键调用前打断点
    breakpoint()
    response = requests.get(url)
    assert response.status_code == 200
进入 PDB 调试终端后,输入 s(Step Into 进入函数内部),即可一步一步跟着代码走进库函数的第一行。随时输入 p 变量名 查看变量的实际形态,输入 w(Where)查看调用栈层级。这种“看得见数据流动”的动态阅读方式,比枯燥的代码速读要直观清晰得多。
四、初学者读源码的三大常见误区与避坑策略
阅读源码过程中极容易遇到挫败感,这往往并非个人基础不足,而是触碰了以下误区:
- 误区一:按文件字母顺序从头通读。
应对:开源项目的目录结构是为工程组织设立的,不是为教学顺序设计的。必须始终从“入口点”出发(如 CLI 程序的main.py、Web 库的处理句柄、或是测试用例),顺着主干调用链向下追踪,不要强行按目录挨个文件看。 - 误区二:深究冷门语法糖与复杂元编程。
应对:遇到看不懂的类装饰器、元类(metaclass)或底层黑魔法函数时,先弄清楚该装饰器的“最终功能”(例如:用于注册路由或捕获异常),将实现过程暂时作为黑盒跳过,待主干流程清晰后再回来复盘细节。 - 误区三:只看代码,忽略 Commit 记录与 PR 讨论。
应对:优秀的开源项目其代码价值不仅在于当前代码,更在于“为什么改写成这样”。遇到令人费解的防御性代码时,使用git log -S "函数名"或通过 GitHub 界面上的Blame功能查看当年的 Commit 记录与 Pull Request 讨论,往往能看到作者面临具体 Bug 时的完整思考过程。
五、阶段进阶学习路径总结
源码阅读是一项循序渐进的工程训练,从微型工具到工业级架构,合理规划进阶路线能让你步步有收获:
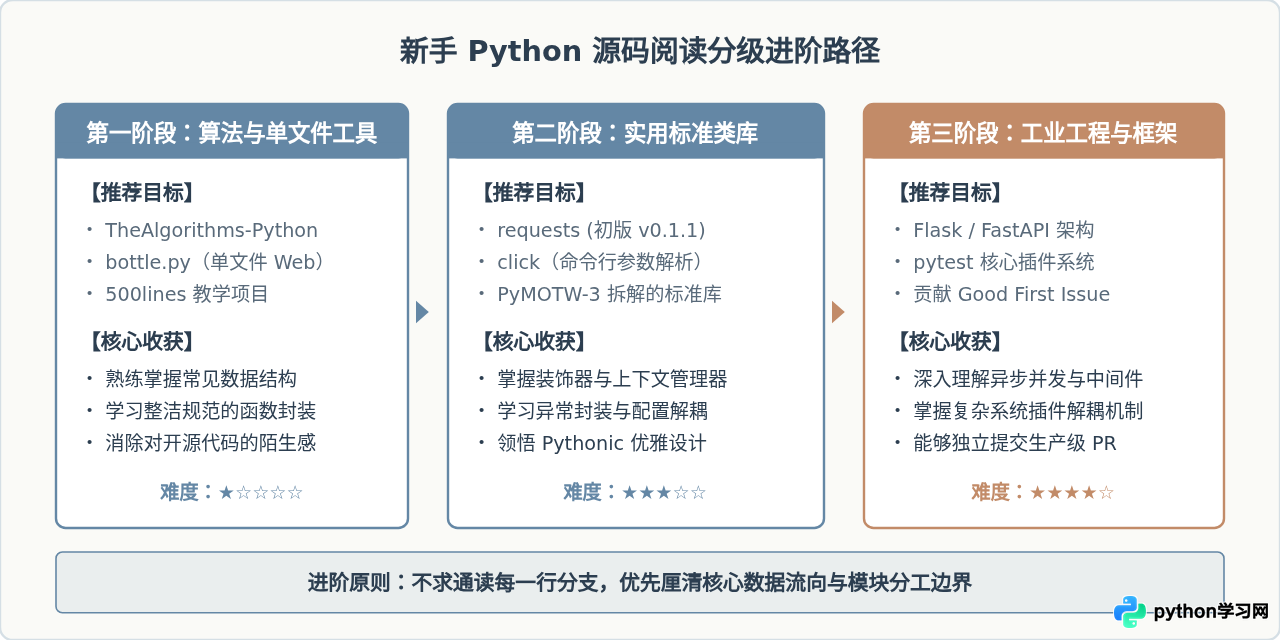
阅读源码的终极目标不是背诵别人的代码,而是理解优秀作者在面对复杂问题时的抽象与折中取舍。通过 HelloGitHub、精选清单与任务聚合网站找到体量适中的标的,配合检出早期版本和单步断点调试的方法,初学者也能从看似庞大的开源世界中自如穿行、稳步进阶。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









