

怎么根据场景选择Python绘图库:静态报告、Web交互与大数据渲染
深入解析如何根据静态报告、Web交互与大数据渲染三大核心场景选择合适的Python绘图库,对比Matplotlib、Seaborn、Plotly、Bokeh及Datashader的底层架构、性能边界与实战选型路径。
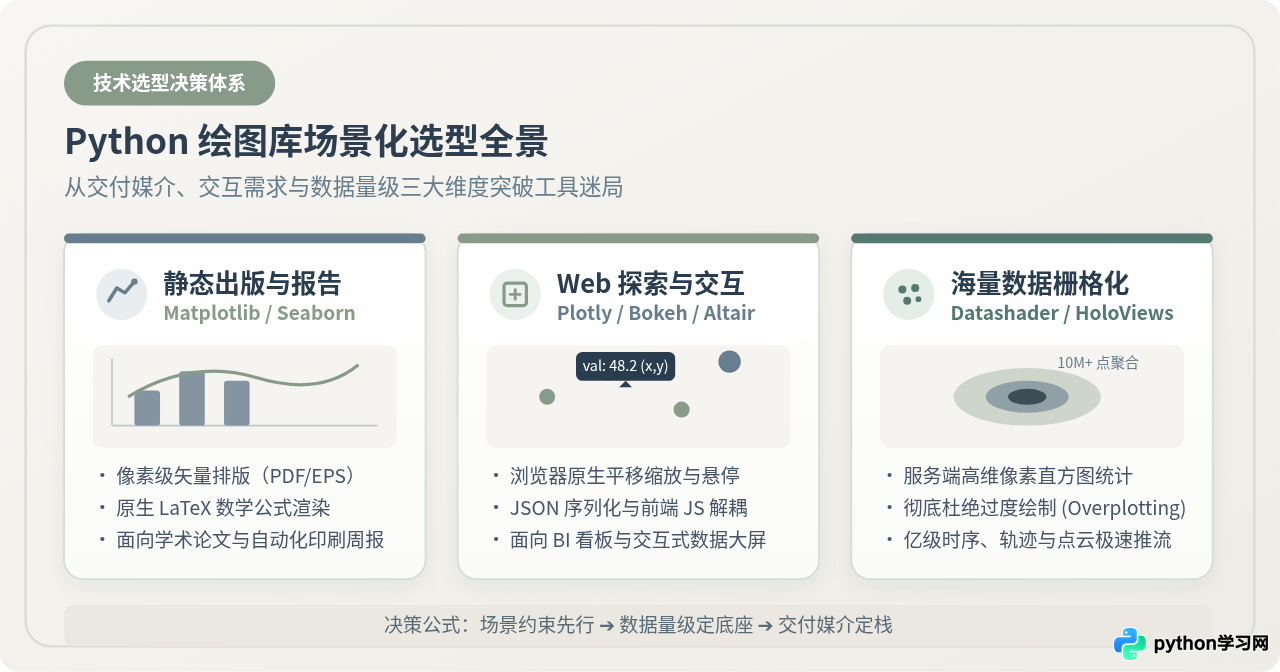
选择 Python 绘图库的核心依据不是哪个库功能最新,而是交付媒介、交互需求和数据量级这三个硬性约束。静态学术报告与印刷交付首选 Matplotlib 和 Seaborn,因其拥有最精细的像素级矢量控制与排版稳定性;需要嵌入网页仪表盘、提供悬停和缩放体验的场景首选 Plotly 或 Bokeh,它们通过前端 JavaScript 引擎在浏览器中实现富交互;当数据量突破数十万、达到千万级甚至亿级点阵时,传统库会导致浏览器崩溃或渲染阻塞,必须选用以 Datashader 为核心的服务器端像素聚合方案。根据这三条主线匹配技术栈,可以避免中后期被迫重构可视化架构。
一、选型核心三要素:交付媒介、交互深度与数据规模
很多开发者在启动数据可视化项目时容易陷入一个误区:试图寻找一个“既能生成高清学术论文矢量图,又能直接放入网页点击筛选,还能流畅拖拽几百万行数据”的万能库。事实上,在现有的 Python 图形生态中,这种全能工具并不存在。每个工具在诞生之初,其底层架构所权衡的目标就截然不同。
为了在项目初期做出准确判断,需要依次厘清以下三个决定性条件:
- 交付媒介(Where to Deliver):图表最终是呈现在 PDF/Word 文档、印刷纸质刊物中,还是运行在现代浏览器、独立前端系统或 BI 大屏中?
- 交互深度(How to Interact):读者是仅需阅读固定结论,还是需要通过鼠标悬停(Hover)、区域框选(Box Select)、时间轴缩放(Zoom)以及多图联动来探索未知分布?
- 数据规模(How Much Data):参与单次渲染的数据点规模是多少?是数千条特征均值、数万条日志散点,还是突破百万级乃至上亿级的传感器时序与地理轨迹?
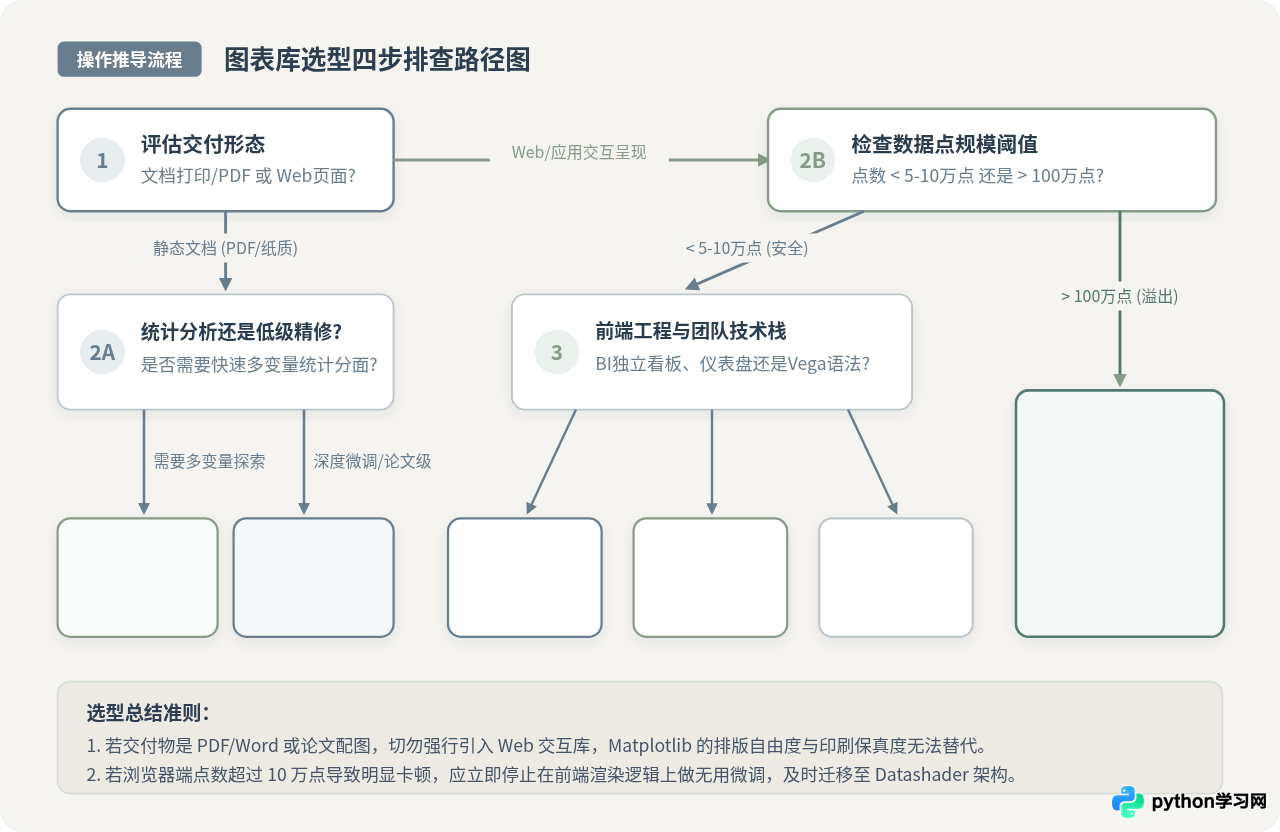
明确上述三个约束后,技术选型路径将变得非常清晰:交付媒介直接划定了是走“静态后端渲染”还是“前端 JavaScript 桥接”;而数据点数则构成了是否需要“服务端动态降采样/栅格化”的物理红线。
二、场景一:静态打印、学术论文与自动化PDF报告
在学术论文投稿、企业纸质印刷品、定期批处理生成的 PDF 运营周报中,对图表的核心要求是排版严格对齐、导出格式无损、排版要素绝对可控。
1. 为什么 Matplotlib 和 Seaborn 无法被取代
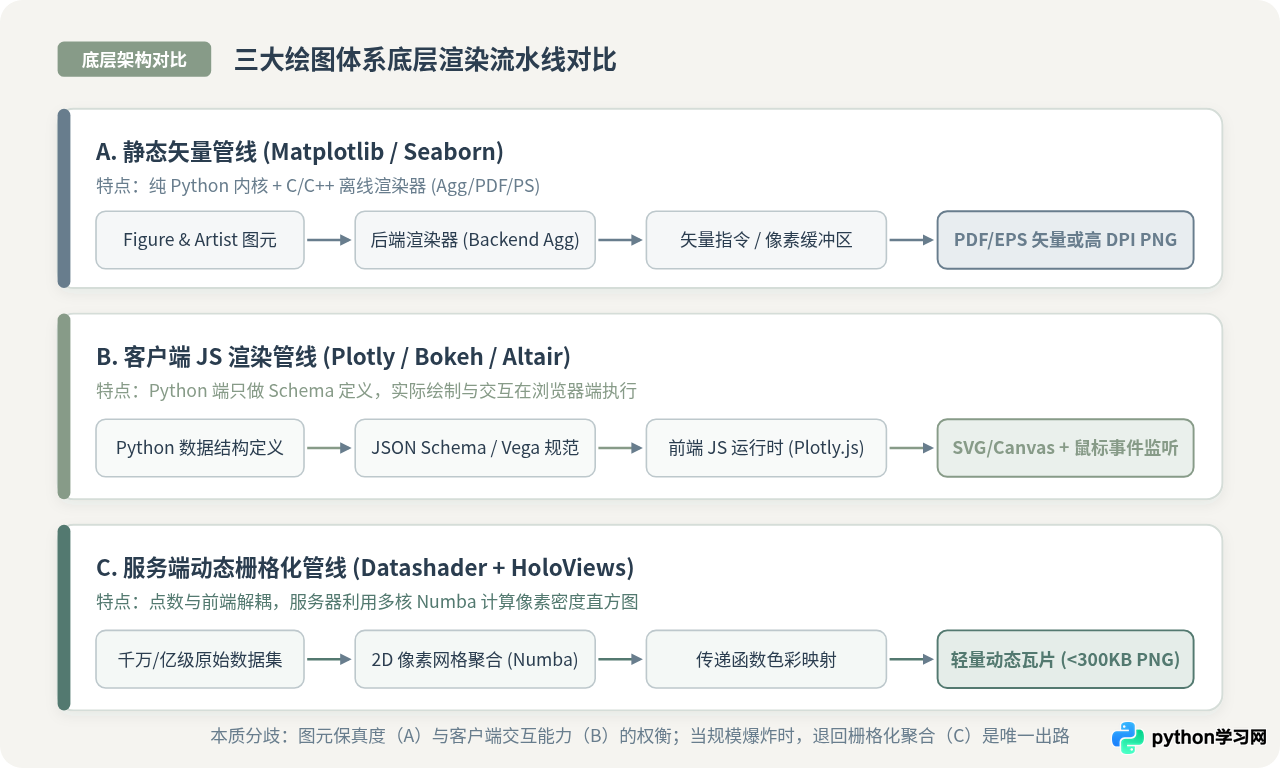
Matplotlib 拥有分层的对象模型架构(Figure、Axes、Axis、Artist),并搭配了成熟的非交互式底层渲染后端(例如 Agg、PDF、PS、SVG)。这意味着它具有以下不可替代的特性:
- 出版级矢量输出:可原生导出包含嵌入字体的矢量 PDF 与 EPS 格式,放大千倍依然边缘锋利,满足期刊对 300 到 600 DPI 的严格要求;
- 原生 LaTeX 公式渲染:原生集成数学公式排版引擎,支持希腊字母、上下标及复杂微分矩阵;
- 多子图毫米级精修:可以通过
GridSpec随意指定子图边界比例、边距跨度、轴脊(Spines)显隐及双 Y 轴刻度对齐。
而 Seaborn 则是构建在 Matplotlib 之上的高阶统计接口。它封装了常用统计模型的置信区间拟合、分类变量分面网格(FacetGrid)以及协调典雅的色彩调色板。在探索性统计与多变量对比场景中,Seaborn 能用一行代码完成 Matplotlib 需要数十行配置的任务,同时底层依然保留完整的 Matplotlib 对象,允许随时进行底层微调。
2. 出版级静态图表实战范例
以下代码展示了如何使用 Matplotlib 构造具备双轴度量、规范化排版与高精度导出的出版级图表配置:
# -*- coding: utf-8 -*-
import matplotlib.pyplot as plt
import numpy as np

# 1. 统一全局学术排版样式
plt.rcParams['font.sans-serif'] = ['DejaVu Sans', 'PingFang SC', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False
plt.rcParams['mathtext.fontset'] = 'cm'

# 构造数据
np.random.seed(42)
months = np.arange(1, 13)
revenue = np.array([21.5, 23.8, 28.2, 34.1, 42.0, 50.3, 58.7, 62.1, 59.4, 51.2, 44.0, 39.5])
margin = np.array([18.2, 18.5, 20.1, 22.4, 25.0, 27.8, 30.2, 31.0, 29.5, 26.1, 23.0, 20.8])

# 2. 面向对象模式初始化画布
fig, ax1 = plt.subplots(figsize=(8, 4.5), dpi=150)

# 绘制主轴柱状图
bars = ax1.bar(months - 0.15, revenue, width=0.3, color='#687D8D', label='营业收入 ($M)')
ax1.set_xlabel('月份 (Month)', fontsize=11, labelpad=8)
ax1.set_ylabel('营业收入 (百万美元)', color='#687D8D', fontsize=11)
ax1.tick_params(axis='y', labelcolor='#687D8D')
ax1.set_xticks(months)
ax1.grid(axis='y', linestyle='--', alpha=0.4)

# 3. 构造共享 X 轴的双坐标轴
ax2 = ax1.twinx()
line = ax2.plot(months + 0.15, margin, color='#879B88', marker='o', linewidth=2.2, label='毛利率 (%)')
ax2.set_ylabel('毛利率 (%)', color='#52796F', fontsize=11)
ax2.tick_params(axis='y', labelcolor='#52796F')
ax2.set_ylim(10, 40)

# 合并图例并放置于左上角
lines1, labels1 = ax1.get_legend_handles_labels()
lines2, labels2 = ax2.get_legend_handles_labels()
ax1.legend(lines1 + lines2, labels1 + labels2, loc='upper left', frameon=True, framealpha=0.9)

plt.title('季度财务运行走势双指标对比 (出版排版标准)', fontsize=13, pad=12, fontweight='bold')
fig.tight_layout()

# 导出为高保真 PDF 矢量文件及 300 DPI 印刷图
plt.savefig('report_figure.pdf', format='pdf', bbox_inches='tight')
plt.savefig('report_figure.png', dpi=300, bbox_inches='tight')
plt.close(fig)
使用提醒
当用于后台定时任务或多线程无界面服务器(Headless Server)时,务必在导入 pyplot 前设置 matplotlib.use('Agg'),避免因缺少 X11/GUI 窗口系统而抛出 TclError 异常。
三、场景二:Web 仪表盘、前端集成与探索性交互分析
当交付环境转移至 Web 端、云端 JupyterLab 或面向业务团队的交互式看板(Dashboard)时,静态图片的局限性就会暴露无遗——用户无法点击图例隐藏类别、无法查看具体点的数据明细,也无法通过缩放排查局部的异常波动。
1. 交互库运作机理:Plotly 与 Bokeh 的差异
现代 Web 绘图库的核心本质并非直接生成像素,而是将 Python 对象序列化为规范化的 JSON 数据结构,随后交由前端 JavaScript 引擎在浏览器中动态挂载。
- Plotly(基于 Plotly.js / D3.js / WebGL):目前工业级 Web 交互的首选。高阶接口
plotly.express具有极佳的表达力,能像 Seaborn 一样自动识别 Pandas DataFrame 字段;生成的图表自带工具栏(下载、缩放、套索、十字准星);配合 Dash 框架可快速搭建企业级全栈应用。 - Bokeh(基于 BokehJS):更侧重于深度定制的 Python/JS 双向通信。Bokeh 允许直接在 Python 服务端维护图表数据源(
ColumnDataSource),通过 WebSocket 进行高效的流式局部更新,适合长周期运行的工业监控面板。 - Altair(基于 Vega-Lite 规范):采用严格的图形语法声明式规范。代码语法极其优雅严谨,多图联动筛选体验极佳;但在默认情况下对数据量设有 5000 行的内置上限限制,避免庞大的 JSON 直接阻塞前端。
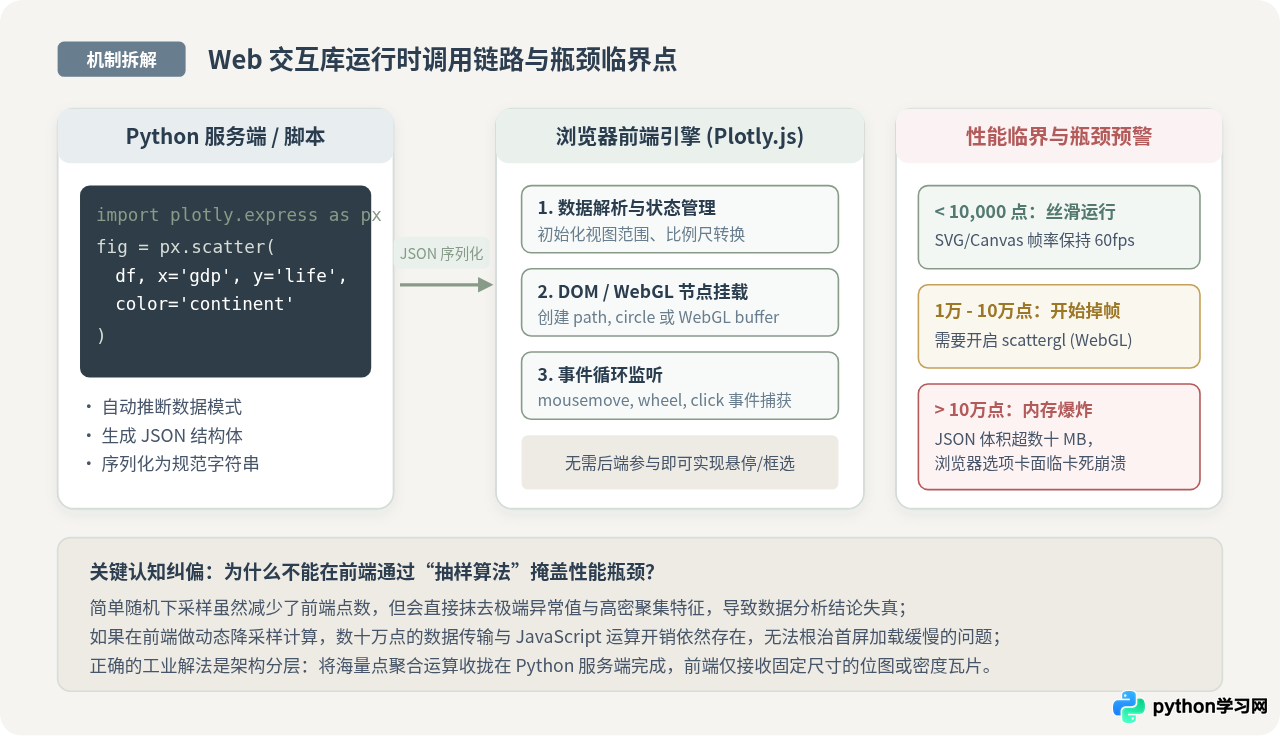
2. 为什么浏览器端会发生卡顿?
浏览器环境的运行资源是有限的。以 Plotly 的 SVG 模式散点图为例,若数据集中包含 50,000 个点,前端将创建 50,000 个独立的 SVG <circle> DOM 节点。当用户移动鼠标触发重排(Reflow)或重绘(Repaint)时,CPU 占用率会瞬间拉满,导致明显的掉帧与卡顿。
针对 1 万至 10 万点规模的交互需求,Plotly 提供了基于 WebGL 硬件加速的 scattergl 替代传统 SVG 模式,能有效降低 DOM 压力;但一旦数据突破数十万级别,庞大的 JSON 传输体积与浏览器堆内存占用仍会导致前端崩溃。
3. Plotly 交互式图表范例
以下代码展示了如何使用 Plotly Express 构造一个包含分类着色、数据悬停提示和范围选择器的交互式组件:
# -*- coding: utf-8 -*-
import plotly.express as px
import pandas as pd
import numpy as np

# 构造模拟的多维指标数据
np.random.seed(42)
n_samples = 1200
df = pd.DataFrame({
    '研发投入_万': np.random.exponential(scale=50, size=n_samples) + 10,
    '产出效益_万': np.random.normal(loc=120, scale=35, size=n_samples),
    '团队规模': np.random.randint(5, 80, size=n_samples),
    '业务板块': np.random.choice(['基础架构', '算法工程', '端智能', '运维保障'], size=n_samples)
})
df['产出效益_万'] += df['研发投入_万'] * 1.8

# 生成交互式散点图
fig = px.scatter(
    df,
    x='研发投入_万',
    y='产出效益_万',
    color='业务板块',
    size='团队规模',
    hover_data=['团队规模'],
    opacity=0.75,
    color_discrete_sequence=['#687D8D', '#879B88', '#52796F', '#C49F45'],
    title='业务线研发投入与产出效益分布探索 (交互式)'
)

# 定制前端布局与控制器
fig.update_layout(
    font_family='"PingFang SC", "Microsoft YaHei", sans-serif',
    plot_bgcolor='#FAFAF7',
    paper_bgcolor='#FFFFFF',
    legend=dict(orientation="h", yanchor="bottom", y=1.02, xanchor="right", x=1),
    margin=dict(l=40, r=40, t=60, b=40)
)

# 导出为自包含、无外部依赖的独立 HTML 报告
fig.write_html('interactive_report.html', include_plotlyjs='cdn')
四、场景三:千万级至亿级数据点的极端渲染
当进入传感器时序高频监测、海量卫星遥感遥测、全量网约车轨迹或高维嵌入向量(如 t-SNE / UMAP 投射)等场景时,数据点数量往往会从数十万直接飙升到 1000 万甚至 1 亿以上。
1. 过度绘制(Overplotting)灾难与计算失控
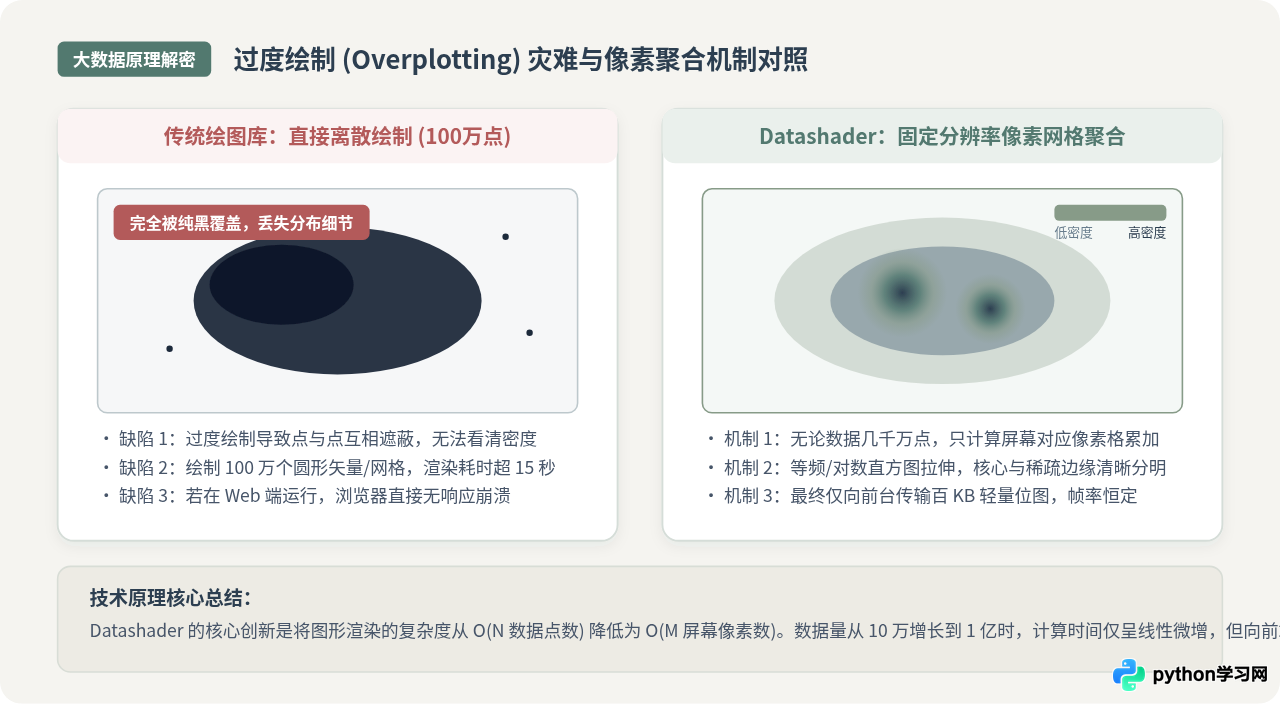
面对千万级数据,传统图表库不仅会直接导致浏览器崩溃,即使在 Matplotlib 等离线矢量库中强制渲染,也会陷入过度绘制(Overplotting)的科学陷阱:成千上万个散点重叠堆积在相同的像素区域内,形成一团漆黑且毫无分辨度的色块。真实的高密度核心被完全遮掩,孤立的噪点反而抢夺了视觉焦点,使数据呈现丧失分析价值。
2. Datashader 的革命性设计:服务端像素网格聚合
针对这一瓶颈,Anaconda 团队主导开源的 Datashader 改变了渲染哲学:它绝不把每一个原始数据点直接转化为图形图元,而是在服务端将其视作高维密度场的重采样过程。
Datashader 的具体计算步骤包含以下三步:
- 网格投影(Projection & Binning):根据用户当前的显示窗口尺寸(如 1000 × 600 像素),在服务器内存中建立对应分辨率的二维直方图网格。利用多核并行与 Numba 编译加速,瞬间将千万个点累加分配至对应的网格格子里;
- 密度变换(Transfer Function):应用非线性(如对数对齐或直方图均衡化)变换,防止极高密度中心把周围的中低密度形态掩盖;
- 动态着色生成位图(Colormapping & Rasterization):将像素矩阵着色为一张几十至几百 KB 的静态 PNG 图片,再实时传回前端显示。
通过这种机制,整个渲染管线的计算复杂度从依赖数据量 $O(N)$ 降维到了依赖屏幕像素数 $O(M)$。不论底层数据是一千万点还是一亿点,前端交互的帧率和内存消耗都保持绝对恒定。结合 HoloViews 与 Bokeh,用户依然能够像操作小数据集一样进行流畅的地图缩放与平移。
3. Datashader + HoloViews 管道范例
以下代码展示了如何使用 Datashader 管道高效渲染 1000 万级规模的连续轨迹与密集散点:
# -*- coding: utf-8 -*-
import datashader as ds
import datashader.transfer_functions as tf
import holoviews as hv
from holoviews.operation.datashader import datashade, rasterize
import numpy as np
import pandas as pd

# 初始化 HoloViews 的 Bokeh 后端
hv.extension('bokeh')

# 构造模拟的 5,000,000 个高维轨迹点
np.random.seed(0)
n_points = 5_000_000
x = np.random.normal(loc=0, scale=1.0, size=n_points).cumsum()
y = np.random.normal(loc=0, scale=1.0, size=n_points).cumsum()
df = pd.DataFrame({'x': x, 'y': y})

# 1. 使用 HoloViews 声明式包裹点集对象
points = hv.Points(df, kdims=['x', 'y'])

# 2. 接入 Datashader 动态栅格化管道
# 无论用户在前端怎么放大缩小,Datashader 都会在服务端毫秒级重新计算当前视野内的像素网格
interactive_plot = datashade(
    points,
    cmap=['#F5F4F0', '#879B88', '#687D8D', '#2C3E50']
).opts(
    width=800,
    height=450,
    title='500万级高频时序与空间轨迹密度图 (Datashader 动态流)'
)

# 保存为带有服务端双向重采样机制的交互式网页应用
hv.save(interactive_plot, 'massive_data_view.html')
五、综合选型速查与混合架构方案
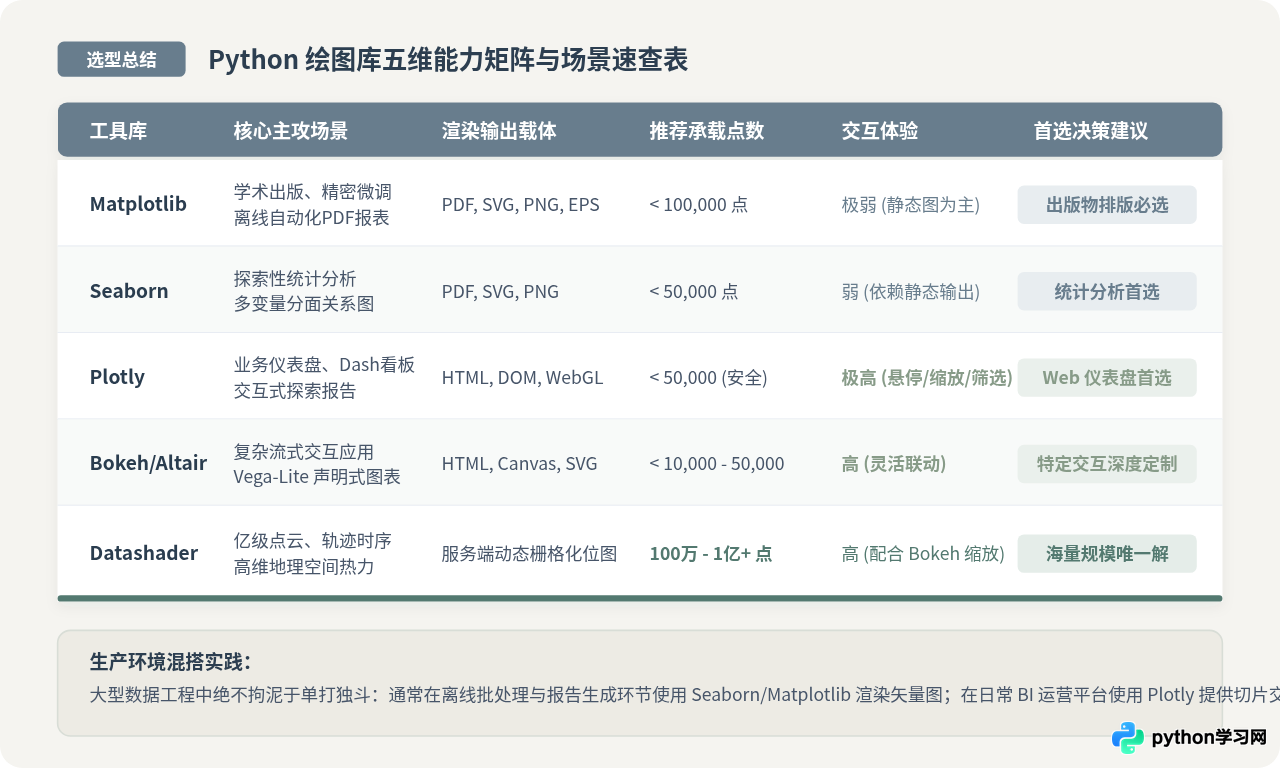
在真实工业生产中,成熟的技术架构往往不是非此即彼的单选,而是按照业务阶段的合理组合。下表对上述五大核心工具的关键指标进行了全景对照:
| 工具名称 | 主攻业务场景 | 渲染底层实现 | 推荐点数承载上限 | 交互能力 | 典型输出格式 | 最佳决策建议 |
|---|---|---|---|---|---|---|
| Matplotlib | 论文发表、书籍编排、离线周报 | C/C++ Backend (Agg, PDF) | < 100,000 点 | 极弱 (静态) | PDF, SVG, EPS, PNG | 对排版、公式及打印保真度有严苛要求时必选 |
| Seaborn | 探索性统计分析、多变量分面 | 封装 Matplotlib Artist | < 50,000 点 | 弱 (静态) | PDF, PNG, SVG | 数据特征分析与学术探索时的首选快捷工具 |
| Plotly | 业务仪表盘、交互式分析报告 | Plotly.js (D3, WebGL) | < 50,000 点 (安全区) | 极高 (悬停/切片) | HTML, JSON, WebGL | 面向终端用户与业务团队的 Web 报表首选 |
| Bokeh / Altair | 流式看板应用、语法严格声明 | BokehJS / Vega-Lite | < 10,000 - 50,000 点 | 高 (深度定制) | HTML, Canvas, SVG | 需要复杂 Python 回调或严谨图形语法时选用 |
| Datashader | 千万至亿级点云、高密轨迹时序 | Numba 多核并行像素直方图 | 100 万 - 1 亿+ 点 | 高 (动态瓦片) | 动态 PNG 瓦片流 | 点数突破浏览器承载上限时的唯一解法 |
工程化落地建议:三种工具的协同混搭
大型数字化平台或科研管线中,推荐采用以下分工组合方案:
- 离线沉淀层:在 Airflow 等批处理调度流水线中,使用 Seaborn + Matplotlib 批量产出无损 PDF/PNG 报告并附带至邮件告警中,确保任何客户端都能开箱即读,杜绝前端脚本错误风险;
- 在线分析层:针对日常业务维度的聚合数据(如每天几百到几千条维度的 KPI 指标),使用 Plotly 挂载在 FastAPI 或 Django 业务后台,为运营与管理层提供丝滑的拖拽筛选大屏;
- 海量挖掘层:当需要接入毫秒级物联网振动信号或全量空间轨迹时,在后端设立由 Datashader + Bokeh 支撑的瓦片切片微服务,前端仅请求当前视口对应的栅格化图片,实现百万级数据的秒级交互响应。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









