

Python可视化常用库对比:Matplotlib、Seaborn与Plotly
深入对比Python三大核心可视化库Matplotlib、Seaborn与Plotly的架构设计、语法范式、定制自由度及应用场景,提供完整的代码实现与工程选型决策指南。
在 Python 数据分析与工程落地体系中,Matplotlib、Seaborn 与 Plotly 并不是非此即彼的替代品,而是分别代表了三种截然不同的设计哲学:Matplotlib 提供了精细到像素级的底层排版控制能力,Seaborn 将复杂的统计计算与优雅的学术审美高度封装,而 Plotly 则立足于现代 Web 技术规范,主打丝滑的原生动态交互。选择哪一个库,本质上取决于你的最终交付物是学术出版物中的高精度印刷图、探索性数据分析过程中的快速洞察,还是面向业务决策者的交互式数据大屏。
一、技术架构与设计哲学分工
要建立清晰的选型标准,首先需要理解三者在 Python 图形生态中的位置及其底层对象的流转逻辑。
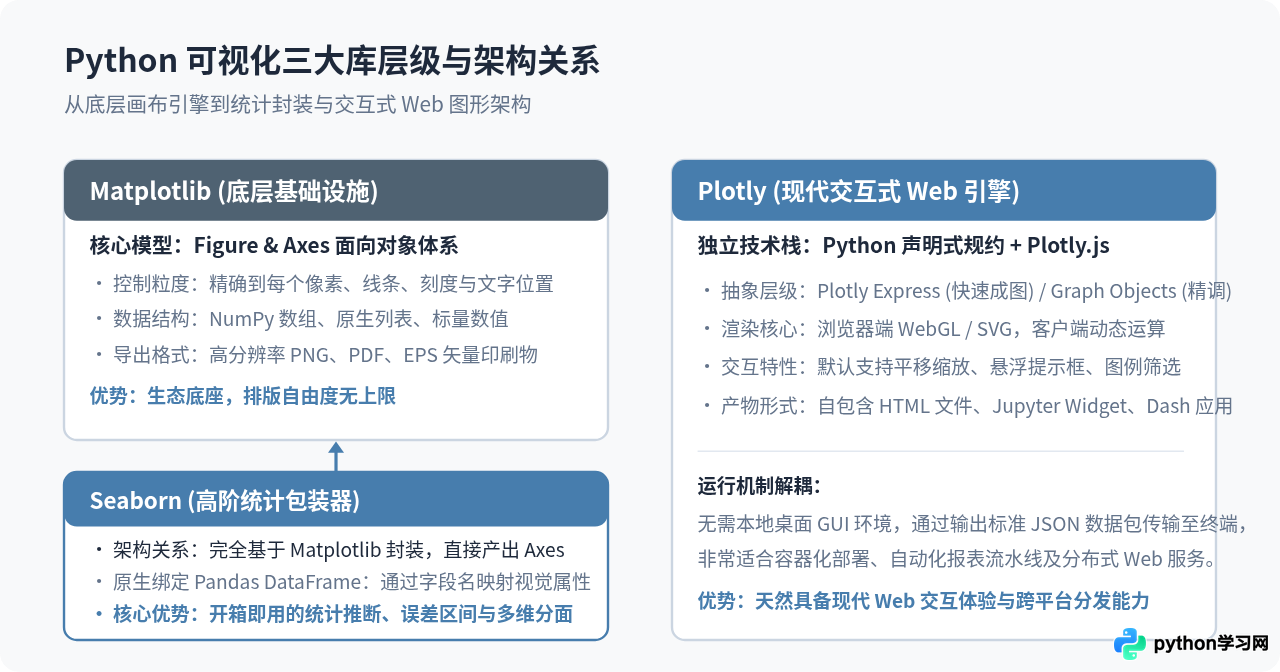
Matplotlib 是整个 Python 科学计算绘图的基石。它的设计最初受 MATLAB 启发,核心由 Figure(画布)和 Axes(坐标轴子图)两大层次构成。在 Matplotlib 中,每一个几何元素(刻度、轴脊、标签、多边形)都是可独立寻址并修改的对象。这种“命令式”的构建方式赋予了开发者绝对的控制权,但代价是代码冗长,且需要手动管理大量视觉细节。
Seaborn 并非脱离 Matplotlib 的独立渲染引擎,而是直接构建在 Matplotlib 之上的高阶声明式封装库。它与 Pandas 的 DataFrame 深度整合,要求数据遵循整洁数据(Tidy Data)规范。在 Seaborn 中,用户不再需要手动书写循环来遍历分组,只需指定数据列名与视觉通道(如 hue、style、size)的对应关系,库本身会自动完成误差带计算、核密度估计或回归拟合,并直接返回底层的 Matplotlib Axes 供进一步调整。
Plotly 则完全脱离了传统 Python 本地 GUI 渲染窗口。它的 Python API(主要是 plotly.express 与 plotly.graph_objects)本质上是一个轻量级的声明式规约生成器。每次执行绘图命令,Plotly 都会构建出符合技术标准的 JSON 规范,交由底层的 Plotly.js 引擎在浏览器中通过 WebGL 或 SVG 完成渲染。这意味着它天然具备了客户端级别的缩放、悬浮提示(Tooltip)、图例过滤和下钻交互能力。
二、标准绘图流程与同场景代码实现
为了直观对比三者在实际编码中的差异,我们设定一个典型的数据分析任务:基于包含“广告投入、销售额与销售区域”的数据集,绘制带有多分类区分、回归趋势线及置信区间的二维散点图,并将结果导出。
1. 依赖安装与模拟数据准备
在 Python 3.8+ 环境下通过 pip 安装必要组件(如果需要 Seaborn 和 Plotly 自动拟合回归线,还需要安装 statsmodels):
# 终端执行命令
pip install matplotlib seaborn plotly pandas statsmodels
准备一份标准的 Pandas DataFrame 示例数据:
import pandas as pd
import numpy as np

# 设置随机种子保证结果可复现
np.random.seed(42)
n_samples = 120

data = pd.DataFrame({
    "Ad_Spend": np.random.uniform(10, 100, n_samples),
    "Sales": lambda df: df["Ad_Spend"] * 2.5 + np.random.normal(0, 15, n_samples),
    "Region": np.random.choice(["华东", "华北", "华南"], size=n_samples)
})
data["Sales"] = data["Ad_Spend"] * 2.8 + np.random.normal(0, 18, n_samples)
2. 实现方案一:Matplotlib 原生面向对象模式
在 Matplotlib 中,推荐始终使用面向对象接口(fig, ax = plt.subplots()),避免使用容易引起状态混淆的 plt.plot() 全局状态机。
import matplotlib.pyplot as plt

# 1. 显式创建画布与坐标系
fig, ax = plt.subplots(figsize=(8, 5), dpi=100)

# 2. 手动遍历分类变量并逐组绘制散点
colors = {"华东": "#477DAD", "华北": "#4F6272", "华南": "#D97706"}
for region, group in data.groupby("Region"):
    ax.scatter(group["Ad_Spend"], group["Sales"], label=region, color=colors[region], alpha=0.75, edgecolors="none")

# 3. 手动计算并绘制全量回归趋势线(Matplotlib 不内置统计推断,需借助 numpy 拟合)
coef = np.polyfit(data["Ad_Spend"], data["Sales"], 1)
poly1d_fn = np.poly1d(coef)
x_vals = np.linspace(data["Ad_Spend"].min(), data["Ad_Spend"].max(), 100)
ax.plot(x_vals, poly1d_fn(x_vals), color="#1E293B", linestyle="--", linewidth=1.5, label="总体拟合线")

# 4. 手动设置图表装饰、刻度与图例
ax.set_title("广告投入与销售额关联分析 (Matplotlib)", fontsize=13, fontweight="bold", pad=12)
ax.set_xlabel("广告投入 (万元)", fontsize=11)
ax.set_ylabel("销售额 (万元)", fontsize=11)
ax.grid(True, linestyle=":", alpha=0.6)
ax.legend(title="区域", frameon=True)

# 5. 紧凑排版并保存为静态印刷图片
fig.tight_layout()
fig.savefig("scatter_matplotlib.png", dpi=300)
# plt.show()  # 交互式查看
3. 实现方案二:Seaborn 声明式统计模式
Seaborn 大幅简化了分组与统计运算,直接将 DataFrame 的列名映射到参数中:
import seaborn as sns
import matplotlib.pyplot as plt

# 1. 设置学术级主题样式
sns.set_theme(style="whitegrid", font="sans-serif")

# 2. 声明式绘图:自动完成分类颜色映射、回归趋势拟合及 95% 置信区间阴影计算
g = sns.lmplot(
    data=data,
    x="Ad_Spend",
    y="Sales",
    hue="Region",
    palette={"华东": "#477DAD", "华北": "#4F6272", "华南": "#D97706"},
    height=5,
    aspect=1.6,
    scatter_kws={"alpha": 0.75}
)

# 3. 通过返回的对象微调标题与标签
g.set_axis_labels("广告投入 (万元)", "销售额 (万元)")
g.figure.suptitle("广告投入与销售额关联分析 (Seaborn)", y=1.03, fontsize=13, fontweight="bold")

# 4. 导出高质量静态图
g.figure.savefig("scatter_seaborn.png", dpi=300, bbox_inches="tight")
# plt.show()
4. 实现方案三:Plotly Express 交互式模式
Plotly Express 同样遵循声明式原则,但生成的是可供缩放、下钻与浮动查看数值的交互组件:
import plotly.express as px

# 1. 声明式构造交互式图形对象(内置 OLS 趋势拟合与悬浮提示信息)
fig = px.scatter(
    data_frame=data,
    x="Ad_Spend",
    y="Sales",
    color="Region",
    trendline="ols",
    color_discrete_map={"华东": "#477DAD", "华北": "#4F6272", "华南": "#D97706"},
    title="广告投入与销售额关联分析 (Plotly 交互版)",
    labels={"Ad_Spend": "广告投入 (万元)", "Sales": "销售额 (万元)", "Region": "销售区域"},
    hover_data=["Region"]
)

# 2. 更新布局样式,适配现代报表视觉
fig.update_layout(
    template="plotly_white",
    hovermode="closest",
    legend=dict(title_text="销售区域", orientation="v", yanchor="top", y=0.98, xanchor="left", x=1.02)
)

# 3. 导出为可脱离 Python 运行的单文件 HTML,或在 Jupyter 中直接渲染
fig.write_html("scatter_plotly.html")
# fig.show()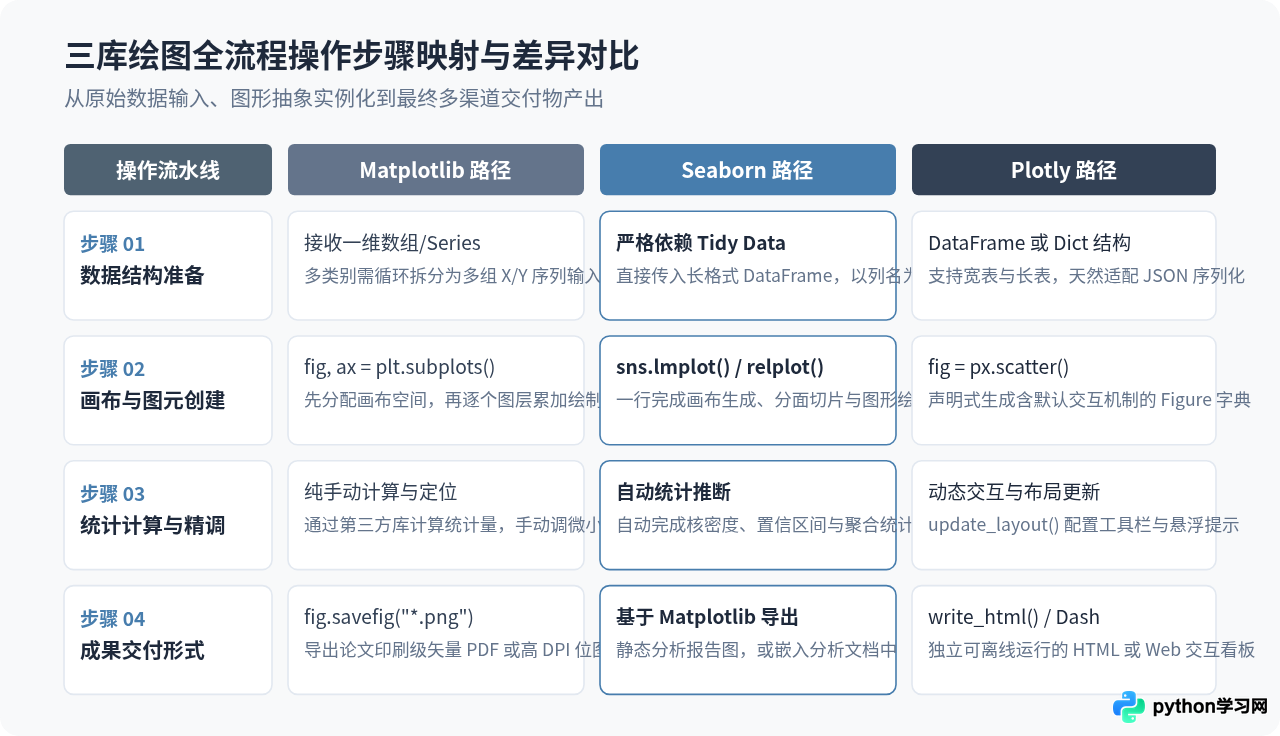
三、核心技术维度的深度横向对比
为了在具体业务研发或科研项目中做出合理技术选型,我们需要从四个核心技术维度进行权衡:
1. 语法思维与开发效率
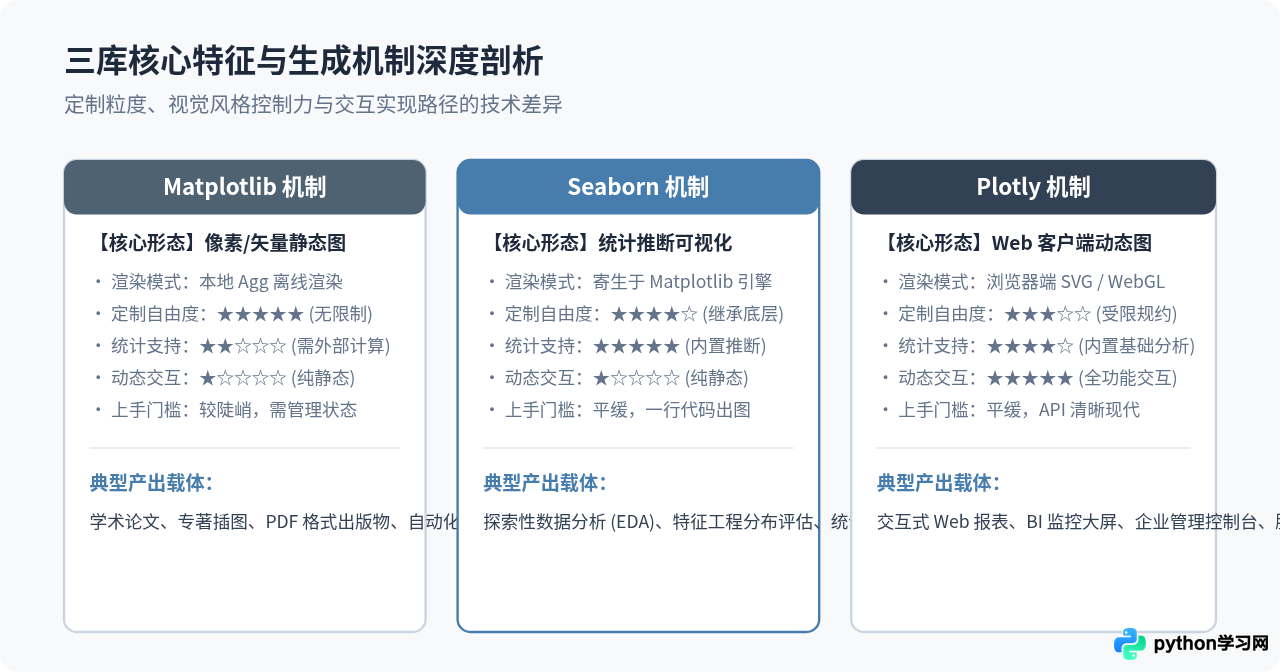
Matplotlib 采用纯粹的命令式编程思维。你需要主动告诉程序“在第几个子图上画一条线”、“把 X 轴范围设为多少”、“在坐标 (x,y) 处放置图例”。这对于自定义非常规图形(例如双极坐标组合、自定义拓扑图)极为有利,但对于日常分析,代码量通常是 Seaborn 的 3 到 5 倍。
Seaborn 倡导语义声明式思维。它将“探索数据特征”放在第一位,通过 sns.catplot、sns.pairplot 等复合函数,只需传入一个长表 DataFrame,就能在一两行代码内完成多变量联合分布的网格展开(FacetGrid)。
Plotly 同样支持简洁的 plotly.express 语法,并提供了对复杂数据格式(如地理 GeoJSON、三维点云、层次化旭日图 Sunburst)的开箱即用支持。它的数据结构本质上是 JSON/Dict,非常符合 Web 开发者的心智模型。
2. 定制自由度与审美下限
在审美下限上,Seaborn > Plotly > Matplotlib。默认情况下,未经调优的 Matplotlib 图表具有浓厚的早期工程风格,刻度线外凸、边框沉重、色盘对比生硬;而 Seaborn 和 Plotly 默认的配色、间距与背景网格均符合现代设计规范,无需任何参数即可直接截屏用于汇报。
但在定制上限上,Matplotlib 拥有无可争议的绝对统治力。由于 Seaborn 底层就是 Matplotlib,遇到特殊需求(例如为特定数据点添加定制样式的局部放大镜指示框)时,可以直接调用底层的 ax.annotate() 或 ax.secondary_xaxis()。而 Plotly 的定制则受限于 Plotly.js 规范内预定义的配置项,对于非常规的几何修饰或底层画布操作,扩展成本极高。
3. 交互性能与分发成本
交互能力是三者最根本的分水岭。Matplotlib 和 Seaborn 生成的是纯粹的静态栅格(Bitmap)或矢量路径(Vector),在导出后无法进行任何二次探索;即使在本地运行时开启交互窗口,也仅能做简易的放大和拖拽,无法满足向非技术背景客户或领导交付探索成果的需求。
Plotly 则将数据与渲染逻辑完全打包在输出成果中。导出的 .html 文件包含内嵌的轻量级 JavaScript 库,接收者无需安装任何 Python 运行环境,使用双击浏览器即可自由切换图例、查看每一个点的详细元数据、以及圈选局部数据重新计算。但在数据规模达到数十万条以上时,浏览器处理大量的 DOM 节点可能发生掉帧,此时必须切换至基于 WebGL 的 go.Scattergl 模式以维持渲染性能。
四、选型决策指南与落地推荐
在工程实践中,不建议单打独斗使用某一个库,而应根据项目交付阶段制定清晰的决策树:
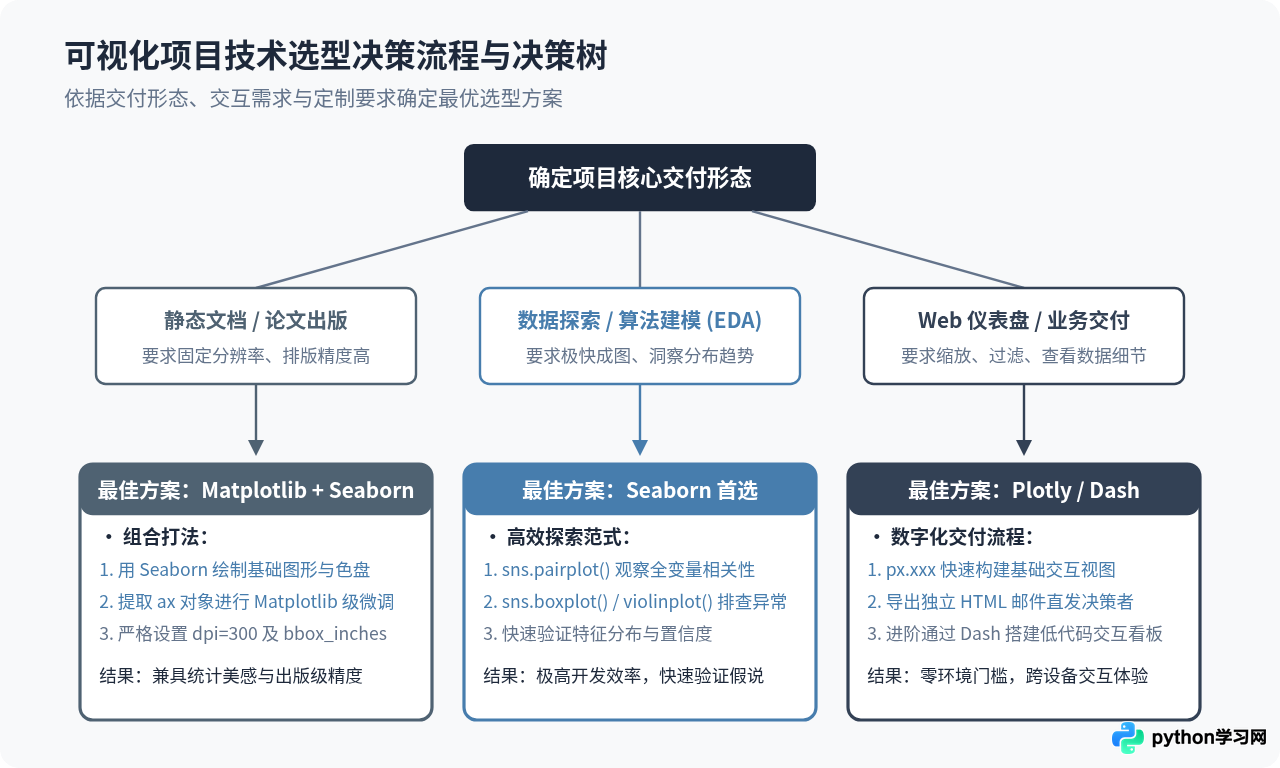
选型对照总结表
| 评估维度 | Matplotlib | Seaborn | Plotly |
|---|---|---|---|
| 主攻目标 | 像素级精细控制、出版级学术图 | 探索性统计分析、多维数据分布洞察 | 现代 Web 交互图表、交互式仪表盘 |
| 代码抽象层次 | 底层命令式(声明画布再逐个绘制图元) | 高阶语义声明式(直接映射 DataFrame 字段) | 高阶声明式(Express)+ 底层字典(GO) |
| 数据输入要求 | NumPy 数组、原生列表、单个 Series | 标准 Tidy Data(长格式 Pandas 表格) | Pandas 表格、结构化字典、JSON |
| 统计计算支持 | 仅提供简单直方图,其余需手动计算 | 原生支持 KDE、回归曲线、95% 置信带 | 内置基础 OLS 趋势拟合、分位数计算 |
| 终端交付产物 | PNG、JPG 位图;PDF、SVG 矢量文件 | 静态位图与矢量图(依托 Matplotlib) | 自包含 HTML、WebGL 交互视窗、Dash |
| 典型工程短板 | 代码繁杂冗长,默认视觉样式陈旧 | 无法原生支持交互,依赖长格式数据整理 | 海量 DOM 节点容易卡顿,特殊排版受限 |
五、工程实践中的常见陷阱与解决策略
初学者容易频繁使用 plt.figure()、plt.plot() 和 plt.title()。如果在脚本或循环中未调用 plt.close(),Matplotlib 的全局状态机会持续常驻内存,导致后续绘制的图形出现前一张图的线条残留,甚至引发内存泄漏。工程规范:始终显式使用 fig, ax = plt.subplots(),并在批量生成任务结尾显式调用 plt.close(fig)。
当需要绘制散点数量超过 50,000 点时,默认基于 SVG 的 px.scatter() 会在浏览器中生成数万个 DOM 节点,直接导致页面无响应或卡死。解决策略:在海量点场景下,切换至基于 GPU 硬件加速的 WebGL 模式,即使用 plotly.graph_objects.Scattergl 代替普通散点,可流畅渲染百万级点云。
Seaborn 的大部分功能(如 hue="类别")必须基于长表(Long-form/Tidy Data)运作。许多业务导出的报表将不同类别的数值放在并列的多列中(宽表格式),直接传入会导致分组参数报错。解决策略:绘图前使用 pd.melt(df, id_vars=['标识列'], value_vars=['列1', '列2']) 将宽表转换为长表。
综上所述,Python 可视化工具链并非孤立割裂的竞争关系。熟练掌握“用 Seaborn 快速透视数据分布,用 Matplotlib 敲定论文与打印排版细节,用 Plotly 赋能端到端 Web 交互产品”的组合范式,能够在不同的业务与科研阶段以最低的工程代价获得最佳的可视化表现。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









