

数据科学选Anaconda还是原生Python?Web开发又该怎么选
深入对比数据科学与Web开发场景下Anaconda与原生Python的核心机制差异,从依赖解析、系统开销、容器部署及商业许可等维度,提供实用的环境配置步骤、选型依据与避坑指南。
底层机制差异:Conda 与 Pip/venv 的根本区别
很多初学者容易把 Anaconda 与原生 Python 的区别简单理解为“自带的包多与少”,这种理解忽视了二者在底层包管理机制和系统依赖处理上的本质分野。
原生 Python 官方安装包仅提供 Python 解释器和标准库。当我们在原生环境中使用 pip 安装第三方库时,pip 本质上是专门面向 Python 生态的包管理器。它从 PyPI 下载预构建的 Wheel 包或源代码,其依赖解析仅限于 Python 层级的库。一旦遇到需要调用底层 C/C++、Fortran 运算库(如 MKL、OpenBLAS)或特定硬件计算架构(如 NVIDIA CUDA)的情况,宿主系统如果缺乏相应的编译链和系统运行时,安装过程就会报错中断。
Anaconda 的核心则是 conda。conda 是一个系统级的通用二进制包管理器,它并不把 Python 当作唯一核心,而是将 Python 解释器本身以及所有第三方库、底层 C/C++ 动态链接库和驱动工具链全部作为平级组件进行管理。在 Conda 环境中安装包,相当于在沙箱内统一部署了整套跨语言的运行环境,彻底绕过了操作系统的动态库版本冲突。
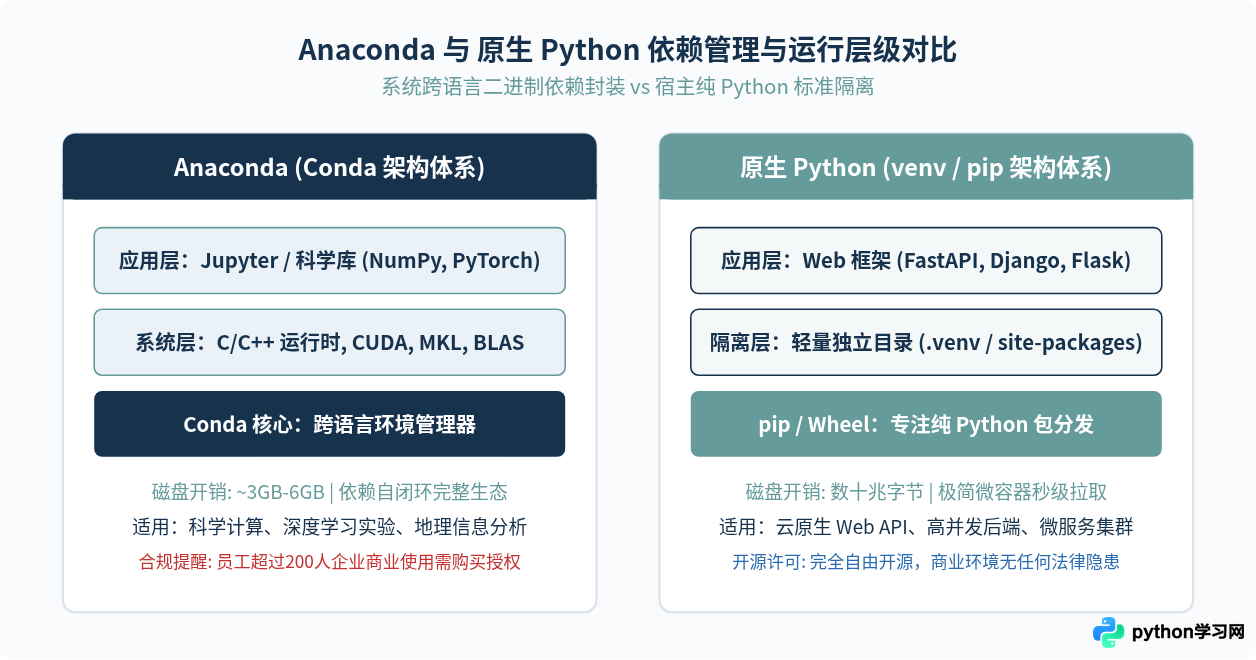
另外,还需要注意商业合规层面的重大差异。原生 Python 和 PyPI 平台完全遵循自由开源许可,任何规模的企业均可免费商用。而 Anaconda 自 2020 年起更新了服务条款(TOS),若组织员工超过 200 人,在商业活动中使用默认的 Anaconda 官方存储库(repo.anaconda.com)必须购买商业许可证。这一规定使得很多大型企业的工程团队在开发与生产中主动剔除 Anaconda。
数据科学场景:为什么 Anaconda 长期占据主导?
数据科学的研发特点决定了环境必须具备三大能力:高性能数值计算绑定、底层硬件驱动隔离、以及跨团队实验结果的高一致性复现。
1. 告别复杂的底层编译
数据分析与机器学习的核心库(例如 NumPy、SciPy、TensorFlow、PyTorch、GDAL)均大量采用 C、C++ 和 Fortran 编写,以追求极致的矩阵计算速度。如果在原生 Python 中通过 pip 安装某些包含底层扩展的库,系统常常需要调用本地的 gcc/clang 编译器或特定的 Fortran 编译器,只要系统环境稍有缺失,就会弹出长篇编译失败日志。Conda 提供的全部是预编译完毕的完整二进制包,连同依赖的底层数学优化库(如 Intel MKL、OpenBLAS)一并打包,开箱即具备优化的矩阵计算性能。
2. 精准的 CUDA 与 GPU 驱动协同
深度学习工程师经常需要配置 GPU 加速环境。在原生环境下,开发者必须手动在宿主操作系统安装匹配显卡驱动版本的 NVIDIA CUDA Toolkit 与 cuDNN,这一配置流程极易破坏宿主机其他软件的依赖。而 Conda 允许将特定版本的 cudatoolkit 封装在指定的虚拟环境内部。这意味着你可以在同一个机器上拥有一个运行 CUDA 11.8 的 PyTorch 环境,同时拥有另一个运行 CUDA 12.1 的 TensorFlow 环境,两者完全独立互不干扰。
数据科学推荐操作范例
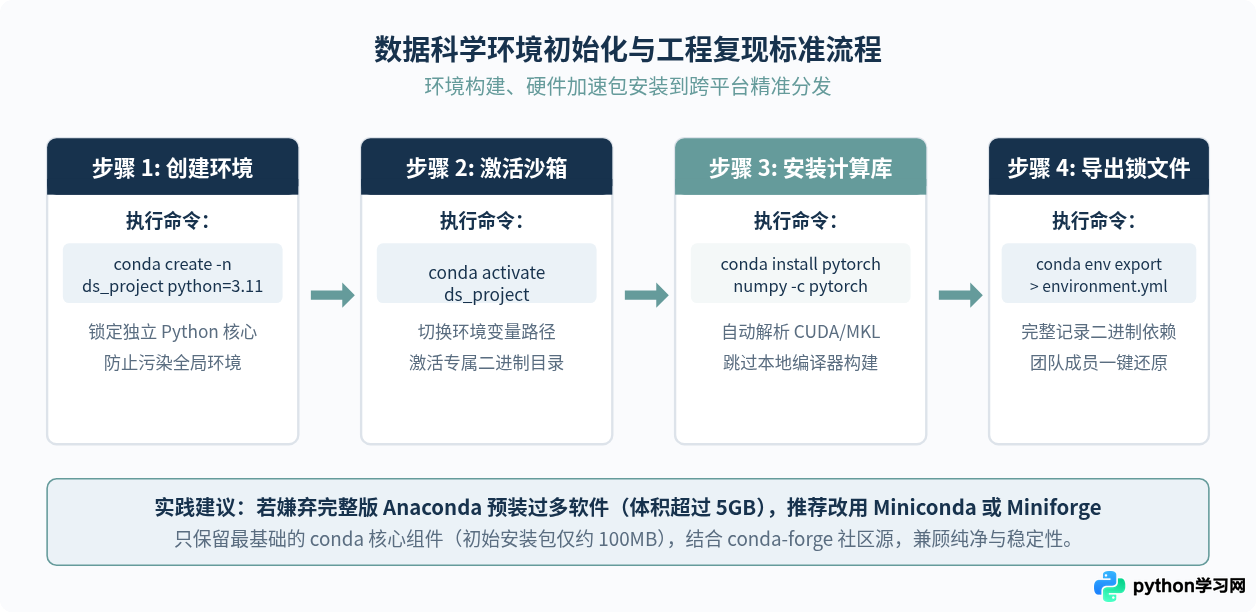
在数据科学工作中,千万不要直接往 Conda 的 base 主环境里塞入所有依赖,否则极易发生包依赖求解器(Solver)耗时无限循环的问题。标准操作如下:
# 1. 创建指定 Python 版本的独立环境
conda create -n sentiment_analysis python=3.10 -y

# 2. 激活新建环境
conda activate sentiment_analysis

# 3. 安装 PyTorch 深度学习框架及必要分析库(优先使用官方推荐 channel)
conda install pytorch torchvision torchaudio pytorch-cuda=11.8 -c pytorch -c nvidia -y
conda install pandas scikit-learn matplotlib jupyterlab -y

# 4. 导出跨平台环境配置文件供同组成员使用
conda env export --no-builds > environment.yml
同组的科研或算法人员只需拿到该 environment.yml 文件,执行 conda env create -f environment.yml,即可在不同设备上获得完全相同的底层数学库与 Python 运行状态。
Web 开发场景:为什么坚决推荐原生 Python 与虚拟环境?
如果说数据科学最看重的是“底层数学驱动的完整封装”,那么 Web 开发与后端服务最看重的则是极致的轻量化、标准化的容器交付、极快的部署流水线以及无瑕疵的合规性。
1. 容器镜像体积与云原生规范
在现代 Web 开发中,代码通常以 Docker 容器的形式交付至 Kubernetes 或云托管服务器。如果基于 Anaconda 基础镜像构建 Web 应用,哪怕什么代码都没写,初始镜像体积就轻松突破 3GB 到 5GB。这不仅极大浪费镜像仓库存储带宽,在生产环境做水平自动伸缩(Autoscaling)时,容器拉取耗时更会从秒级拉长到数分钟。
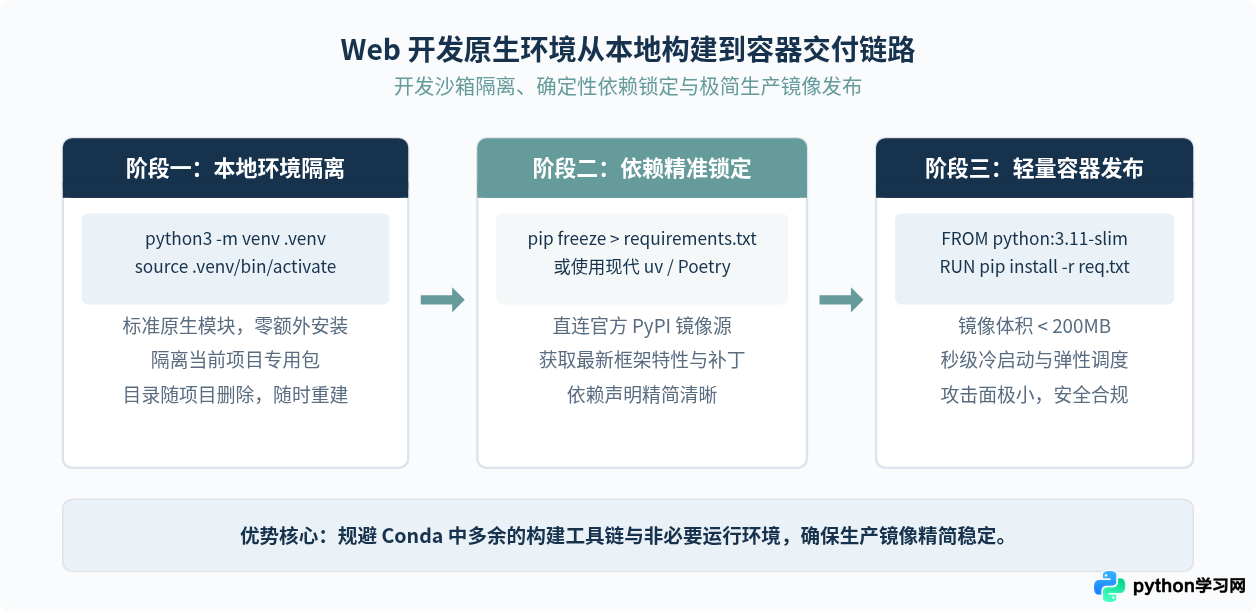
相比之下,基于原生 Python 官方的 python:3.11-slim 或 python:3.12-alpine 镜像,基础体积仅约 50MB~150MB。部署 FastAPI 或 Django 之后,整个业务镜像通常也能稳定控制在 200MB 以内,实现秒级拉起与分发。
2. 依赖更新速度与生态支持
Web 开发中使用的依赖通常都是纯 Python 代码或标准的轻量 C 扩展,例如 Pydantic、SQLAlchemy、Redis 驱动、Uvicorn 等。PyPI 是全球所有 Python 开源包的第一发源地,任何安全补丁或新版本都会第一时间推送到 PyPI。而 Conda 的官方频道(甚至是 conda-forge 社区源)虽然更新也算活跃,但对于大量小众的 Web 插件、支付 SDK、第三方云服务 SDK 而言,往往存在数天甚至数周的滞后,甚至根本没有维护相应的 conda 包。如果在 Conda 环境中频繁穿插调用 pip,很容易破坏 Conda 自带的包元数据导致环境崩溃。
Web 开发推荐操作范例
Web 后端项目从本地初始化到准备生产交付,建议统一采用原生工作流:
# 1. 切换至项目工作目录
mkdir my_web_app && cd my_web_app

# 2. 使用原生 Python 创建轻量隔离环境(在项目根目录生成 .venv 文件夹)
python3 -m venv .venv

# 3. 激活虚拟环境
# macOS / Linux:
source .venv/bin/activate
# Windows:
# .venv\Scripts\activate

# 4. 升级 pip 并安装 Web 核心依赖
pip install --upgrade pip
pip install fastapi "uvicorn[standard]" sqlalchemy alembic pydantic

# 5. 导出确定的依赖清单
pip freeze > requirements.txt# 使用官方精简镜像作为基础环境
FROM python:3.11-slim
# 设置工作目录与安全环境变量
WORKDIR /app
ENV PYTHONDONTWRITEBYTECODE=1 \
PYTHONUNBUFFERED=1
# 优先复制依赖清单,充分利用 Docker 层缓存
COPY requirements.txt .
# 安装依赖并清理缓存文件
RUN pip install --no-cache-dir -r requirements.txt
# 复制业务源码
COPY . .
# 暴露端口并启动服务
EXPOSE 8000
CMD ["uvicorn", "main:app", "--host", "0.0.0.0", "--port", "8000"]混合场景应对与全方位选型决策矩阵
在实际工程中,开发者常会遇到混合场景:例如需要编写一个基于 FastAPI 的 Web 接口,但接口内部又要调用一个已经训练好的 PyTorch 深度学习模型进行推理预测。此时该如何选择?
工程落地法则:训练走 Conda,推理走原生容器
推荐采用阶段解耦的策略:
- 模型研发与训练阶段:在开发机或算力集群使用 Miniconda / Anaconda 进行实验,利用其对 CUDA 驱动与科学计算包的完整管理能力,训练模型并导出为标准的格式文件(例如 ONNX 或 TorchScript / Safetensors)。
- 线上服务部署阶段:Web API 服务仍然使用原生 Python 构建。在线上推理时,尽量使用针对 CPU 或轻量 GPU 优化的纯推理运行时(例如
onnxruntime),通过原生pip即可轻松安装,不需要把整套沉重的 Conda 环境打包进生产服务器。
如果在 Conda 环境中必须使用 pip 安装某个 PyPI 独有的包,必须遵守顺序原则:先通过
conda install 装齐所有能够在 conda 中找到的底层包和依赖;最后一次性使用 pip install 补充缺失的纯 Python 包。千万不要在执行完 pip 之后,又回过头来用 conda 安装基础库,否则 conda 的求解器无法识别 pip 覆盖的文件哈希,极易导致环境被破坏。
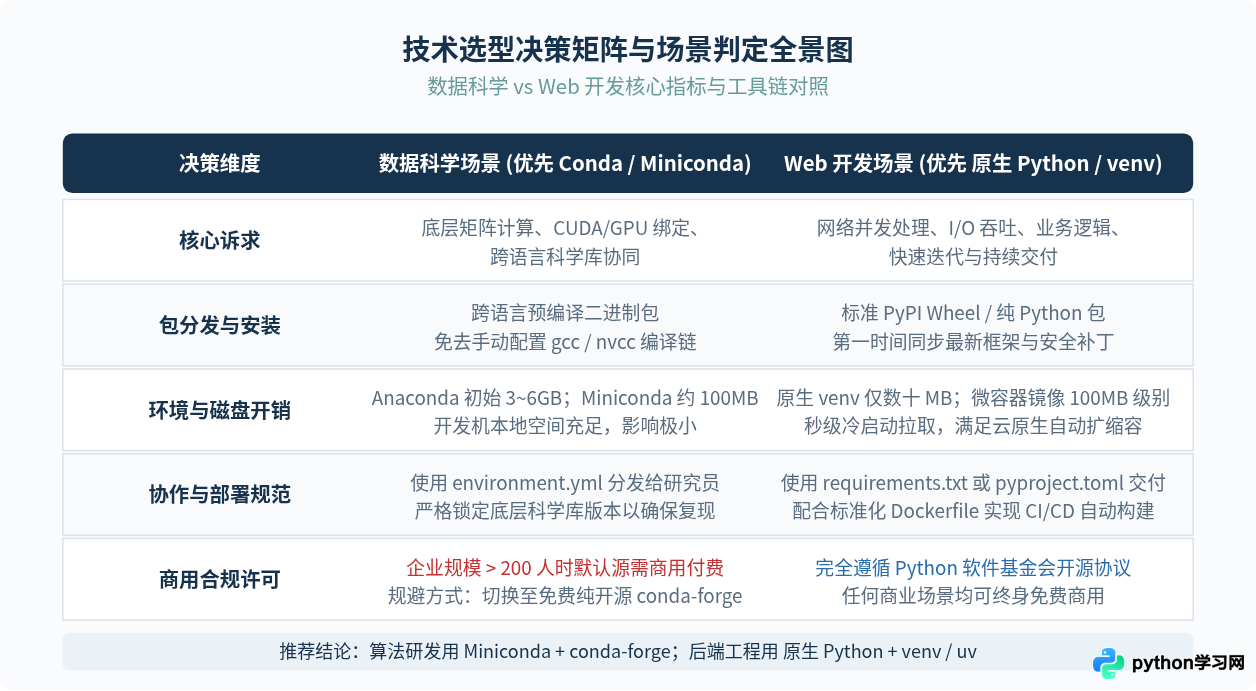
最终选型总结与建议
在面对 Anaconda 与原生 Python 的抉择时,不要被“哪个工具更高级”的虚假讨论误导,二者的区别是面向不同应用目标所设计的两套不同技术路径:
- 如果你是数据分析师、算法工程师或高校科研人员:首选 Miniconda(搭配 conda-forge 频道)。它既具备 Anaconda 解决底层 Fortran、C++ 依赖和 CUDA 驱动的强大跨语言包管理能力,又摆脱了数以百计预装无用软件的臃肿负担。
- 如果你是后端工程师、全栈开发者或构建云原生微服务:坚定选择 原生 Python,并熟练使用内置的
venv模块或现代高性能工具(如uv、Poetry)。它能为你带来极其纯净的代码环境、极小的容器镜像、最及时的 PyPI 安全漏洞补丁,以及完全免于商业侵权风险的法律安全保障。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









