

怎么回答面试官关于pandas3.0向后兼容的质疑?
针对技术面试中关于 pandas 3.0 向后兼容性断裂的质疑,本文提供从认同动机、深度技术归因(CoW与PyArrow)到企业级平滑升级防御体系的完整结构化解答方案。
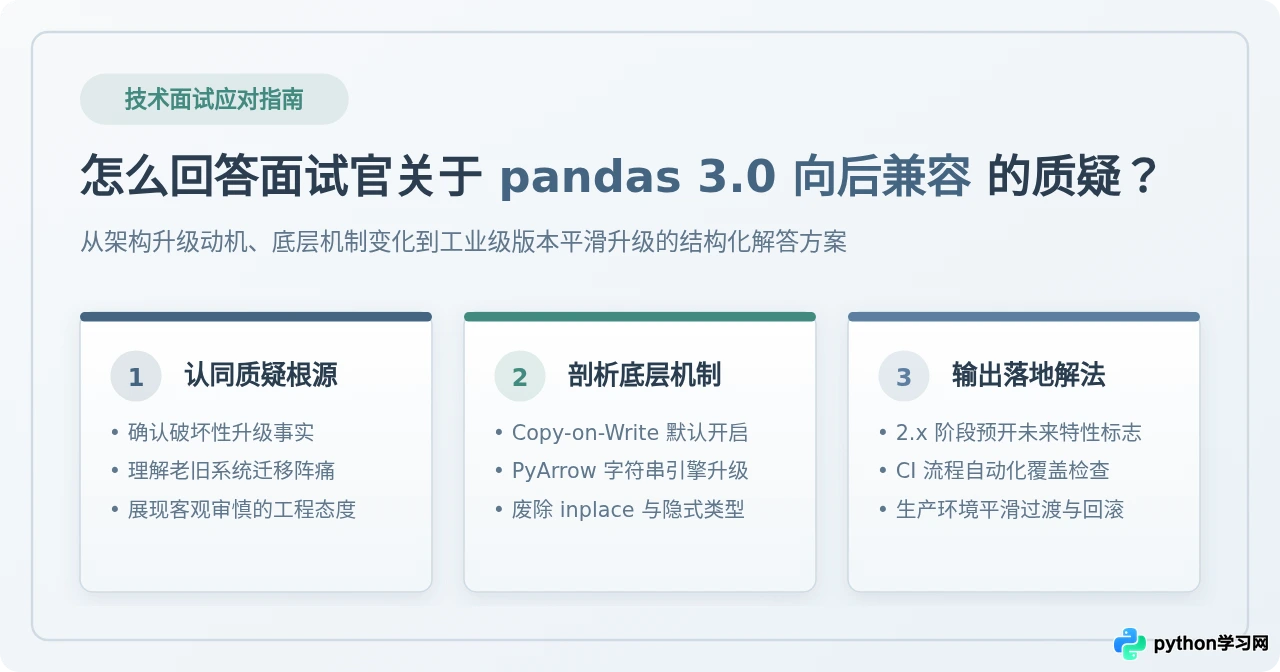
面试官提出对 pandas 3.0 向后兼容性的质疑,通常并非否定新版本的价值,而是借此考察候选人是否真正掌握破坏性变更的技术细节、能否预判旧项目迁移风险,以及在工程实践中是否有成熟的升级与兼容防御方案。回答的核心策略是“认同痛点、切中机制、给出防线”:先明确承认 pandas 3.0 确实引入了不可忽视的破坏性改动(如 Copy-on-Write 默认开启、PyArrow 字符串类型推导、全面弃用 inplace 等),紧接着从内存与类型底层阐明官方做此取舍的根由,最后用可落地的版本平滑迁移与 CI 防护方案证明自己的工程治理能力。
一、认清质疑本质:面试官究竟在考察什么?
在数据工程或 Python 高级岗位面试中,“pandas 3.0 不兼容老代码、升级容易踩坑”是面试官非常喜欢抛出的压力型问题。很多缺乏线上维护经验的求职者容易犯两种极端错误:要么盲目吹嘘新特性,对老项目动辄上万行的历史负担轻描淡写;要么附和抱怨,将破坏性升级归咎为开源社区的随意折腾。
事实上,面试官真正关心的维度主要有三个:
- 技术敏感度与底层认知:你是否清楚 pandas 3.0 到底改动了哪些核心行为?你理解的是 API 名称变化,还是看透了背后的内存管理(CoW)和存储引擎(Apache Arrow)更迭?
- 代码健壮性防范意识:你是否能一眼看出哪些旧写法语义在 3.0 会静默失效或抛错(例如依赖视图修改原始数据的链式赋值、基于 NumPy object 的杂质数据列)?
- 生产环境的工程化升级思维:当面对庞大的历史代码库时,你是有计划、有灰度、有回滚措施地渐进推进,还是一刀切地升级导致线上事故?
二、核心破坏性变更与技术话术拆解
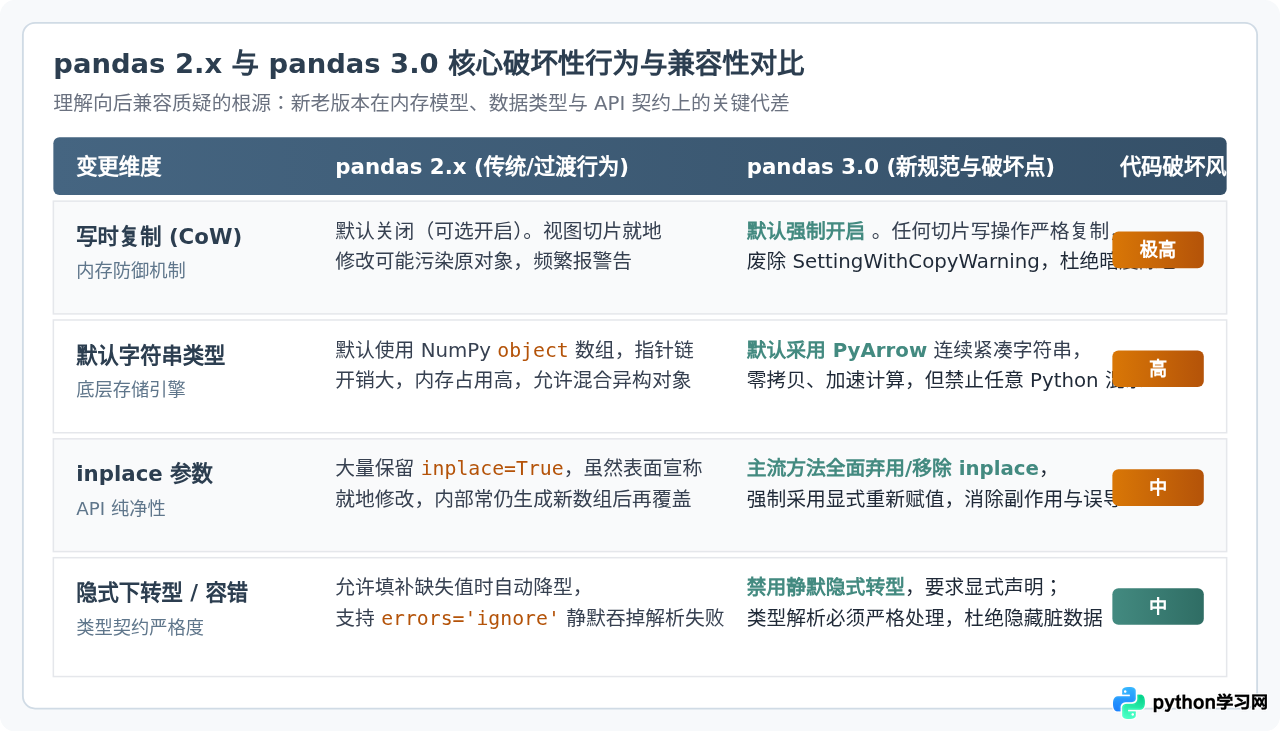
向后兼容的质疑必须用具体的破坏性机制来拆解。回答时切忌泛泛而谈,直接点出以下三大引发不兼容的核心支柱,即可展现出扎实的技术底蕴。
1. 写时复制(Copy-on-Write, 简称 CoW)默认开启
在 pandas 2.x 及更早版本中,用户从 DataFrame 获取子切片时,底层究竟是引用(View)还是深拷贝(Copy)一直处于模糊地带。这种模糊不仅催生了令无数开发者困惑的 SettingWithCopyWarning,更导致大量遗留业务代码暗中依赖“修改子切片即可同步修改原 DataFrame”的副作用。
在 pandas 3.0 中,Copy-on-Write 变为强制默认行为。任何通过切片提取的子对象在尝试修改时,都会在写入瞬间自动创建独立深拷贝副本,原有数据绝不会被静默篡改。
在旧代码中,sub = df['col']; sub.iloc[0] = 999 可能会修改 df;但在 pandas 3.0 中,sub 发生写操作时被立即隔离,df 保持原值,或者直接抛出 ChainedAssignmentError。依赖这种副作用的老旧清洗流水线将彻底失效。
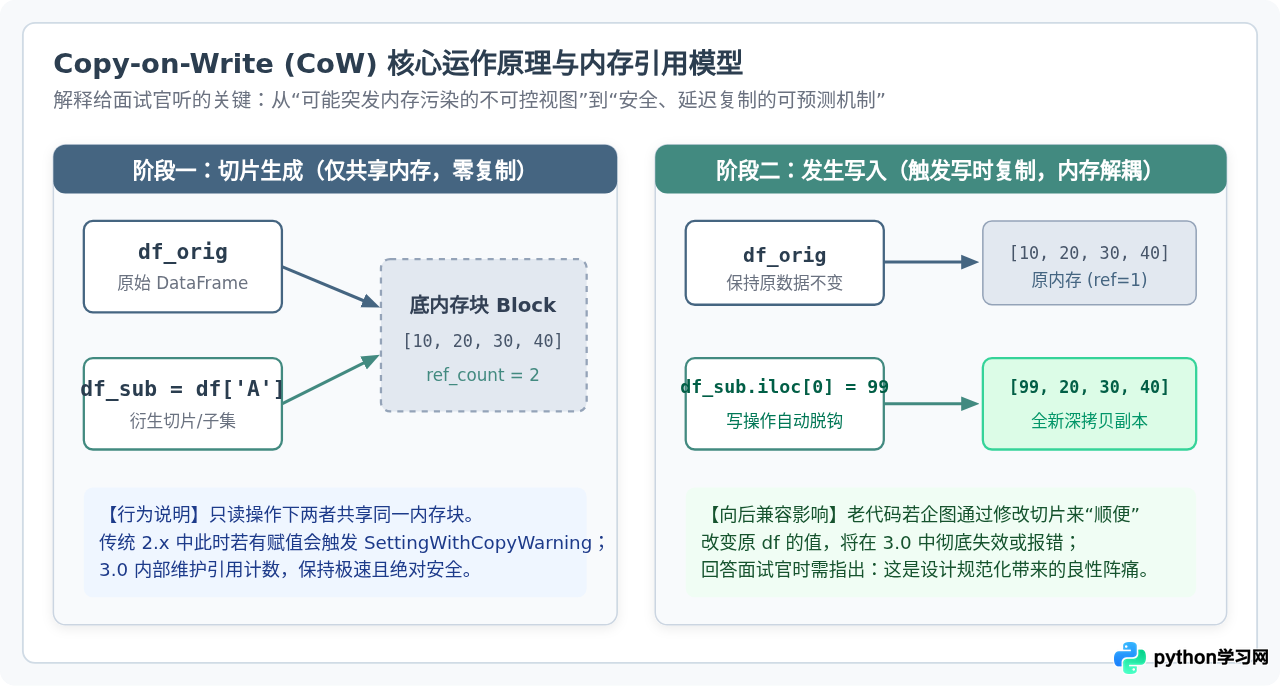
回答面试官时,可这样点明价值:“官方之所以在 3.0 承担破坏向后兼容的代价强制推行 CoW,是因为这彻底终结了 Pandas 诞生十余年来最臭名昭著的不可预测内存副作用,使得切片操作从 O(N) 复制降为 O(1) 延迟引用,用一次代码规范化换取了系统长期的确定性。”
2. 默认字符串类型迁移至 PyArrow 引擎
长期以来,pandas 的字符串列均采用 NumPy 的 object 类型存储。其底层是一连串指向 Python 字符串对象的指针,内存碎片化极高,且无法利用现代 CPU 的 SIMD 向量化指令。
pandas 3.0 默认将字符串类型推断为 string[pyarrow](即基于 Apache Arrow 的连续内存缓冲):
- 兼容性隐患:老旧数据集中若存在同列混合类型(如既有
"2024"字符串又有整型数字2024),PyArrow 将拒绝隐式兼容并强制要求类型纯净;此外,某些直接接收 Pandas 数组并假设其为 NumPyobject数组的第三方专有库在传递时会报类型断言错误。 - 收益:文本列内存开销减少 60%~80%,字符串过滤与正则匹配速度提升 3 到 10 倍。
3. API 纯净化:彻底废除 inplace 与静默降型
在早期设计中,大量函数提供了 inplace=True 参数(如 df.dropna(inplace=True)、df.drop_duplicates(inplace=True))。但这往往只是“伪就地修改”——底层实际上在创建了新数组后再用指针覆盖原变量名,既没有真正节省内存,又阻碍了方法链(Method Chaining)的函数式调用。
在 pandas 3.0 中,核心方法中的 inplace 参数被全面弃用或移除;同时,errors='ignore' 在 to_datetime 等方法中不再允许静默吞掉解析失败。如果老代码大量使用上述语法,升级后将直接遭遇报错阻断。
# 旧版本危险且过时的写法 (pandas 2.x)
df.dropna(subset=['id'], inplace=True)       # 破坏链式调用,3.0 中已废弃
df['age'][df['age'] < 0] = 0                  # 链式赋值,3.0 中直接阻断报错

# pandas 3.0 规范写法
df = df.dropna(subset=['id'])
df.loc[df['age'] < 0, 'age'] = 0              # 显式使用 .loc 定位赋值
三、实战应答三步法(可直接现场表达的话术结构)
面对面试官犀利的质疑,切忌临场散漫展开。建议按照以下“表态定性 → 技术归因 → 工程防护”三步法进行结构化作答:
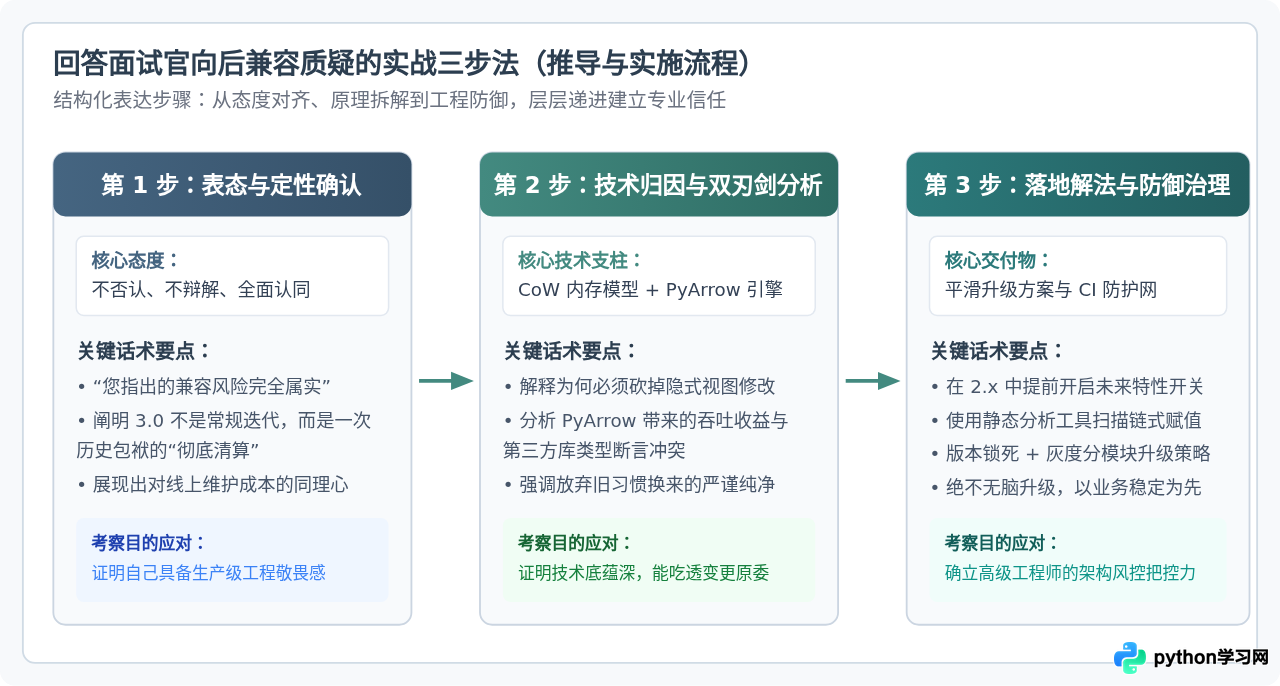
第一步:表态与定性确认(建立共情与同理心)
“面试官您指出的这点非常切中实际。pandas 3.0 确实不是一次常规的微调迭代,而是 Pandas 发展史上一次重大的‘架构清算’。对于存在大量遗留代码的业务线来说,直接原地升级确实极大概率会导致代码报错甚至逻辑隐性偏差。盲目跟风升级是不可取的。”
第二步:技术归因与双刃剑剖析(展现专业深度)
“但如果我们拆解不兼容的根源,会发现社区这么做是有充分工程必要性的。核心破坏点集中在两块:一是 Copy-on-Write 默认开启,彻底封死了过去依赖视图切片隐式修改原数据的写法;二是默认字符列转向 PyArrow 存储,禁止了 NumPy object 的混合脏数据。这些改动虽然短期带来了代码重构成本,但从根本上杜绝了内存悬垂引用与 SettingWithCopy 幽灵警告,并带来了数倍的性能吞吐提升。它破坏的是过去‘不规范的代码习惯’,换取的是未来大型数据流水线的可预测性。”
第三步:工程落地与防御方案(展现架构风控能力)
“在实际工业级项目中,我们团队会采取‘依赖刚性锁定 + 2.x 阶段前置兼容验证’的治理方案:在现有 2.x 环境中,通过 pd.options.mode.copy_on_write = True 提前开启未来模式,结合 CI 自动化测试暴露所有链式赋值与废弃 API,分模块重构过关后再安全切换到 3.0,绝不让生产环境承担未知风险。”
四、兜底防御体系:向面试官展示工程化治理落地能力
空谈理念不足以打动经验丰富的技术专家。想要在面试中脱颖而出,必须给出可落地的生产防御技术方案。
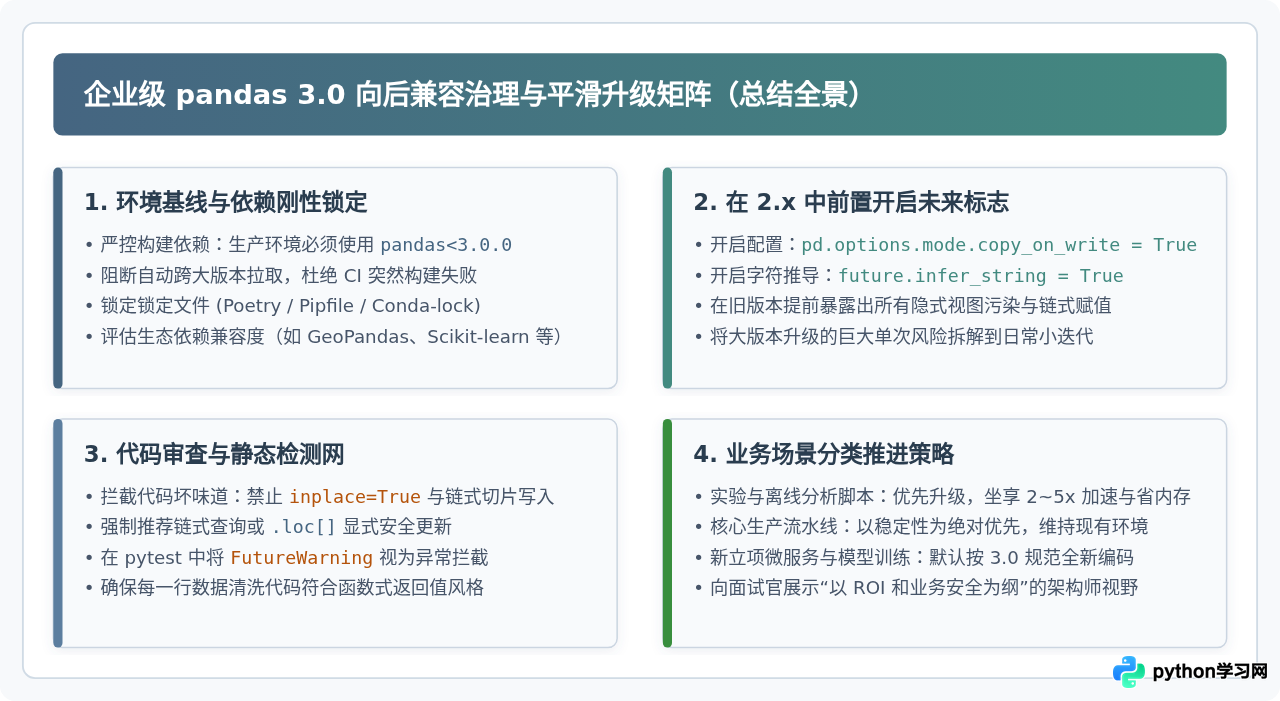
1. 依赖管理的刚性约束
在构建脚本与依赖配置文件中,严禁使用宽松的 pandas>=2.0。对于尚未完成全面回归测试的老旧项目,必须在依赖中显式锁定主版本上限:
# pyproject.toml 示例
[tool.poetry.dependencies]
python = "^3.10"
pandas = ">=2.2.0, <3.0.0"  # 刚性锁定,杜绝 CI 环境意外拉取破坏性主版本
2. 在 pandas 2.x 中提前激活未来特性开关
无需等到全量部署 pandas 3.0 才发现代码炸裂。Pandas 官方在 2.2+ 版本中就提供了向前兼容开关。可以在开发与测试环境中提前激活:
import pandas as pd

# 在应用入口或 conftest.py 统一开启未来特性
pd.options.mode.copy_on_write = True       # 提前模拟 3.0 的写时复制行为
pd.set_option("future.infer_string", True)  # 提前模拟 3.0 的 PyArrow 字符串推导
一旦在现有测试套件中开启这两个选项,现存所有利用切片视图反向赋值的坏味道代码均会立即暴露,团队可以在零停机风险的前提下逐个修复。
3. CI 门禁与静态代码规约检查
在持续集成流水线中,配置代码扫描规则拦截典型的向后不兼容语法:
- 利用 Ruff 或 Flake8 插件扫描显式使用
inplace=True的 AST 节点; - 在
pytest配置文件中将FutureWarning提升为报错级别(-W error::FutureWarning),确保遗留弃用警告在合入主分支前必须清零; - 对外部依赖库(如旧版 sklearn、专有数据连接器)进行兼容性矩阵排查,确认第三方扩展是否已适配 Arrow 格式。
五、面试现场应变提醒与避坑指南
在回答过程中,保持良好的职业心态与技术判断力至关重要:
- 避免盲目站队:不要把面试官的质疑当成技术辩论。认可面试官对稳定性的担忧,这是技术负责人最看重的品质。
- 按业务场景差异化处理:向面试官明确说明,轻量级的离线探索脚本或新搭建的分析服务可以第一时间享受 pandas 3.0 的性能红利;而经过长期验证的核心计费、清结算或自动化交易流水线,必须遵从“如果它没坏,就不要为了追新去修它”的工程审慎原则。
- 用收益证明重构价值:如果老系统确实需要升级,用“内存占用下降一半、Arrow 计算原生加速、多线程读写安全性提升”等可量化的业务价值作为推进重构的支撑,展现出以业务回报为导向的技术大局观。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









