

Python rfind反向查找:怎么截取最后一个分隔符后的文字

发布时间:2026-10-10| 6人浏览过
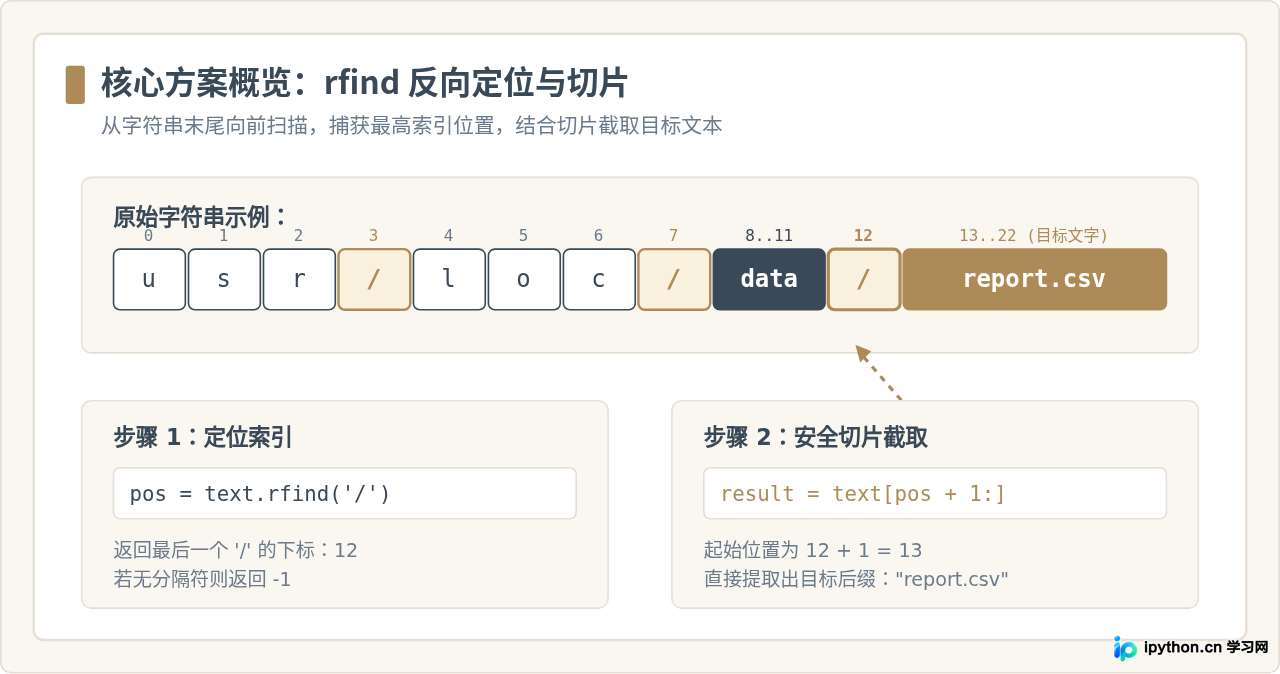
在处理文件路径、网络链接、日志记录或组合编码时,经常需要提取最后一个特定分隔符之后的内容。在 Python 中,最标准且高效的原生方式是使用字符串内置的 rfind() 方法定位最后一个分隔符的索引位置,再利用切片语法截取后面的字符。
核心执行模式只需两行关键逻辑:
pos = text.rfind(sep)
result = text[pos + len(sep):] if pos != -1 else text
一、rfind 方法的工作原理与索引规则
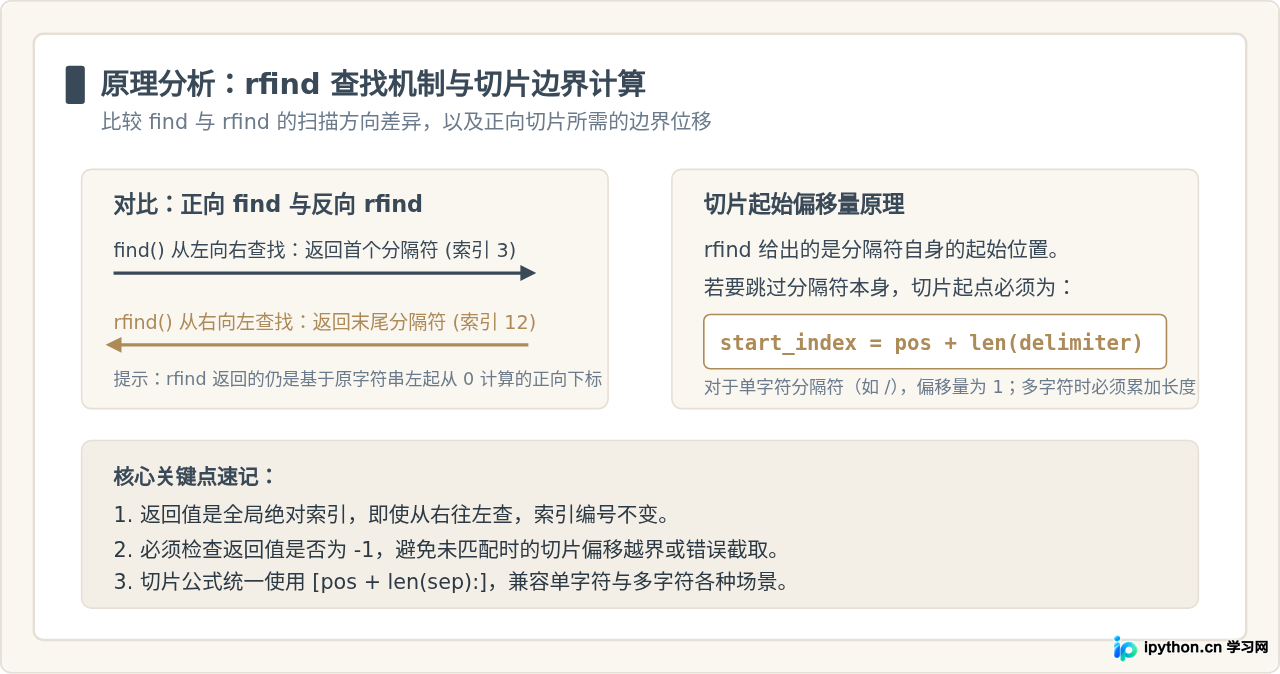
Python 字符串的 rfind() 方法全称为“Reverse Find”,即从字符串的右侧向左侧执行反向查找。它与常规的 find() 方法接受相同的参数,但搜索扫描方向相反,最终返回子字符串在原字符串中出现的最高(最右)索引位置。
该方法的语法定义如下:
str.rfind(sub[, start[, end]])- sub:必需参数,表示要查找的目标子字符串(例如单个字符
'/'或多字符分隔符'::')。 - start 与 end:可选参数,用于限定查找的切片区间。默认从头扫描至末尾。
- 返回值:如果在目标范围内找到该子串,返回匹配项首字符对应的非负整数索引;如果未找到,则固定返回
-1。
二、标准操作步骤与代码实现
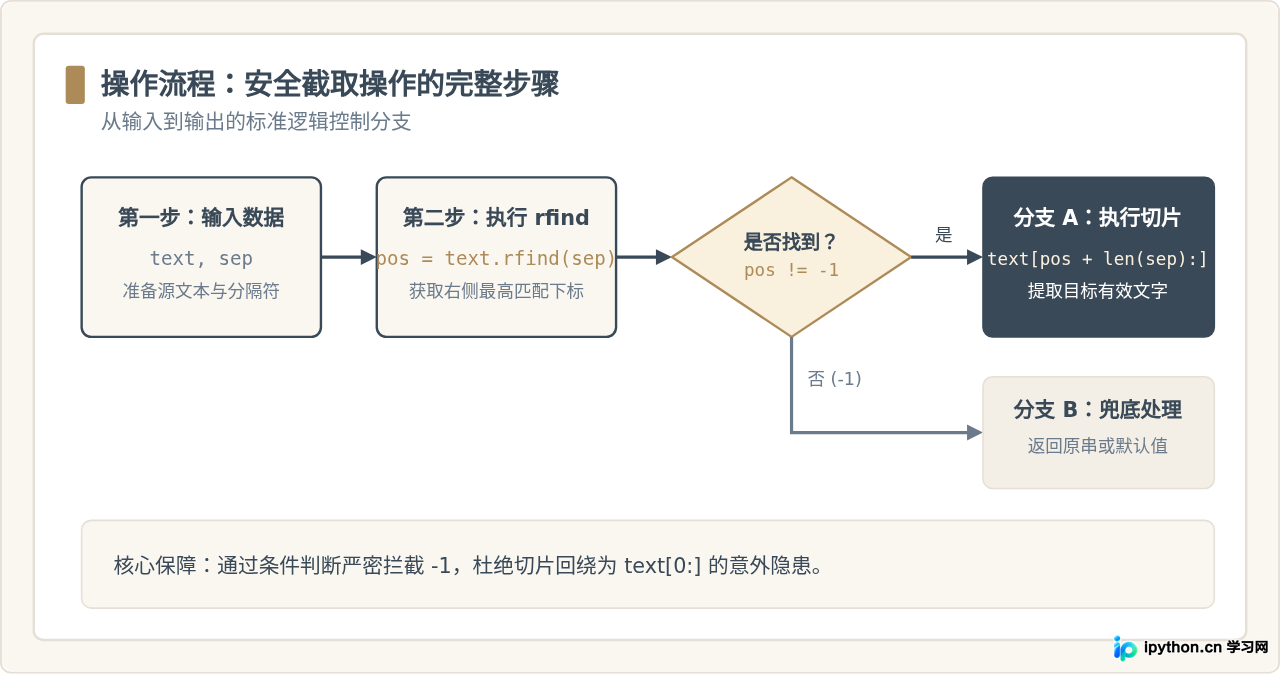
完成截取操作遵循规范的四步流程:指定字符串与分隔符、调用 rfind、验证匹配有效性、执行切片。无论是在交互式终端还是封装在生产函数中,都建议保持严谨的判断。
1. 单字符分隔符场景(例如斜杠、点号)
提取文件名称或扩展名是最常见的情形。如下代码演示从完整文件路径中提取文件名:
path = "/var/log/nginx/access_2026.log"
sep = "/"

pos = path.rfind(sep)
if pos != -1:
    filename = path[pos + 1:]
else:
    filename = path

print("提取结果:", filename)
# 示例输出:提取结果: access_2026.log
2. 多字符分隔符场景(例如命名空间双冒号)
当分隔符长度大于 1(例如 C++ 作用域符 :: 或日志标签 -->)时,起始切片必须加上分隔符本身的长度 len(sep):
token = "com::service::auth::UserToken"
sep = "::"

pos = token.rfind(sep)
if pos != -1:
    leaf_name = token[pos + len(sep):]
else:
    leaf_name = token

print("提取结果:", leaf_name)
# 示例输出:提取结果: UserToken
3. 封装为通用安全工具函数
为了在业务代码中复用并保持健壮性,可以封装为独立函数:
def extract_after_last(text: str, sep: str, default: str = "") -> str:
    """截取字符串中最后一个分隔符之后的文字。

    参数:
        text: 待处理的原始文本
        sep: 分隔符(支持任意长度)
        default: 未找到分隔符时返回的默认值,若传 None 则默认返回原文本
    """
    if not text or not sep:
        return text
    pos = text.rfind(sep)
    if pos == -1:
        return text if default is None else default
    return text[pos + len(sep):]

# 测试用例验证
print(extract_after_last("order-2026-detail", "-"))       # 输出: detail
print(extract_after_last("system_id", ":", default="无")) # 输出: 无
print(extract_after_last("prefix//", "/"))                 # 输出: (空字符串)
三、必须注意的关键边界条件与常见陷阱
虽然语法结构非常简短,但在实际工程应用中,有三个极易被忽视的边界场景容易导致逻辑漏洞:
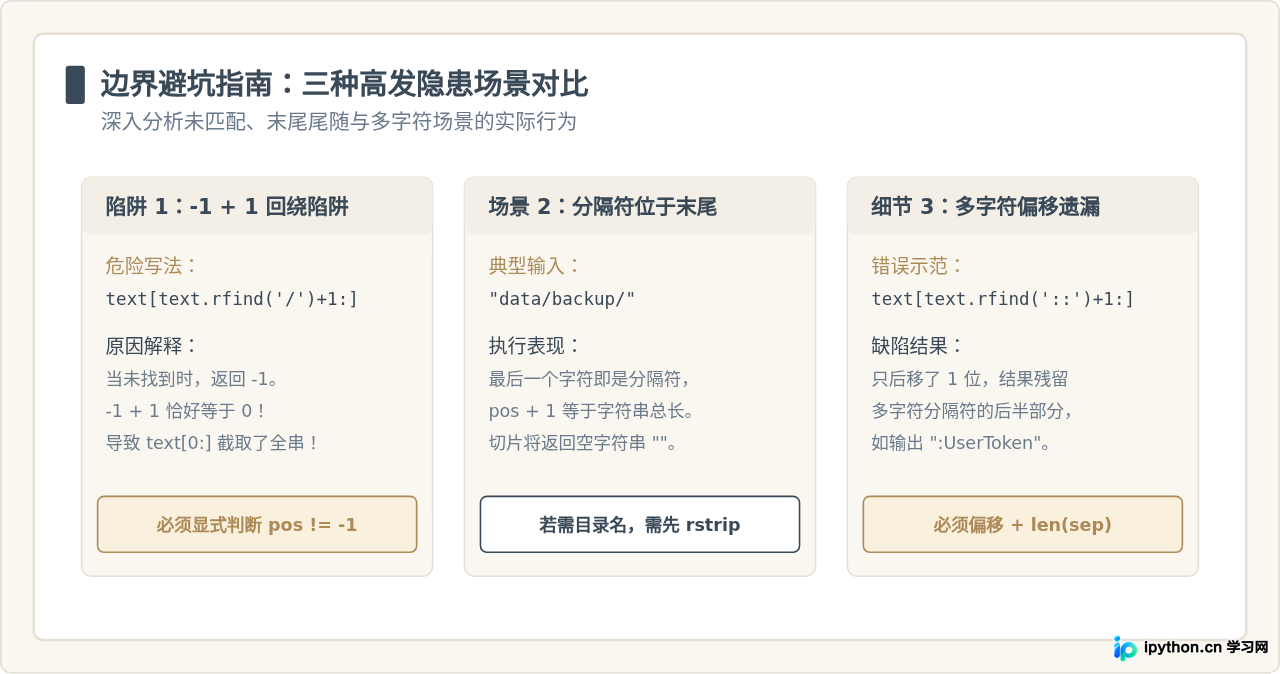
特别警示:“-1 + 1 = 0” 逻辑回绕 BUG
很多开发者为了简写,随手写出 s[s.rfind('/') + 1:]。当字符串中不包含斜杠时,rfind 得到 -1,表达式变成 s[0:],直接将整个原字符串作为截取结果返回。如果业务期望未匹配时返回空串或特定标记,这种写法就会引发隐蔽的数据污染。
四、其他内置方案对比与选型建议
在 Python 中,截取最后一个分隔符后的文字除了 rfind() 外,还有 rpartition()、rsplit() 以及针对路径的专业库。理解它们的机制有助于在合适场景做出最佳技术选型:
| 处理方式 | 典型代码表达 | 未找到分隔符时的表现 | 内存与对象开销 | 最适用场景 |
|---|---|---|---|---|
| rfind() + 切片 | pos = s.rfind('/'); s[pos+1:] |
返回 -1,由开发者完全自定义后续行为 | 极低(仅计算下标与单次字符串切片) | 长文本、高性能要求、定制兜底逻辑 |
| rpartition() | s.rpartition('/')[2] |
返回 ('', '', s),[2] 得到原字符串 |
低(生成包含3个元素的定长元组) | 需要同时获取前缀、分隔符及后缀 |
| rsplit(sep, 1) | s.rsplit('/', 1)[-1] |
返回 [s],[-1] 得到原字符串 |
中等(创建列表并分配元素) | 需要限制拆分次数提取列表 |
| pathlib.Path | Path(s).name |
自动规范化解析 | 较高(构建 Path 对象) | 专门处理跨平台文件路径与扩展名 |
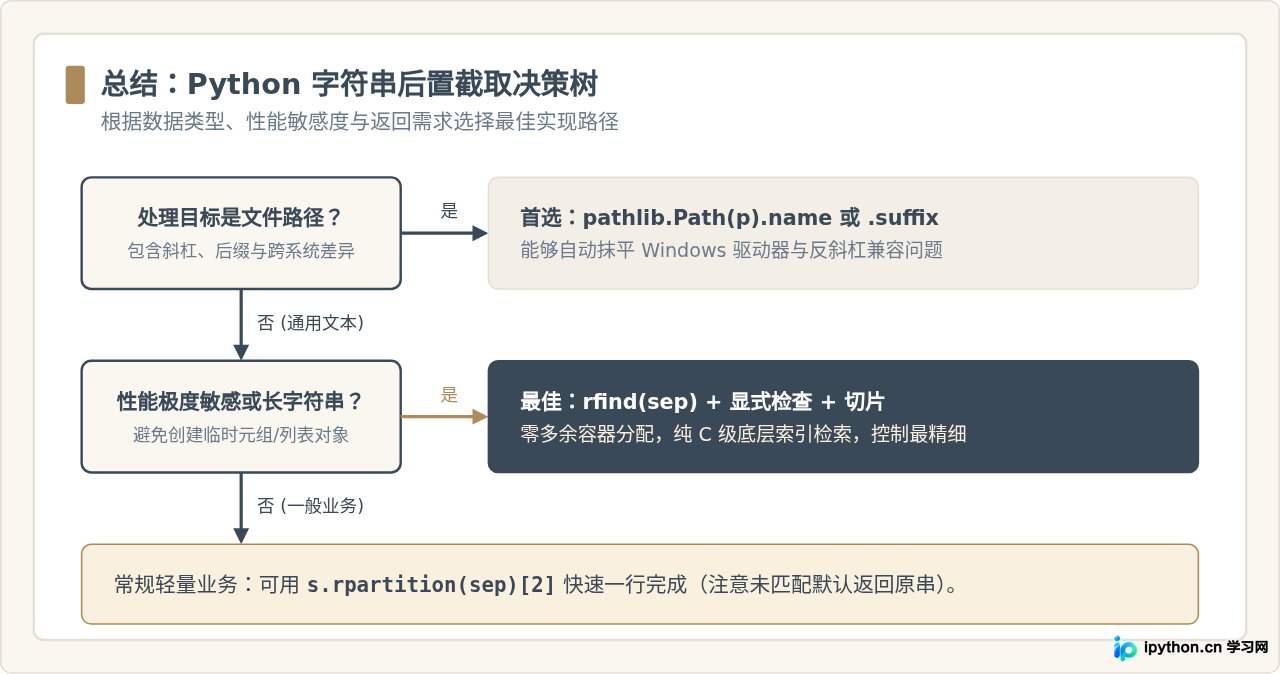
五、全文总结
使用 rfind() 截取最后一个分隔符后的文字,核心在于掌握“反向定位”与“切片偏移”的结合。在日常开发中,牢记以下三点即可写出稳定可靠的代码:
- 反向定位:调用
text.rfind(sep)从右向左寻找最高下标,未找到时稳定返回-1。 - 边界防范:绝不能省略
pos != -1的判断,避免在未匹配时误触发text[0:]全串截取的严重缺陷。 - 通用偏移:切片起始点应统一写为
pos + len(sep),无论是单字符分隔符还是多字符标签,都能精准剔除分隔符并取出干净的尾部内容。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









