

Python爬虫常用库有哪些?Requests、BeautifulSoup与Scrapy功能定位
深入解析Python爬虫生态中Requests、BeautifulSoup与Scrapy的核心功能定位、协作模式及选型依据,帮助开发者理清网络传输、网页解析与工业级框架的职责边界。
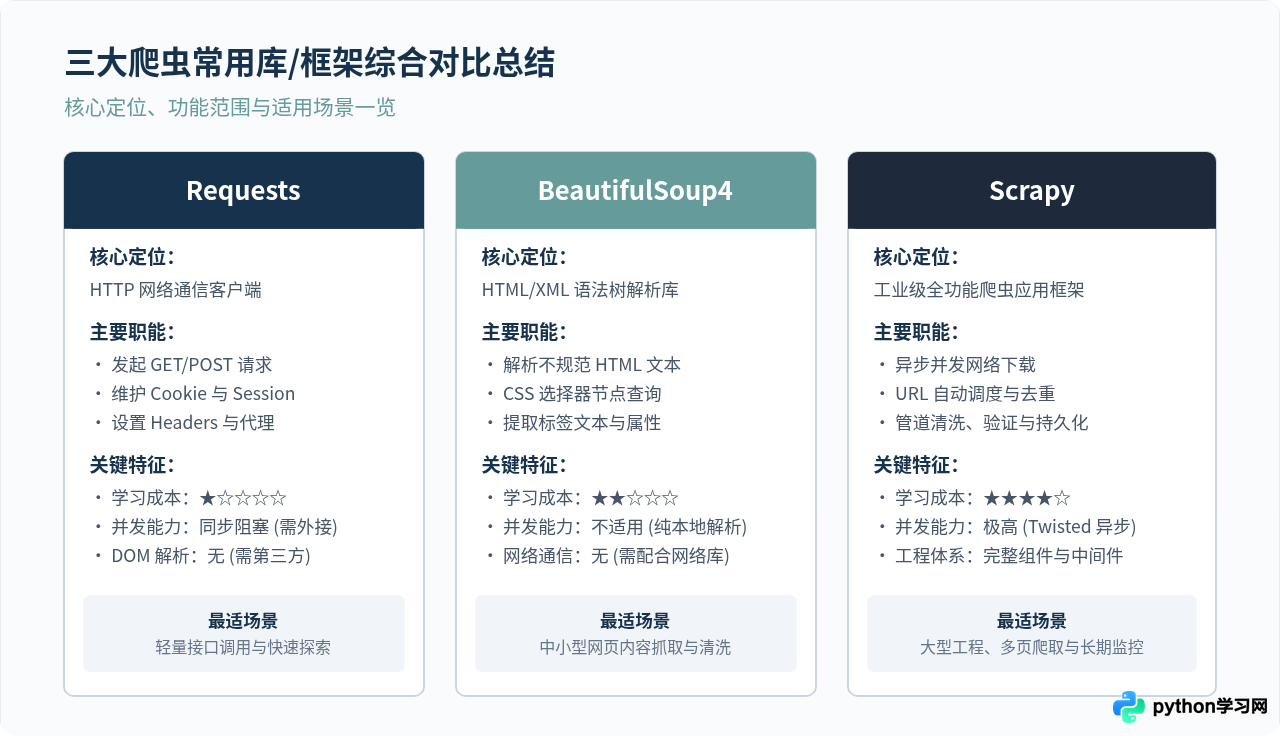
在 Python 爬虫的开发与学习过程中,初学者常会接触到 Requests、BeautifulSoup 与 Scrapy 这三个高频出现的工具,并容易产生它们之间是“替代关系”的误解。实际上,它们分别属于网络爬虫生态中不同层级的组件:Requests 专注于解决底层 HTTP 通信与数据获取,BeautifulSoup 专注于 HTML/XML 语法树的解析与字段提取,而 Scrapy 则是一个集成调度、并发下载与数据清洗入库的工业级全功能应用框架。理解这三者的核心功能定位与边界,是合理构建爬虫项目的基础。
一、核心定位速览:三者在爬虫体系中的层级关系
开发一个爬虫程序,通常包含三个核心阶段:第一步是通过网络协议向目标服务器请求资源(网络传输),第二步是从返回的网页文本或数据流中筛选所需字段(数据解析),第三步是将数据规整并保存到文件或数据库中(持久化存储)。当任务规模进一步扩大时,还需要引入多线程/异步并发控制、URL 队列排重以及防止被目标网站阻断等工程调度机制。
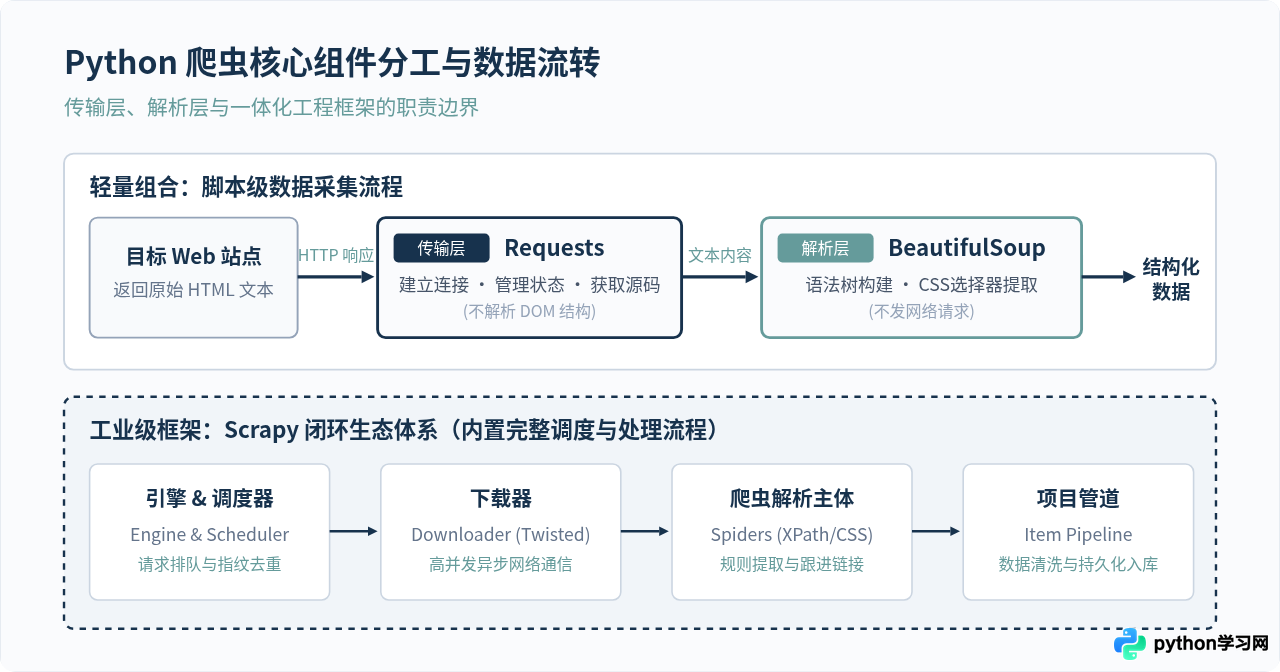
Requests、BeautifulSoup 与 Scrapy 在这套流程中承担的职责截然不同:
- Requests(网络传输层):负责像浏览器一样发送 HTTP/HTTPS 请求,处理请求头(Headers)、Cookie、重定向、代理及认证,获取原始响应数据。它只负责拿数据,不负责分析数据。
- BeautifulSoup(内容解析层):接收 HTML 或 XML 字符串,构建易于遍历查询的 DOM 树对象,提供直观的 CSS 选择器和节点查找方法。它只负责在本地内存中找数据,完全不具备网络收发能力。
- Scrapy(工程框架层):将网络下载、请求队列调度、数据解析规则、中间件拦截以及数据管道(Pipeline)串联成一套标准工作流,底层基于 Twisted 异步事件驱动,天然支持高并发整站抓取。
二、Requests:专注 HTTP 通信的传输利器
在 Python 内置标准库中,urllib 提供了基础的网络请求功能,但其 API 较为繁琐,处理 Cookie 状态维护、重试机制或 SSL 证书验证时需编写较多底层代码。Requests 库的设计哲学是“HTTP for Humans”,它将复杂的网络交互抽象为极为直观的函数调用。
1. 解决的核心问题
- 协议交互:原生封装 GET、POST、PUT、DELETE 等标准 HTTP 请求方法。
- 状态保持:通过
requests.Session()对象自动管理 Cookie,使后续请求能够维持登录或会话状态。 - 请求修饰:便捷设置请求头(如 User-Agent、Referer)、超时限制(timeout)以及网络代理(proxies)。
- 数据反序列化:对于服务端直接返回的 JSON 数据,可直接调用
response.json()完成字典解析。
2. 代码示例:安全规范的请求调用
import requests

url = "https://httpbin.org/get"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

try:
    # 明确设置超时时间,避免请求悬挂
    response = requests.get(url, headers=headers, timeout=10)
    # 校验 HTTP 状态码,若非 200 会抛出异常
    response.raise_for_status()
    # 纠正字符编码,防止中文网页乱码
    response.encoding = response.apparent_encoding

    html_text = response.text
    print(f"请求成功,状态码: {response.status_code},响应长度: {len(html_text)}")
except requests.exceptions.RequestException as e:
    print(f"网络请求失败: {e}")
注意边界:Requests 返回的 response.text 仅仅是一个长字符串。Requests 不知道何为 <div> 标签,也不知道何为标题或超链接。如果需要从中提取指定字段,必须依靠正则表达式、XPath 或专用解析库。
三、BeautifulSoup:专注语法树构建的内容解析专家
当 Requests 把网页 HTML 内容下载到本地后,由于网络上的 HTML 代码往往存在标签未闭合、嵌套错误或排版混乱等问题,纯靠字符串切片或正则表达式匹配极易出错且维护成本极高。BeautifulSoup(通常使用 bs4)的作用,就是将这些 HTML 文本整理成一棵层次分明的对象树。
1. 解决的核心问题
- 语法容错能力强:能够自动修复标签闭合缺失等不规范语法,生成规范的文档对象模型(DOM)。
- 直观的节点查找:支持通过标签名(
find/find_all)、属性字典过滤以及现代化的 CSS 选择器(select/select_one)检索节点。 - 解析器解耦:底层支持配合多种解析器使用,包括 Python 自带的
html.parser、速度更快的lxml,以及容错能力更佳的html5lib。
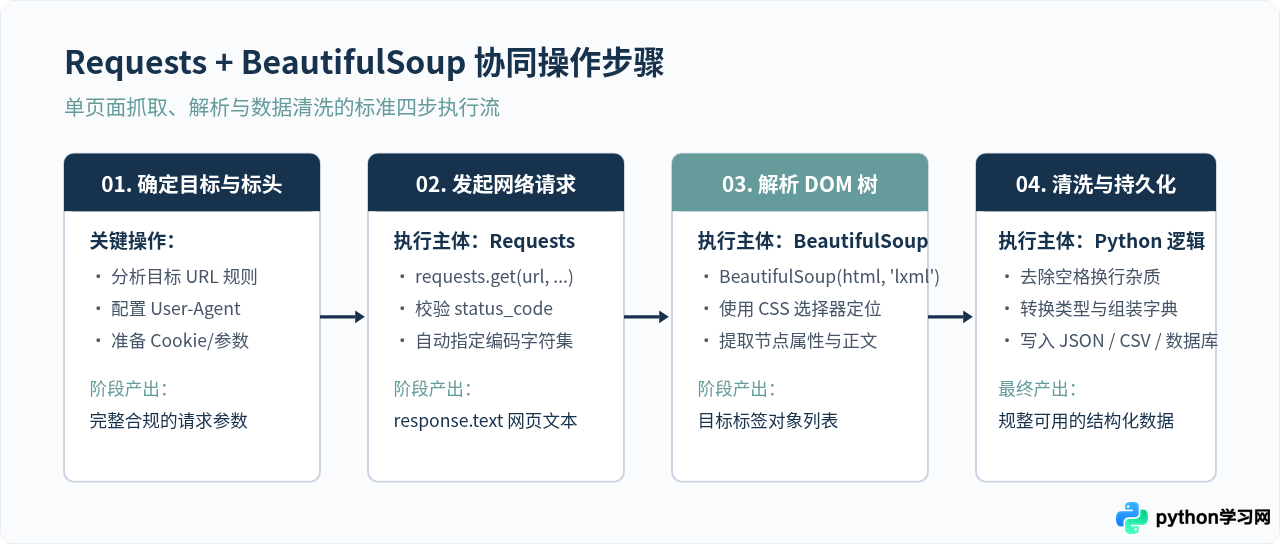
2. Requests 与 BeautifulSoup 协同采集四步法
在实际中小型脚本开发中,Requests 与 BeautifulSoup 几乎总是成对出现,形成“发起请求 → 接收文本 → 构造 DOM → 提取字段”的标准链路。
3. 协同代码示例
from bs4 import BeautifulSoup
import requests

# 1. 模拟抓取网页
sample_html = """
<div class="catalog">
    <article class="card">
        <h3 class="post-title">Python 入门指南</h3>
        <a class="detail-link" href="/post/101">阅读全文</a>
    </article>
    <article class="card">
        <h3 class="post-title">网络爬虫进阶</h3>
        <a class="detail-link" href="/post/102">阅读全文</a>
    </article>
</div>
"""

# 2. 传入 HTML 字符串与解析器
soup = BeautifulSoup(sample_html, "html.parser")

# 3. 使用 CSS 选择器精确定位
extracted_data = []
card_nodes = soup.select("div.catalog > article.card")

for card in card_nodes:
    title_el = card.select_one("h3.post-title")
    link_el = card.select_one("a.detail-link")

    if title_el and link_el:
        extracted_data.append({
            "title": title_el.get_text(strip=True),
            "href": link_el.get("href", "")
        })

print("提取结果:", extracted_data)
四、Scrapy:工业级的一体化高并发工程框架
如果目标仅是抓取几百个简单网页,编写一个包含 Requests + BeautifulSoup 的循环脚本完全足以胜任。但当业务场景升级为百万级整站抓取、需处理复杂的层级页面跳转、网络超时频繁重试、海量 URL 去重以及分布式落库时,自研脚本往往会遇到如下瓶颈:
- 使用同步阻塞模式抓取时效率极低,自行编写多线程或进程池容易引发内存暴增或竞态死锁;
- 缺乏成熟的 URL 状态机和去重机制,程序中断后无法安全断点续爬;
- 缺乏统一规范的代码组织结构,解析代码、请求逻辑与存储代码混合在一起,难以协同维护。
Scrapy 正是为解决这些工程化痛点而生的综合框架。
1. 核心架构与核心组件
Scrapy 采用了经典的模块化架构,各个组件通过 Scrapy Engine(引擎) 协调联动:
- Scheduler(调度器):维护待抓取请求的优先级队列,并负责请求指纹去重(默认通过 SHA1 过滤重复 URL)。
- Downloader(下载器):基于 Twisted 异步事件驱动架构,能够在单线程下同时维持成百上千个并发连接,下载性能极高。
- Spiders(爬虫主体):由开发者编写核心逻辑,定义起始网址、解析规则(内置 Selector,原生支持 XPath 与 CSS)以及提取新链接继续追踪。
- Item Pipeline(项目管道):专门负责接收 Spider 产出的结构化数据,执行数据清洗、合规校验以及写入 MySQL/MongoDB/Elasticsearch 等持久化介质。
- Downloader Middlewares(下载中间件):位于 Engine 与 Downloader 之间,可在此处集中实现动态更换代理 IP、随机轮换 User-Agent、自动化重试或接入无头浏览器等切面逻辑。
2. Scrapy 核心代码结构展示
在 Scrapy 项目中,开发者通常只需继承 scrapy.Spider 并在 parse 回调函数中编写提取规则,网络调度与并发细节全部由底层托管:
import scrapy

class ArticleSpider(scrapy.Spider):
    name = "article_spider"
    allowed_domains = ["example.com"]
    start_urls = ["https://example.com/blog"]

    def parse(self, response):
        # 使用 Scrapy 内置的选择器提取列表
        for card in response.css("div.article-card"):
            yield {
                "title": card.css("h2.title::text").get(),
                "url": response.urljoin(card.css("a.link::attr(href)").get()),
            }

        # 提取下一页链接并自动发起后续请求,交由自身循环解析
        next_page = response.css("a.next-page::attr(href)").get()
        if next_page:
            yield response.follow(next_page, callback=self.parse)
五、技术选型指南:如何根据实际需求做出决策
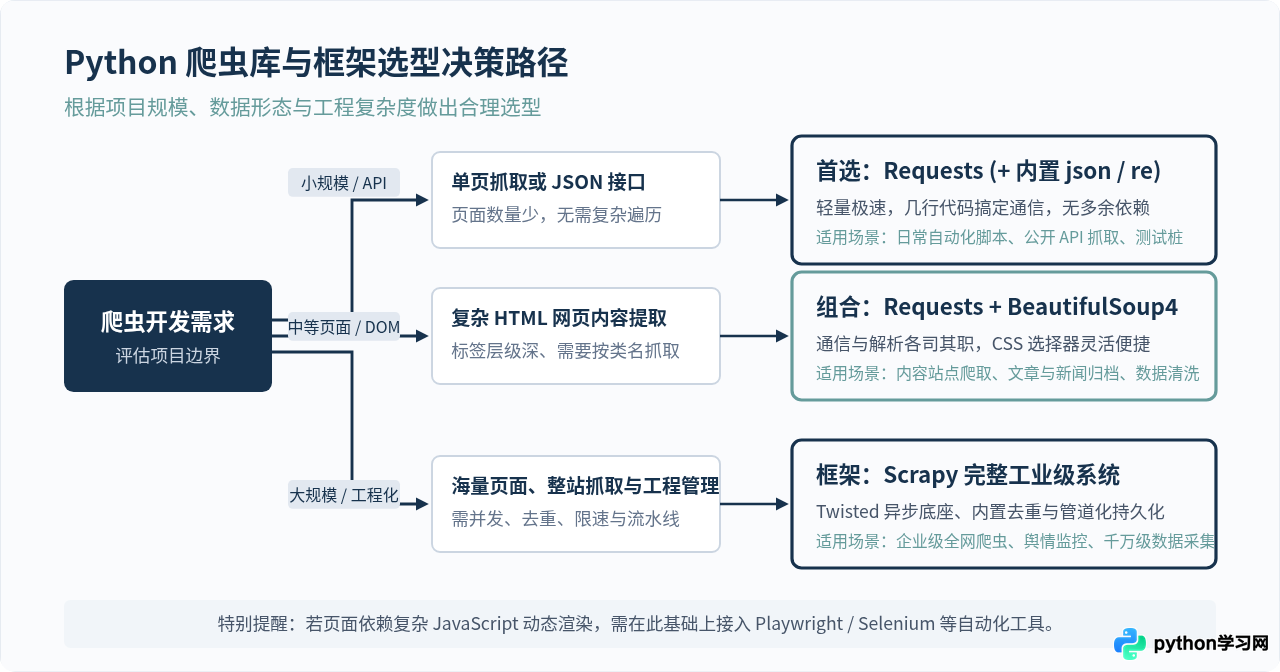
了解了各工具的定位后,在具体项目启动前,可以通过评估“数据规模”、“页面结构形态”与“工程要求”三个核心维度来快速匹配最适合的技术栈。
详细选型建议:
- 单纯接口或少量页面(推荐:纯 Requests):如果目标网站提供直接返回 JSON 格式的后台 API,或者仅需定时抓取特定几个页面的状态,此时引入 BeautifulSoup 或 Scrapy 纯属冗余,直接用
requests.get().json()就能以最小的开销解决问题。 - 中小型内容采集与日常脚本(推荐:Requests + BeautifulSoup):如果目标包含几十到几千个静态 HTML 页面,且排版结构经常调整,使用 Requests 抓取结合 BeautifulSoup 解析是开发效率最高的组合。代码集中在一个 Python 文件中,调试灵活,学习曲线平缓。
- 大规模数据采集与生产级工程(推荐:Scrapy):当抓取规模达到十万、百万级别,或者需要多站点长期监控时,Scrapy 是不二之选。其规范化的项目结构不仅利于团队协作,内置的断点续传、中间件机制和并发控制也能大幅减少维护成本。
六、总结与常见误区解答
常见疑问解答:
问:学会了 Scrapy,是不是就完全不需要学 Requests 了?
答:不是。即使在大型工程中,也经常需要先用 Requests 快速测试某个 API 接口或特定反爬机制,确认请求标头和参数规律后,再将其写入 Scrapy 的 Spider 或中间件中。Requests 是所有网络请求分析的基石。
问:BeautifulSoup 为什么不能像 Requests 那样直接传入 URL?
答:因为职责单一原则。BeautifulSoup 的设计初衷就是纯粹的文档解析器,不绑定任何网络层实现。这使得它不仅能解析网络返回的数据,也能脱离网络解析本地磁盘上的任意 HTML、XML 甚至 SVG 文件。
问:如果网页是 JavaScript 异步渲染的,这三个库能搞定吗?
答:如果页面内容完全由前端 JavaScript 异步计算渲染(如 React/Vue 单页应用),且无法通过逆向抓包直接找到后台 JSON 接口,那么无论 Requests、BeautifulSoup 还是原生 Scrapy 都无法直接执行 JS 代码。此时需要借助 Playwright、Selenium 等浏览器内核驱动工具渲染页面,或者在 Scrapy 中集成 scrapy-playwright 中间件进行无头浏览器渲染与抓取。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









