

为什么AI和数据科学首选Python而不是JavaScript?
深入对比Python与JavaScript在AI与数据科学领域的底层架构、生态库积累、执行机制与实际适用场景,解释为何Python成为该领域首选语言。
在人工智能与数据科学领域,Python处于统治地位,而同样拥有庞大开发者基数与高度优化运行时的JavaScript却主要局限于端侧与轻量推理。核心原因并不在于语法优劣或解释器本身的原始速度,而在于两者在底层内存抽象、高性能C/Fortran底层生态封装、学术研究网络效应以及工作流交互方式上的本质分歧。Python在AI中本质上扮演了高性能原生计算库的调度胶水,而JavaScript则始终受限于为浏览器单线程事件循环与沙箱环境量身定做的运行时架构。
一、底层架构差异:胶水语言 vs 浏览器沙箱运行时
许多初学者容易产生一个直觉偏差:既然V8引擎的JIT(即时编译)性能显著高于标准的CPython解释器,为何大规模张量计算不选择JavaScript?这种疑问混淆了“语言逻辑代码执行速度”与“底层硬件向量化计算能力”的边界。
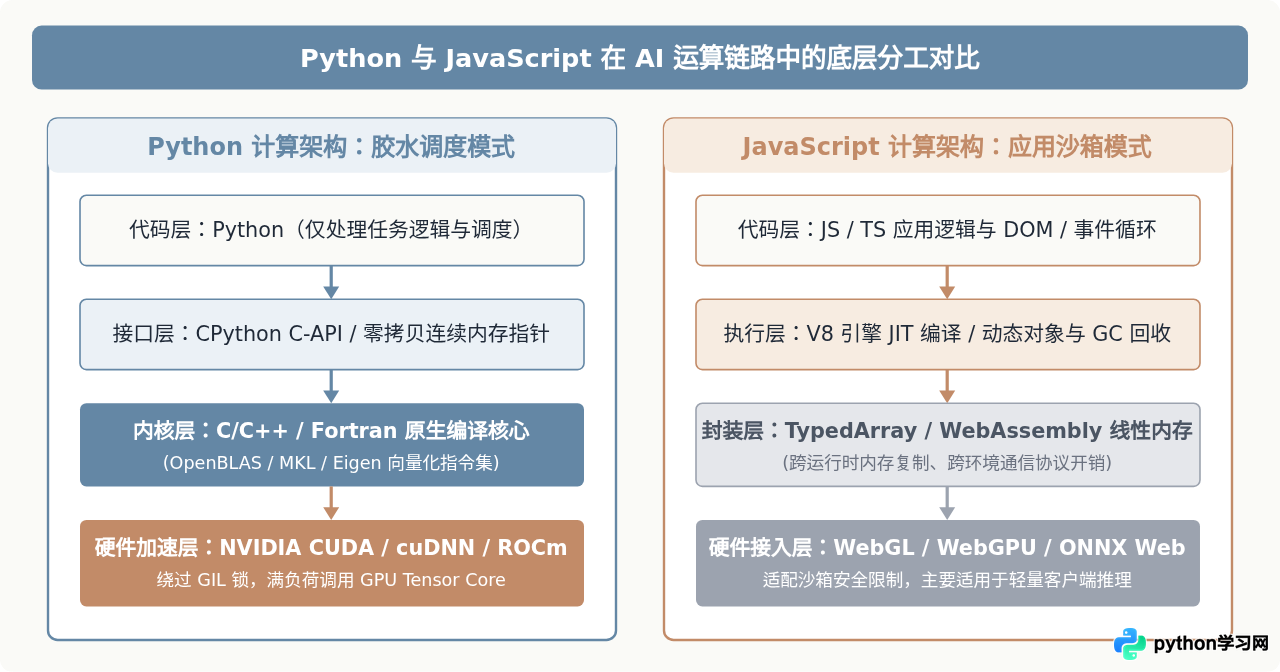
在AI和科学计算中,核心耗时集中在矩阵乘法、卷积运算与反向传播求导。这类运算由底层BLAS、LAPACK库以及NVIDIA CUDA/cuDNN驱动完成,要求数据在内存中以连续平整的内存块(Contiguous Buffer)形式存放,并直接交由SIMD指令集或GPU流式多处理器(SM)并行处理。Python的CPython解释器提供了近乎零成本调用C/C++原生动态库的C-API机制,Python变量仅作为上层引用句柄,真正的重负载计算全程在原生C层甚至GPU显存中进行,无需经过Python虚拟机内部调度。
相比之下,JavaScript最初的设计初衷是浏览器环境下的安全脚本交互。V8引擎为了实现极致的动态对象访问速度,设计了隐式类(Hidden Classes)与分代垃圾回收(Generational GC)。尽管现代JavaScript引入了TypedArray与ArrayBuffer,但与硬件底层的交互仍受到严格约束;更关键的是,Node.js调用原生C++插件的N-API在抽象开销、多维切片与跨语言张量传递的直连便利性上,始终难以匹敌Python与C之间数十年来形成的零拷贝互操作生态。
二、数据科学的全流程推导:从实验到生产的标准范式
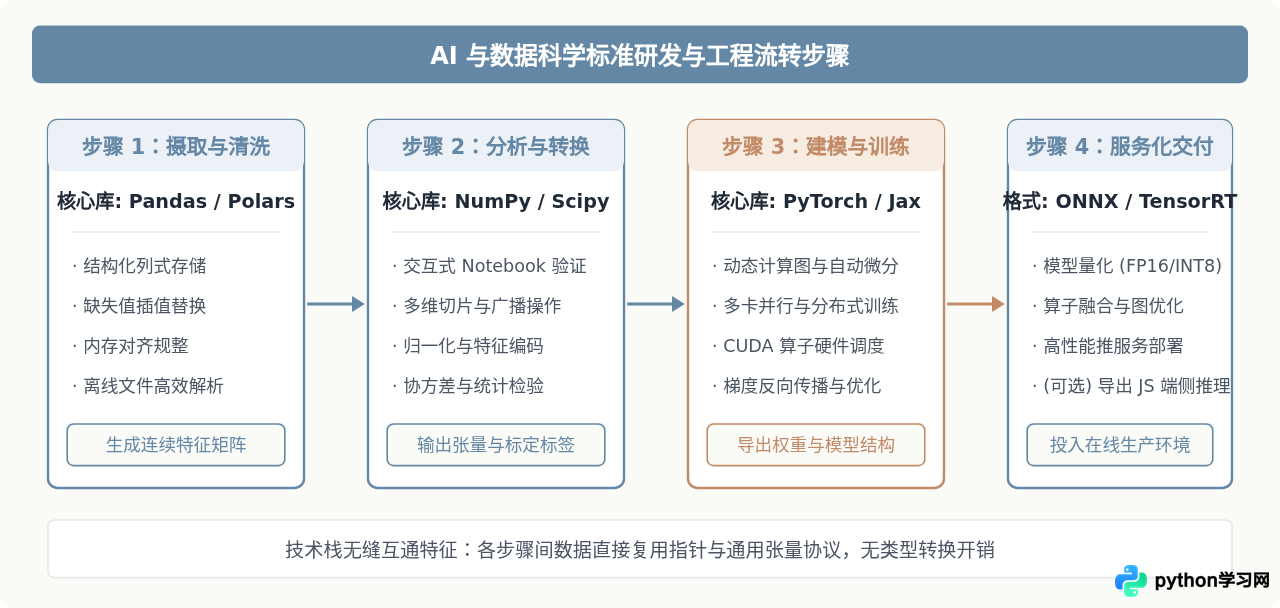
数据科学不是孤立的代码编写,而是一个包含数据提取、清洗转换、探索性分析(EDA)、特征工程、模型训练与验证的完整链条。Python在这一整套流程中提供了严密咬合的标准化工具链。
在数据探索阶段,数据科学家需要实时观察数据分布、快速修改计算公式并即时得到可视化反馈。Jupyter Notebook所代表的交互式计算环境正是围绕Python的核心数据结构建立的。在单行代码执行后,内存状态被持续保留,开发者无需重新加载几个吉字节的数据集即可执行下一步变换。这种工作流完全符合数据探索的试错本质。
以下为一个典型的Python数据转换与矩阵计算代码片段。注意其简洁的切片语法与广播(Broadcasting)机制,所有计算均以向量化方式在C层面完成:
import numpy as np

# 创建两个多维数组(数据在连续物理内存中分配)
features = np.random.randn(100000, 64).astype(np.float32)
weights = np.random.randn(64, 10).astype(np.float32)
bias = np.zeros((10,), dtype=np.float32)

# 矩阵相乘与广播偏置加法:底层由 BLAS 库多线程向量化加速
logits = np.dot(features, weights) + bias

# 条件过滤与切片:不产生冗余数据拷贝,仅生成视图(View)
filtered = logits[logits[:, 0] > 0.5, :5]
print("结果张量形状:", filtered.shape)
如果使用JavaScript完成相同逻辑,即使借助现代类库,开发者通常也要面对ArrayBuffer的手动内存步长(stride)管理,或者依赖多重嵌套循环与map操作。不仅语法冗长,还容易因频繁创建临时小对象而引发V8垃圾回收停顿(GC Pause),从而破坏吞吐率。
三、复利式生态网络与学术界的正反馈闭环
技术选择不仅取决于技术参数,更取决于生态系统的网络效应。在AI领域,这种网络效应体现为极强的“前沿学术成果与开源框架的强绑定”。
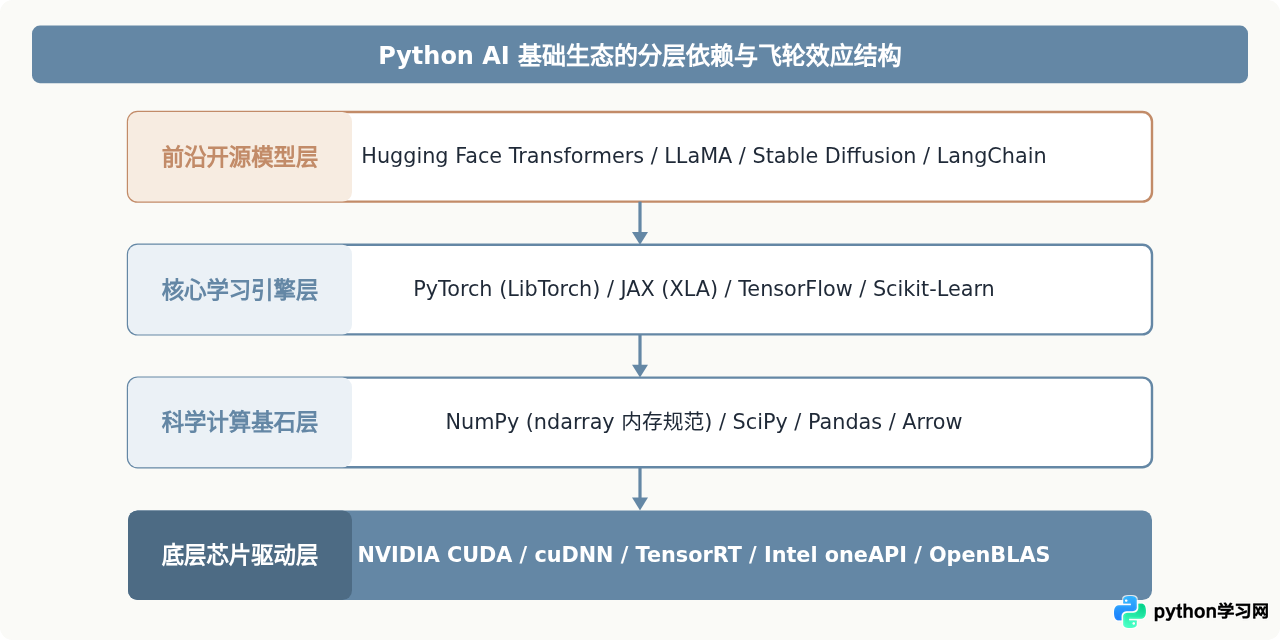
自2012年深度学习爆发以来,学术界绝大多数前沿论文(如Transformer、Diffusion模型、LLM大语言模型)均优先提供PyTorch或JAX的开源实现。研究人员与算法工程师基于已有代码库进行改进,产生新的模块、权重与评估基准,进一步沉淀至Hugging Face等开源社区。这种正反馈机制让Python构筑了牢不可破的壁垒:
- 硬件厂商的一级适配优先级:无论是NVIDIA的CUDA更新、AMD的ROCm适配,还是各类专用AI加速芯片(NPU、TPU),首发SDK与驱动必然先对齐Python框架(PyTorch/TensorFlow/JAX)。
- 算法实现的现货可用性:当一篇突破性论文发布时,数小时内便会有基于Python的代码仓库上线;若使用JavaScript开发,工程师需手动移植数十甚至上百个尚未被JS生态支持的复杂自定义算子,研发成本呈指数级上升。
- 科学计算标准数据结构的统一:在Python中,NumPy的
ndarray与PyTorch的Tensor构成了跨库事实标准。Pandas、OpenCV、Scikit-learn、SciPy之间可以直接传递数据而无缝衔接。在JavaScript中,Math.js、TensorFlow.js以及各种轻量级矩阵库之间缺乏统一的内存与接口契约。
技术边界提示:生态优势并非不可动摇的语言神话,而是历史沉淀带来的高昂迁移成本。如果仅做逻辑推理或简单统计,任何通用语言均可胜任;但一旦进入数十亿参数大模型微调或高维张量密集训练,缺乏硬件加速库深度绑定的语言在开发人时与算力成本上均处于绝对劣势。
四、语法与心智模型:数学表达 vs 事件驱动交互
语言本身的语法哲学与心智模型(Mental Model)深刻影响了开发者的认知负荷:
- 操作符重载与数学符号直觉:数据科学充斥着多维张量变换。Python原生支持操作符重载(如
@操作符直接表示矩阵乘法,A * B表示逐元素哈达玛积,切片语法[:, None]调整维度)。这使数学论文中的公式能够近乎1:1地翻译成代码。而JavaScript不支持操作符重载,所有矩阵操作必须写成冗长的方法链式调用,例如tensorA.matMul(tensorB).add(bias),在复杂多项式计算中极易降低可读性。 - 同步阻塞式计算与事件驱动的冲突:数据科学实验主要是批处理与线性的计算流程(加载数据 -> 计算梯度 -> 更新权重),这种任务天然是CPU/GPU密集型的长阻塞任务。JavaScript的强项在于非阻塞I/O(并发处理高频网络请求与UI渲染交互)。如果在Node.js主事件循环中执行耗时数百毫秒的张量计算,会直接导致整个主线程严重卡顿。虽然可以通过Worker Threads解决,但线程间传递大体积ArrayBuffer的数据共享与同步开销大大增加了编码复杂度。
五、客观审视:JavaScript在AI中的实际角色与选型边界
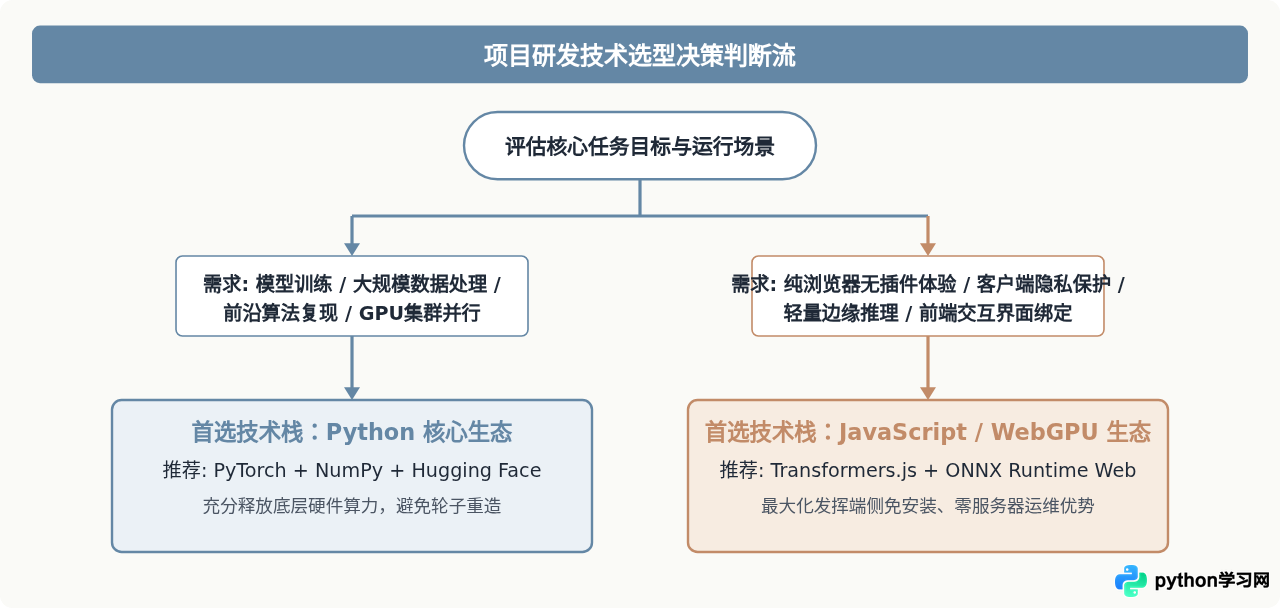
判断技术选型不能采取非此即彼的绝对化视角。JavaScript在AI领域并非毫无立足之地,而是与Python形成了清晰的“分工协作”关系:
| 对比维度 | Python | JavaScript / TypeScript |
|---|---|---|
| 核心适用阶段 | 数据探索、清洗、模型训练、分布式微调、服务端高性能推理 | 前端界面交互、端侧边缘推理、轻量模型部署、Agent可视化接入 |
| 代表性框架 | PyTorch, NumPy, Pandas, Scikit-Learn, JAX | TensorFlow.js, ONNX Runtime Web, Transformers.js |
| 硬件加速途径 | 原生CUDA, ROCm, TensorRT, 汇编优化BLAS | WebGL, WebGPU, WebAssembly (Wasm) |
| 算力利用率 | 极高(直接调度硬件物理单元,几乎无虚拟化损耗) | 中等(依赖浏览器/Node沙箱映射与着色器转换) |
| 隐私与端侧优势 | 依赖服务端计算环境或本地完整Python解释器 | 零安装即开即用、数据完全保留在用户本地浏览器 |
在实际工程中,团队往往采用“Python负责训与优,JavaScript负责端与用”的双轨架构:数据团队与算法工程师在Python环境下产出模型并导出为通用的ONNX权重,前端或全栈工程师则借助ONNX Runtime Web或WebGPU在客户端完成隐私计算或零延迟实时交互体验。
六、总结与核心结论
AI和数据科学首选Python而非JavaScript,并非某一种语言在绝对语法设计上的胜出,而是两种技术路线在演进目标上的必然分流:
- Python演化为高性能底层加速库的控制台:它通过完备的C-API将运算完全交托给底层的物理显卡与高密度数学库,结合直观的数学操作符与交互式探索环境,成为了研究人员与工程师表达算法的最短路径。
- JavaScript立足于普适的应用触达终端:它以事件循环与沙箱隔离保障了网络交互的高效与安全,更适合作为经过量化蒸馏后的AI模型在终端用户侧的落地承载者。
理解这种分工有助于建立客观的技术选型意识:在需要大规模探索、深度训练与矩阵高性能吞吐的研发环节,坚定选用Python;而在模型发布后需要极低门槛触达数以亿计普通用户、或在浏览器内实现纯客户端交互时,合理借力JavaScript的端侧生态。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









