

在VS Code中配置Python以完美支持中文标识符和注释
详细介绍在 Visual Studio Code 中配置 Python 开发环境以完美支持中文变量名、中文函数名及中文注释的具体操作步骤,涵盖文件编码、编辑器字体、静态分析工具与终端运行时的完整解决方案。
自 Python 3 起,语言规范本身已在源码级别全面支持 UTF-8 编码,并通过 PEP 3131 正式允许在变量名、函数名与类名中使用非 ASCII 字符(包括中文字符)。但在日常使用 Visual Studio Code 开发 Python 时,开发者依然经常面临中文注释保存乱码、中文变量在代码检查器中误报、光标在全角文字处错位漂移以及控制台输出问号或解码异常等问题。要达到“完美支持”的状态,需要同时在源码文件编码、编辑器文本渲染、语言服务器(Pylance/Linter)解析规则与终端执行环境四个环节保持统一配置。
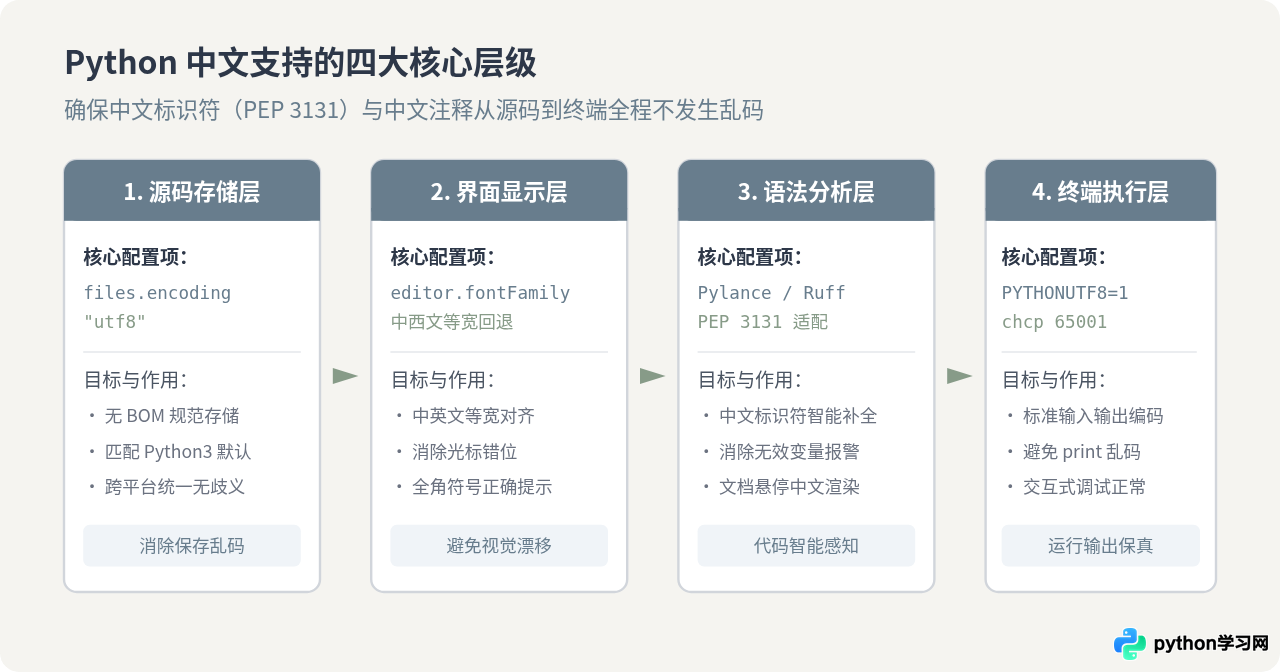
一、源码文件存储:锁定标准 UTF-8 编码
Python 3 解释器默认将源码视作标准 UTF-8 编码读取(参见 PEP 3120)。在 Windows 系统上,若文本编辑器默认采用 ANSI/GBK 编码保存文件,或保存为带字节顺序标记的 UTF-8 with BOM,可能会导致 Python 解析器异常或跨平台协作时版本控制系统报出文件冲突。
进入 VS Code 设置,打开全局或工作区 settings.json 配置文件,添加以下三项关键配置:
{
  // 强制全局及新文件统一使用不带 BOM 的标准 UTF-8
  "files.encoding": "utf8",

  // 针对 Python 语言特别锁定,避免因语言插件覆写导致偏差
  "[python]": {
    "files.encoding": "utf8"
  },

  // 保持为 false。开启自动猜测容易把较短的中文 UTF-8 文件误判为 GB2312
  "files.autoGuessEncoding": false
}
完成设置后,打开任何 .py 文件时,查看 VS Code 窗口右下角状态栏。如果显示为 UTF-8,说明配置已生效。若显示为 GBK 或其他编码,可直接点击状态栏的编码名称,选择“通过编码保存”(Save with Encoding),指定为 UTF-8 完成转换。
二、UTF-8 与 GBK 编码模式的对比分析
在中文编程环境下,很多遗留项目或早期 Windows 教学环境常混合使用 GBK 编码。理解两种编码在当前生态中的关键差异,有助于规避隐藏的运行期故障:
| 对比维度 | 标准 UTF-8(无 BOM)模式 | GBK / CP936 模式 |
|---|---|---|
| Python 官方规范 | PEP 3120 钦定默认源码编码,无需文件头部声明 | 必须在文件首行或次行添加 # -*- coding: gbk -*- |
| 中文标识符支持 | 完整支持 PEP 3131 Unicode 变量名与函数名 | 在多字节边界切分时可能引发解析器 SyntaxError |
| 跨平台行为 | macOS、Linux、Windows、Docker 容器一致无差别 | 仅在中文 Windows 下生效,部署至 Linux 服务器直接乱码 |
| Git 协作 | Diff 差异高亮精准,提交日志与内容皆无损 | 极易在合并冲突时发生双字节截断,导致代码损坏 |
三、集成终端与执行环境:解决控制台中文乱码
许多开发者在 VS Code 编辑器中输入中文很正常,但点击右上角运行按钮后,集成终端输出的中文变成了 ??? 或乱码字符。出现该现象的核心原因在于 Windows 控制台默认代码页通常为 936(GBK),而 Python 解释器在标准输出重定向到伪终端时,默认采用了操作系统的默认区域编码。
从 Python 3.7 开始,官方引入了 PEP 540(Python UTF-8 Mode)。通过配置 VS Code 终端环境变量,可以强制 Python 在终端执行期间全链路使用 UTF-8 编码流,无需修改全局 Windows 系统区域设置。
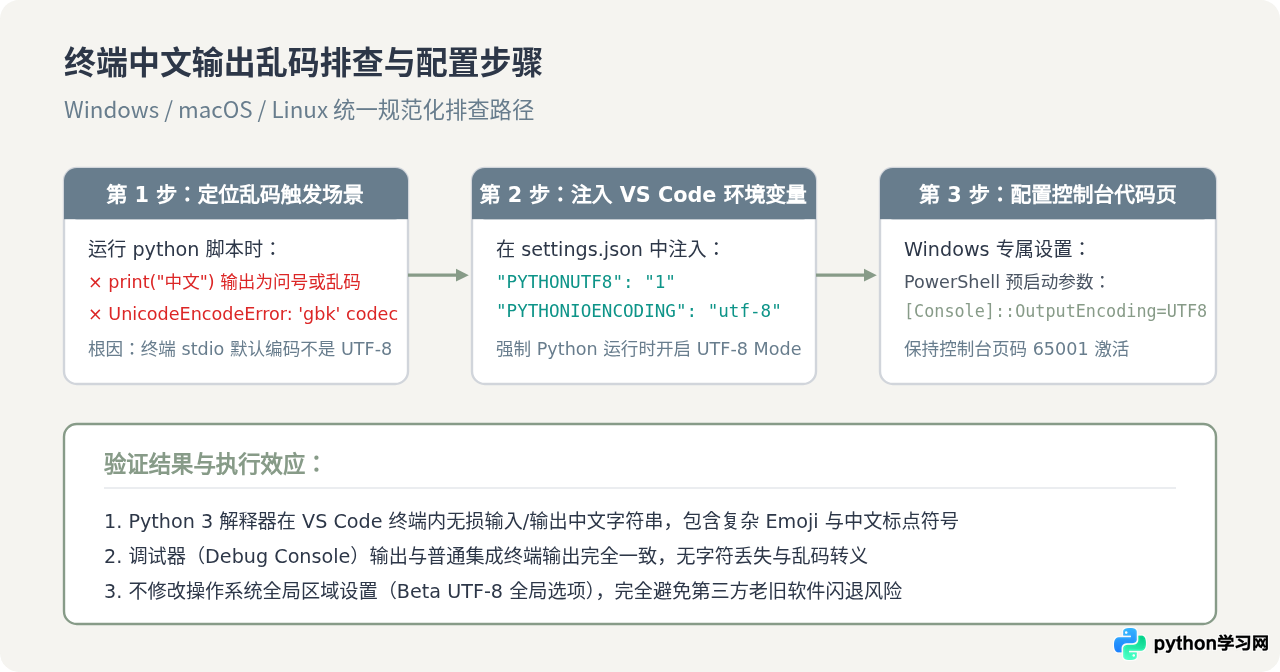
将以下终端集成配置加入 VS Code 的 settings.json:
{
  // 为集成终端注入环境变量,强制 Python 开启 UTF-8 Mode
  "terminal.integrated.env.windows": {
    "PYTHONUTF8": "1",
    "PYTHONIOENCODING": "utf-8"
  },
  "terminal.integrated.env.linux": {
    "PYTHONIOENCODING": "utf-8"
  },
  "terminal.integrated.env.osx": {
    "PYTHONIOENCODING": "utf-8"
  }
}chcp 65001 将当前控制台会话切换为 UTF-8 代码页。
四、代码智能分析与 Lint 工具链适配
编写包含中文标识符的代码时,现代 Python 语言服务器与代码静态检查工具的态度有所不同。官方推荐的 Pylance 插件已完全兼容 PEP 3131,不仅能正常索引中文变量名、函数名与类名,还能在快速补全、代码悬停文档(Hover Info)与重构重命名中稳定工作。
但部分传统或默认配置严苛的代码质量检查工具(如旧版 Flake8、Pylint)可能会将非 ASCII 字符标记为不符合命名惯例,或将中文标点误判为语法错误。现代 Python 生态更推荐使用 Ruff 或专门针对 PEP 3131 调优的规则集。
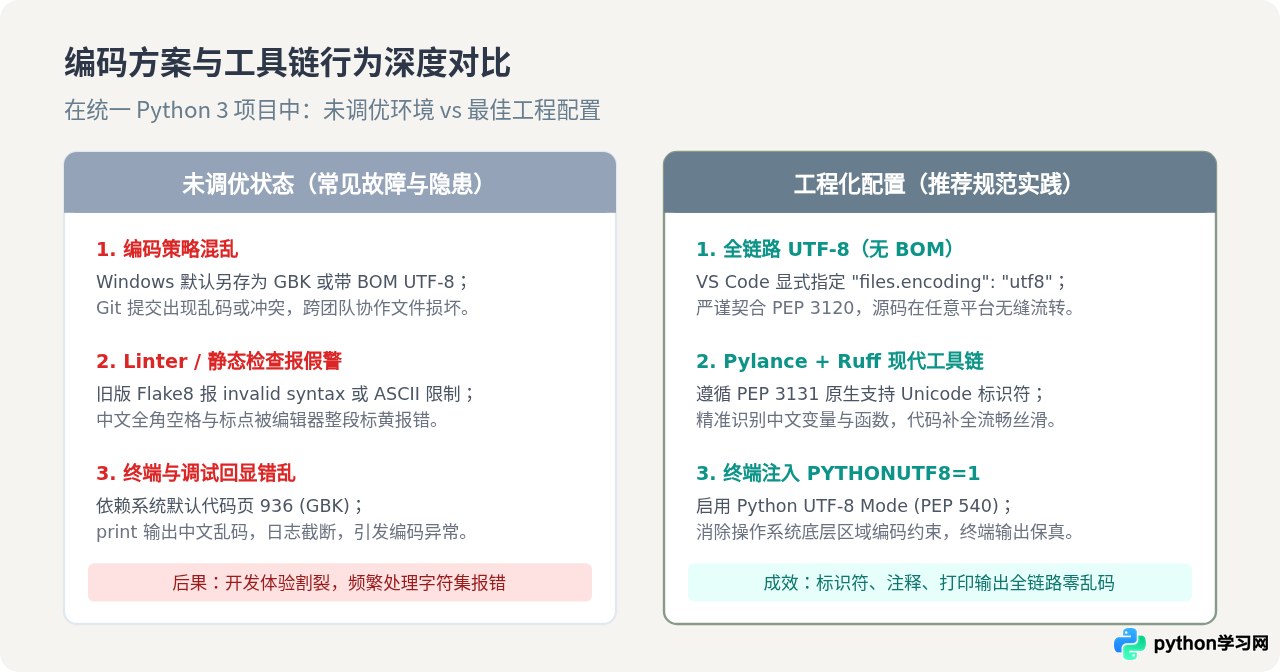
若在项目中使用 Ruff 作为静态检查与格式化器,在 pyproject.toml 中加入以下规则抑制对非 ASCII 标识符的误告警:
[tool.ruff.lint]
# 忽略 RUF001, RUF002, RUF003(用于豁免中文标点、全角符号及注释中的 Unicode 提示)
ignore = ["RUF001", "RUF002", "RUF003"]
五、编辑器字体与视觉渲染调优
在编写中英文混排代码与中文注释时,常见的视觉痛点是“光标位置错位”:光标停在中文文字中间,或者删除一个字符时光标跳跃幅度不对。这是由于编辑器主字体仅包含英文字符,系统在回退渲染中文字体时,两者字宽未按标准 1:2 等宽比例对齐导致的。
此外,VS Code 自带的 Unicode 高亮功能(Unicode Highlight)在默认情况下会将全角空格、中文引号等字符用黄框圈出,干扰阅读。可通过以下配置获得干净且舒适的编辑体验:
{
  // 推荐字体序列:英文字体在前,优秀的中文字体紧随其后作为回退
  "editor.fontFamily": "'JetBrains Mono', 'Cascadia Code', 'PingFang SC', 'Microsoft YaHei', 'Noto Sans Mono CJK SC', monospace",

  // 保证编辑器使用标准字宽计算
  "editor.letterSpacing": 0,

  // 优化 Unicode 字符突出显示设置
  "editor.unicodeHighlight.invisibleCharacters": true,
  "editor.unicodeHighlight.ambiguousCharacters": false, // 关闭对常见中文字符的歧义警报
  "editor.unicodeHighlight.allowedCharacters": {
    ":": true,
    ";": true,
    "“": true,
    "”": true,
    "‘": true,
    "’": true,
    "(": true,
    ")": true,
    "【": true,
    "】": true
  }
}
六、完整配置清单与实测验证
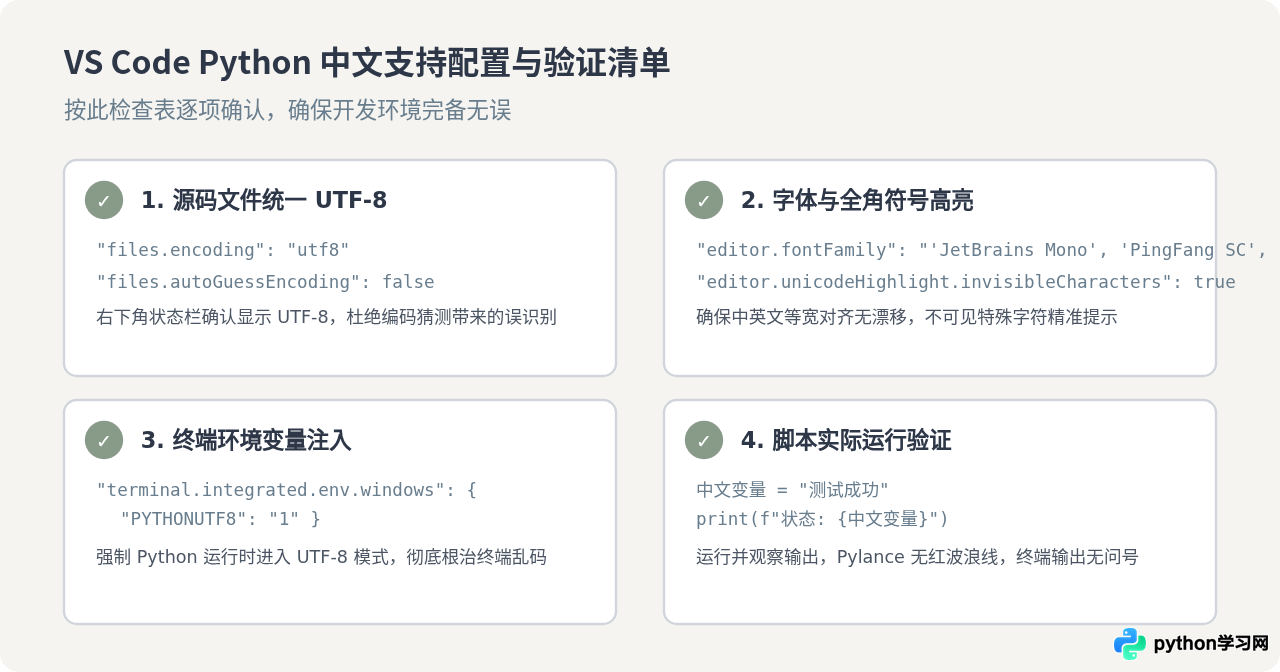
经过上述所有维度的调优,在 VS Code 中可以通过创建一个包含中文类、中文函数、中文变量及中文注释的完整测试脚本进行验证:
# -*- coding: utf-8 -*-
"""
模块说明:测试 VS Code 下 Python 中文标识符与注释支持
"""

class 学生信息:
    def __init__(self, 姓名: str, 年龄: int):
        self.姓名 = 姓名
        self.年龄 = 年龄

    def 获取简介(self) -> str:
        # 返回格式化中文描述信息
        return f"学生姓名:{self.姓名},年龄:{self.年龄} 岁"

if __name__ == "__main__":
    张三 = 学生信息("张三", 18)
    print("【执行结果】")
    print(张三.获取简介())
在 VS Code 中运行该脚本,若能同时满足以下条件,则表明配置已达到完美状态:
- 语法感知正常:输入
张三.时,Pylance 能立即弹出姓名、年龄和获取简介的自动补全下拉菜单。 - 静态检查通过:编辑器没有出现红色或黄色波浪线警告,悬停在
获取简介上能完整展示中文文档注释。 - 终端输出正确:终端清晰打印出
【执行结果】和学生姓名:张三,年龄:18 岁,没有任何问号或乱码。
七、边界场景与特别注意事项
- Unicode 正规化差异(NFC 与 NFD):macOS 文件系统在历史上默认采用 NFD(规范分解)存储文件名,而 Linux 与 Windows 常用 NFC(规范重组)。如果你的 Python 模块文件名使用了中文并被其他文件
import引用,在跨平台 Git 检出时可能出现找不到模块的现象。在标识符命名中,Python 解释器在内部统一会将 Unicode 标识符转为 NFKC 正规化形式,但建议项目模块文件名尽量维持 ASCII 字符,仅在模块内部变量名、函数名与业务逻辑中使用中文标识符。 - 第三方 C 扩展与底层库:部分基于 C/C++ 封装的底层第三方库(例如早期未经 Unicode 包装的底层驱动或老旧数据连接器)可能仅接受 ANSI 字节流,在此类场景中向底层传参时需显式使用
.encode('gbk')或对应编码进行防御性处理。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









