

Python装饰器是什么:通俗解释与核心原理
深入浅出解析Python装饰器的本质与核心原理,涵盖高阶函数、闭包机制、@语法糖推导、带参数装饰器及functools.wraps实战细节。
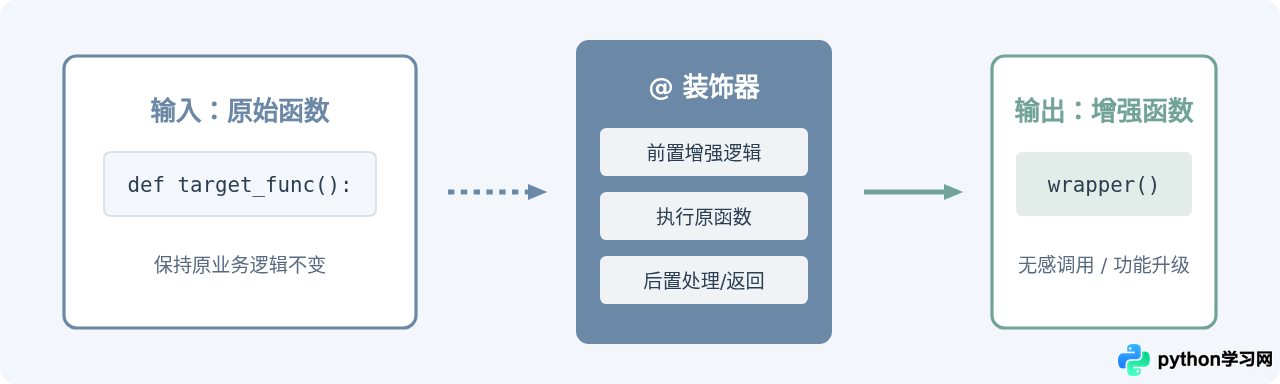
在 Python 中,装饰器(Decorator)本质上是一个接收函数作为输入、并返回一个增强版新函数的可调用对象。它的核心目的,是在不改动原函数源码和原函数调用接口的前提下,为原函数动态追加额外的功能(例如计时、日志记录、权限鉴权或结果缓存)。理解装饰器的关键,在于掌握 Python 中“函数是一等公民”这一特性,以及由高阶函数和闭包构成的底层运行机制。
一、通俗理解:给函数穿一件“定制外衣”
如果用生活中的物品打比方,装饰器非常类似于手机壳或防弹玻璃保护膜。手机本身的核心功能是通话、上网和运行软件;给手机套上一个保护壳后,手机的核心功能丝毫没有改变,但它额外获得了防摔、防水或者磁吸的新特性。使用者在拨打电话时,操作方式与之前完全一致,并不需要关心保护壳内部是怎样缓冲受力的。
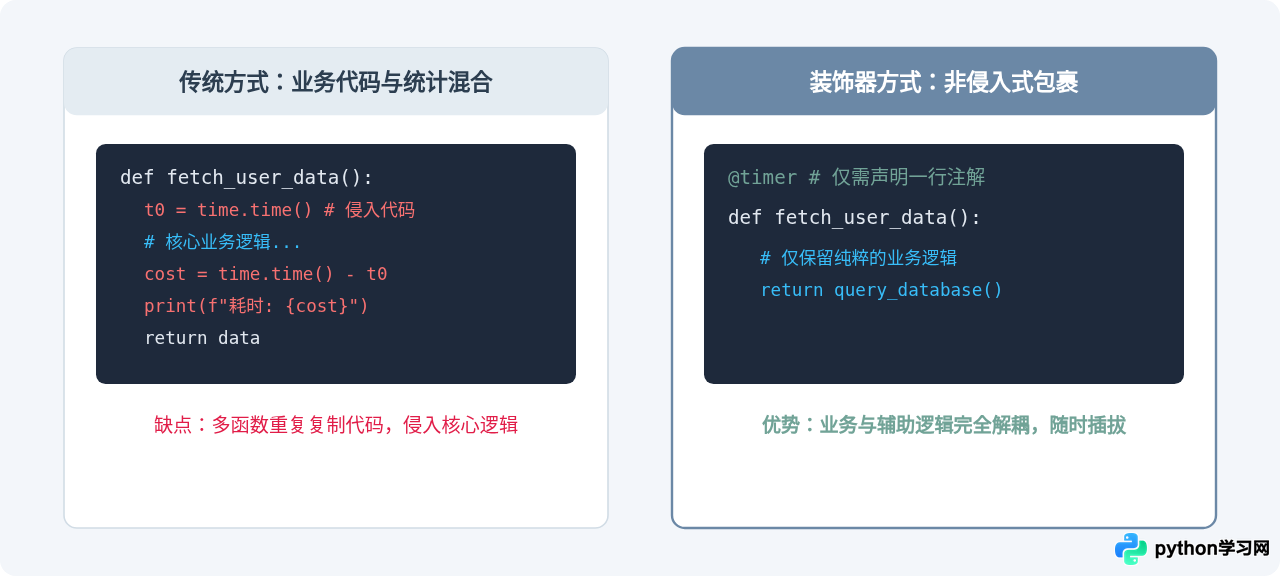
回到代码场景:假设系统中有多个核心业务函数,现在需要统计每个函数的执行耗时。最直接但最糟糕的做法,是逐一进入每个函数内部,在开头记录起始时间,在末尾计算时间差并打印日志。这种做法不仅破坏了原有业务代码的纯粹性,还在多处产生大量重复代码。装饰器就是为了解决这一矛盾而生的设计模式:将横切关注点(如耗时统计)抽取出来做成一件“外衣”,按需套在目标函数外部。
二、语法糖解密:@ 符号的底层推导与执行步骤
很多初学者觉得装饰器神秘,主要原因是 Python 提供的 @ 符号看起来像是一种特殊的语法黑盒。事实上,@ 在 Python 中被称为“语法糖”(Syntactic Sugar),它并没有引入任何新的运行机制,仅仅是一种让代码更加简洁紧凑的书写形式。
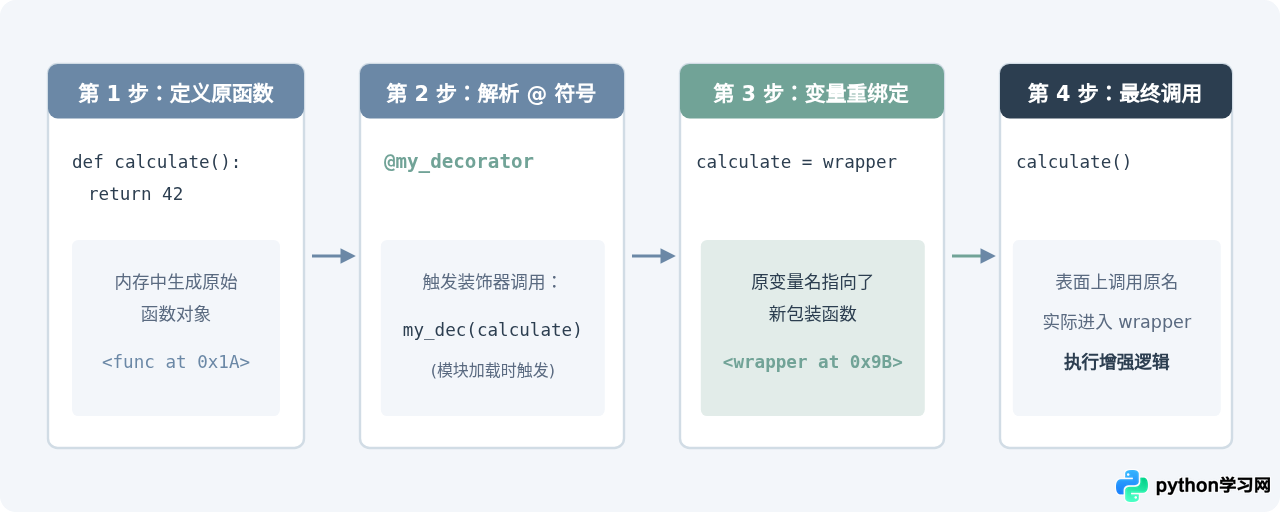
当我们在一个函数定义前写下 @timer 时,Python 解释器在编译加载该模块的瞬间,会自动执行一次赋值重绑定:
# 语法糖写法
@timer
def my_func():
    pass

# 等价于原生写法:
def my_func():
    pass

my_func = timer(my_func)
也就是说,解释器先定义好最初的 my_func 对象,然后将其作为实参传给函数 timer(),再把 timer() 返回的结果重新赋值给变量名 my_func。从这一刻起,外部调用 my_func() 时,执行的已经是经过包装后的新函数对象了。
三、装饰器的底层运行原理:闭包与高阶函数
为什么 Python 可以实现“把一个函数包起来并返回新函数”的操作?这依赖于 Python 语言底层的两项核心机制:
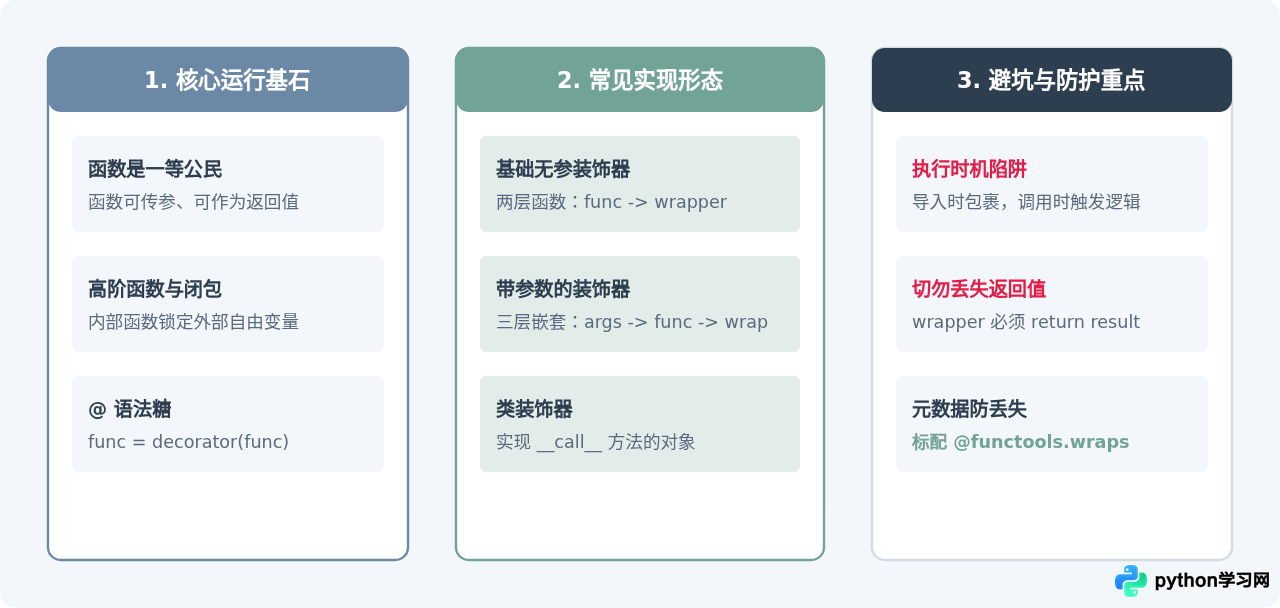
- 函数是一等公民(First-Class Citizens):在 Python 中,函数与整数、字符串一样都是对象。函数名只是指向该对象的引用。因此,函数可以作为参数传给另一个函数,也可以作为一个函数的返回值。接收函数作为参数或返回函数的函数,被称为高阶函数(Higher-Order Function)。
- 闭包(Closure):当一个嵌套在内部的函数引用了外部函数作用域中的变量(包括外部函数的实参),并且外部函数将这个内部函数返回时,就形成了一个闭包。即使外部函数已经执行完毕退出了调用栈,内部函数依然牢牢“记住”并锁定了外部函数传递过来的环境与变量。
编写一个通用的装饰器模板
为了让装饰器能够装配在任意函数上,包装函数必须能够透明接收任意数量的位置参数与关键字参数,并且必须显式返回原函数的执行结果:
import time

def timer(func):
    # wrapper 通过闭包捕获了外部作用域的 func 对象
    def wrapper(*args, **kwargs):
        start_time = time.time()

        # 1. 执行原函数并获取返回值
        result = func(*args, **kwargs)

        # 2. 执行后置统计逻辑
        cost = time.time() - start_time
        print(f"[日志] {func.__name__} 执行耗时: {cost:.4f} 秒")

        # 3. 必须返回原函数的结果,否则调用方会得到 None
        return result

    return wrapper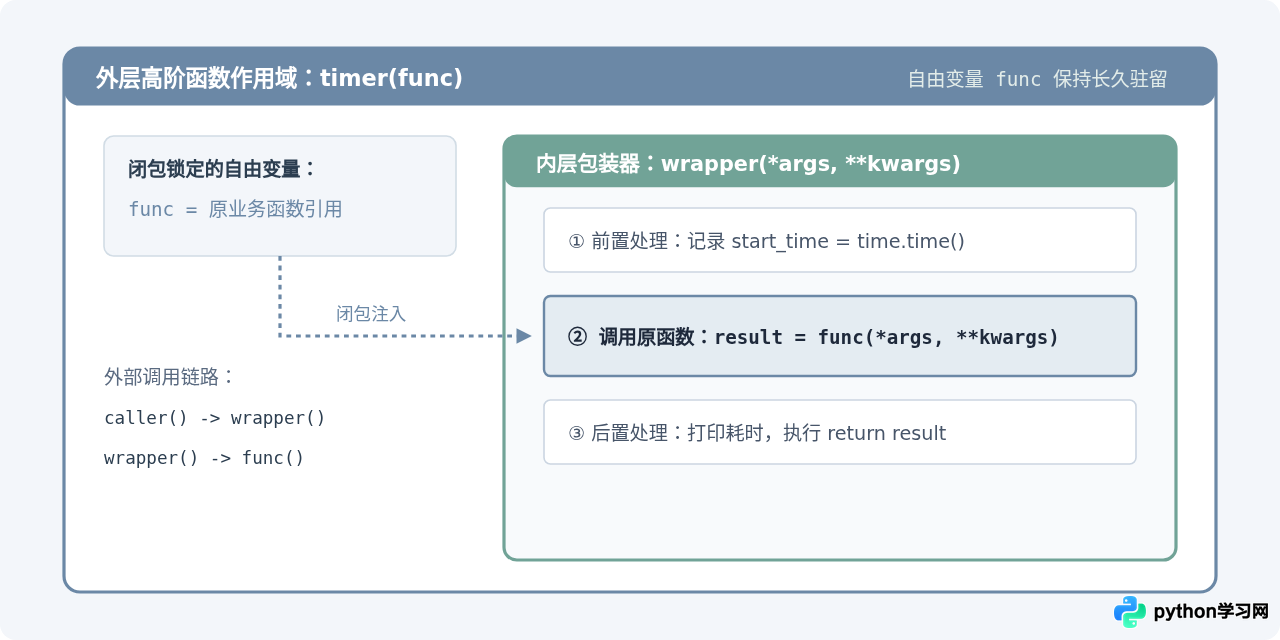
四、进阶核心:带参数的装饰器与元数据保留
1. 为什么带参数的装饰器需要“三层嵌套”?
有时候我们希望装饰器本身也能接受配置参数。例如一个重试装饰器 @retry(max_attempts=3, delay=1)。此时,直接写两层嵌套是不够用的。
根据语法糖解析规则:@retry(max_attempts=3) 是一个函数调用表达式。Python 会先执行 retry(max_attempts=3),然后将该调用的返回值作为真正的装饰器去修饰目标函数。因此,我们需要三层结构:
- 最外层:接收装饰器自定义配置参数(如
max_attempts),并返回真正的装饰器函数。 - 中间层:接收被装饰的目标函数对象(即常规装饰器的外层)。
- 最内层:具体的
wrapper,负责拦截参数、执行逻辑并调用目标函数。
def repeat(num_times):
    # 第一层:接收装饰器参数
    def decorator_repeat(func):
        # 第二层:接收目标函数
        def wrapper(*args, **kwargs):
            # 第三层:接收目标函数的入参并执行
            for _ in range(num_times):
                value = func(*args, **kwargs)
            return value
        return wrapper
    return decorator_repeat

@repeat(num_times=3)
def greet(name):
    print(f"你好, {name}!")
2. 关键细节:使用 functools.wraps 保护函数元数据
在默认情况下,被装饰过的函数,其 __name__、__doc__(文档字符串)以及模块签名都会被替换为内层函数的名称 wrapper。这会导致反射、调试工具、自动化文档生成器以及单元测试无法正确定位原函数。
wrapper 定义上方加上标准库提供的 @functools.wraps(func)。它能自动将被修饰函数的元数据复制回包装函数上,确保函数的“身份凭据”不丢失。
from functools import wraps

def safe_timer(func):
    @wraps(func)  # 关键:保留原函数的 __name__, __doc__ 等属性
    def wrapper(*args, **kwargs):
        """包装器文档"""
        return func(*args, **kwargs)
    return wrapper
五、实战场景与常见误区总结
在日常工程实践中,装饰器是实现面向切面编程(AOP)的核心工具,主要应用在以下几类场景:
- 权限与身份校验:在 Web 开发中,校验当前请求的用户是否登录或是否拥有特定角色权限。
- 日志与监控追踪:无侵入记录函数入参、出参、错误堆栈及执行时长。
- 缓存与记忆化(Memoization):例如
functools.lru_cache,将高频耗时计算的入参和返回值缓存到内存中。 - 输入清洗与参数校验:在函数进入核心计算前,对传入参数的类型和合法性进行预判。
两个最容易踩中的开发陷阱
- 混淆装饰时机与调用时机:装饰器函数的执行分为两阶段。
@decorator本身的执行是在模块被导入(加载)时完成的;而wrapper内部的代码,才是在每次调用被修饰函数时执行的。切勿在外层函数放置每次调用都需要重置的状态。 - 遗漏返回值:如果
wrapper内部仅仅调用了func(*args, **kwargs)但没有写return result,原函数即使有计算结果,调用方拿到的也永远是None。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









