

Python怎么使用chardet库自动检测文件编码
详细介绍在Python中使用chardet库自动检测文件编码的方法,涵盖基础detect调用、大文件流式UniversalDetector优化、置信度阈值处理与安全解码最佳实践。
在处理外部数据、爬虫抓取文本或批量导入用户上传的文件时,经常会遇到 UnicodeDecodeError。造成这类报错的根源在于文件保存时的编码格式五花八门,例如 UTF-8、GBK、GB2312、Shift-JIS 或 UTF-16 等。在 Python 中,解决未知文本文件编码最直接且通用的方法,是以二进制只读模式(rb)读取原始字节流,并利用 chardet 库提供的字符频度统计与编码模型进行自动推断。本文将详细讲解 chardet 的基础使用、结果解析、针对大文件的流式分块检测优化,以及安全解码的完整落地实践。
一、准备工作与快速上手
chardet 是 Python 中广泛使用的通用字符编码检测库,能够根据特定语言和编码的字节组合特征、高频字符分布等模式,计算出文本最可能使用的编码及匹配置信度。该库不是 Python 内置模块,使用前需要通过 pip 完成安装:
pip install chardet安装完成后,最基本的使用方法是通过 chardet.detect() 函数直接分析字节数据。需要特别注意的是,自动检测的输入必须是原始字节序列(bytes 类型),而不是已经解码的字符串。
import chardet

# 示例:以二进制模式读取文件字节流
with open("unknown_text.txt", "rb") as f:
    raw_bytes = f.read()

# 调用 chardet 进行编码推断
detect_result = chardet.detect(raw_bytes)
print(detect_result)
# 示例输出:{'encoding': 'utf-8', 'confidence': 0.99, 'language': ''}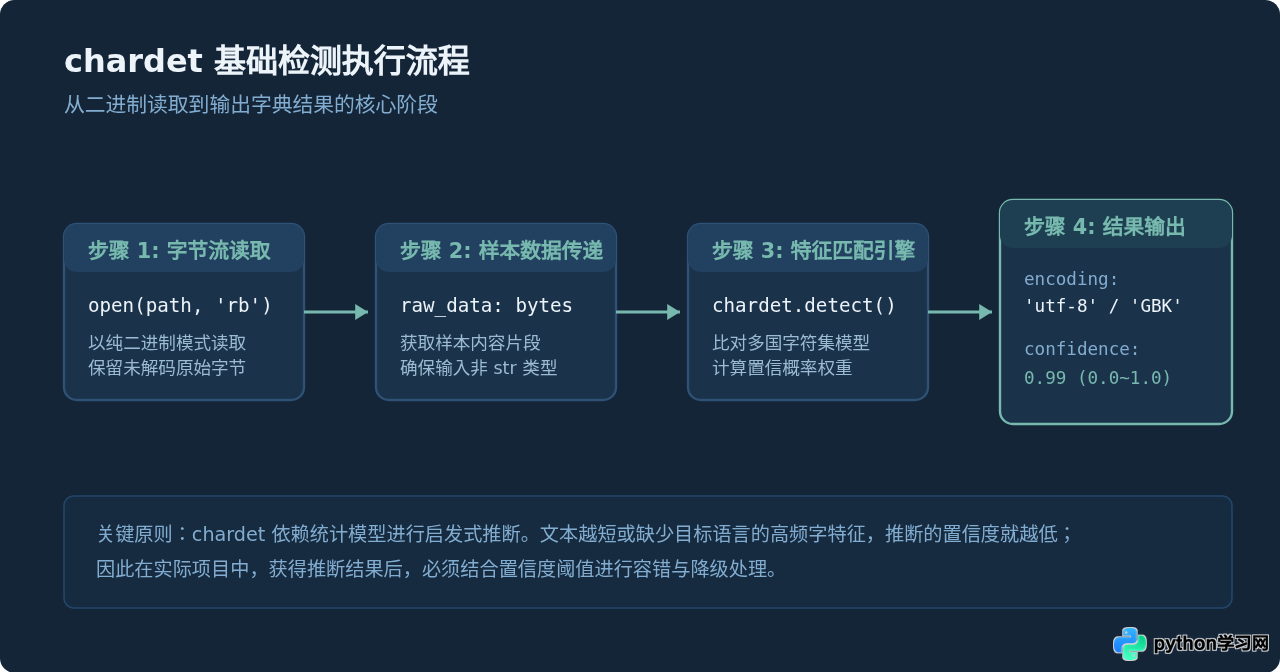
二、解析检测结果与安全解码
chardet.detect() 返回的是一个包含三个键的 Python 字典:
encoding:识别出的编码名称(如'utf-8'、'GB2312'、'ascii'、'windows-1252'等)。如果未能识别或文件为空,该值为None。confidence:评估该推断准确性的置信度,取值范围在0.0到1.0之间。通常建议将0.7或0.8作为安全阈值。language:对应编码所属的主要语言分类(如'Chinese'、'Japanese'或空字符串)。
获得编码名称后,直接使用该编码打开文件仍可能因为样本误差引发异常。稳健的做法是设计一个防崩溃的包装函数,在置信度不足或解码失败时优雅降级:
def safe_read_file(file_path: str, confidence_threshold: float = 0.8) -> str:
    """
    自动检测文件编码并安全读取内容,防止解码异常导致程序中断。
    """
    # 1. 以二进制读取样本(优先读取前 20KB 即可覆盖绝大部分编码特征)
    with open(file_path, "rb") as f:
        sample_bytes = f.read(20480)
        # 将指针重置回文件开头,便于后续读取全文
        f.seek(0)
        full_bytes = f.read()

    # 2. 空文件特殊处理
    if not sample_bytes:
        return ""

    # 3. 检测编码
    result = chardet.detect(sample_bytes)
    encoding = result.get("encoding")
    confidence = result.get("confidence", 0.0)

    # 4. 判断置信度
    chosen_encoding = "utf-8"  # 默认回退编码
    if encoding and confidence >= confidence_threshold:
        chosen_encoding = encoding

    # 5. 安全解码尝试
    try:
        return full_bytes.decode(chosen_encoding)
    except (UnicodeDecodeError, LookupError):
        # 若推断编码解码失败,尝试兼容中文宽泛字符集 GB18030
        try:
            return full_bytes.decode("gb18030")
        except UnicodeDecodeError:
            # 最终保底:忽略不可解字节,确保程序不崩溃
            return full_bytes.decode("utf-8", errors="replace")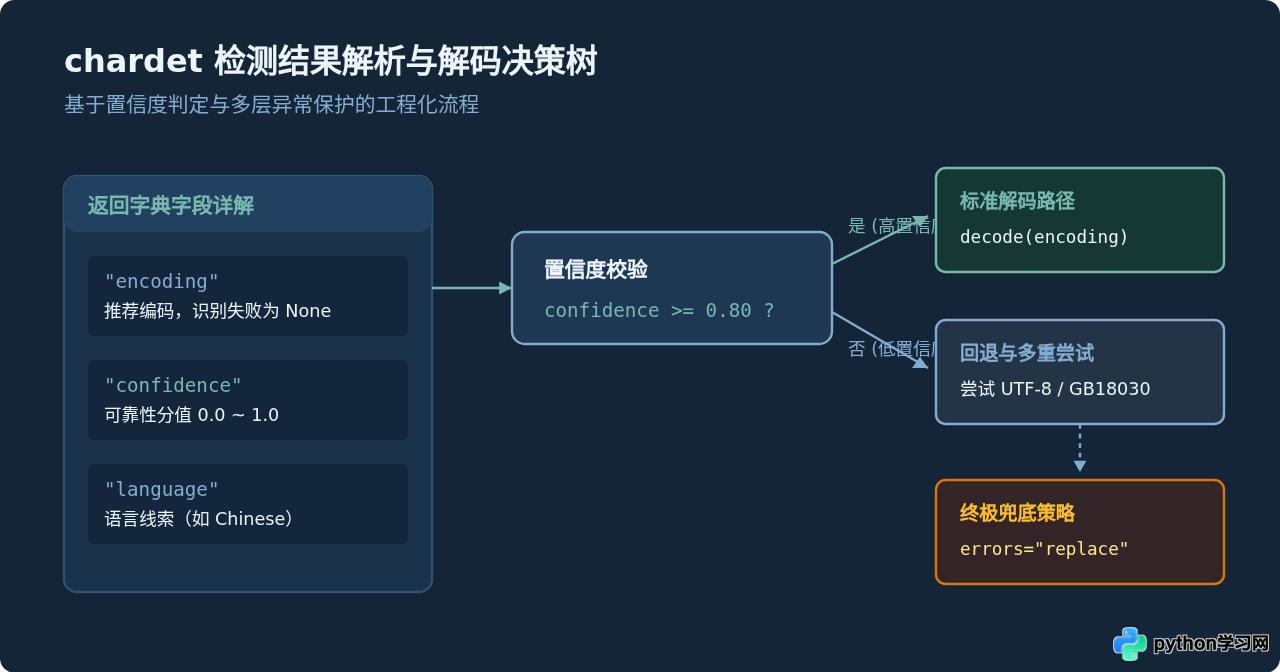
三、处理大文件:UniversalDetector 流式分块优化
如果直接使用 chardet.detect(f.read()) 处理数十兆或上百兆的大型日志文件,会带来两个严重缺陷:第一,将全部字节一次性加载到内存中极易引发内存暴涨;第二,chardet.detect 会对整段数据进行逐字节统计分析,耗时非常长。
为了解决大文件场景下的性能问题,chardet 提供了高级流式检测接口 UniversalDetector。它允许以小数据块(如 4KB 或 8KB)为单位递增式喂入数据(feed()),并在检测置信度达到阈值时自动将 detector.done 置为 True,从而提前中断读取,节省 90% 以上的处理时间和内存。
from chardet.universaldetector import UniversalDetector

def detect_large_file_encoding(file_path: str, chunk_size: int = 4096) -> dict:
    """
    使用 UniversalDetector 分块增量检测大文件编码,达到阈值时自动提前结束。
    """
    detector = UniversalDetector()

    with open(file_path, "rb") as f:
        while True:
            chunk = f.read(chunk_size)
            if not chunk:
                break

            # 喂入当前数据块
            detector.feed(chunk)

            # 若内部算法已确认编码(达到极高置信度),提前跳出循环
            if detector.done:
                break

    # 结束检测并生成最终判定报告
    detector.close()
    return detector.result

# 示例调用
large_result = detect_large_file_encoding("large_system.log")
print(large_result)
# 输出:{'encoding': 'GB2312', 'confidence': 0.99, 'language': 'Chinese'}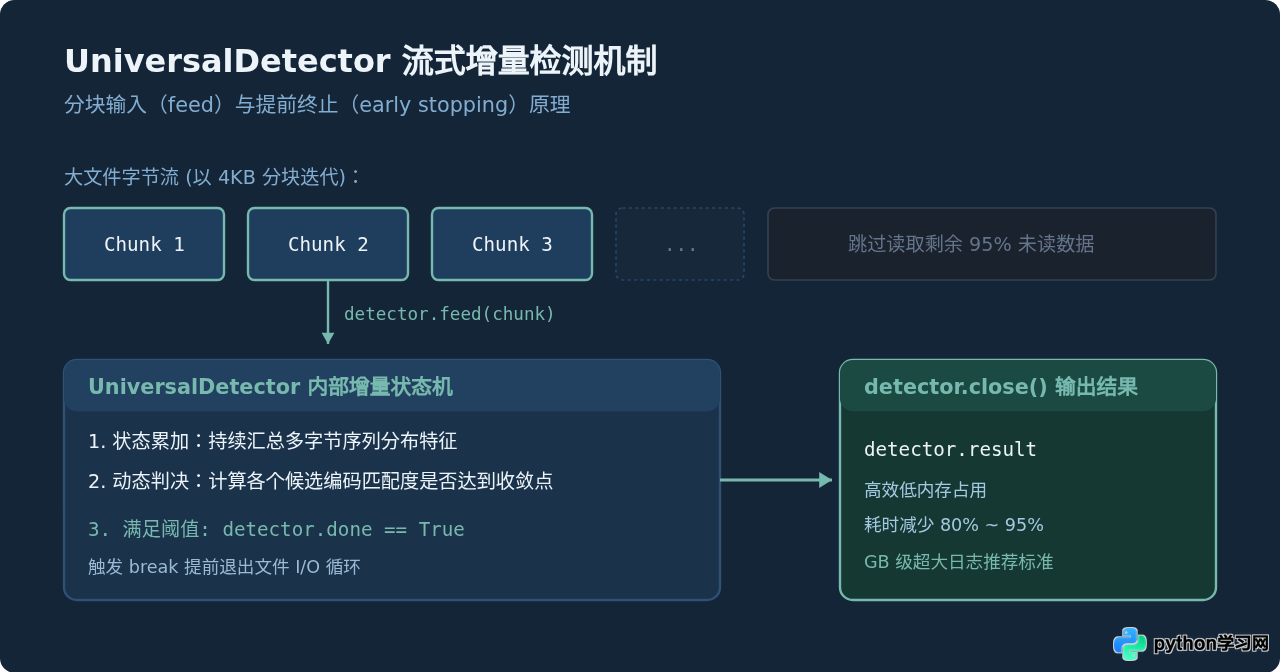
四、命令行快速诊断与常见边界问题
除了在 Python 代码中以 API 方式调用,chardet 在安装后还会附带提供一个名为 chardetect 的命令行小工具,适合在终端中临时排查文件编码:
# 在终端中直接对一个或多个文件进行编码测试
chardetect file1.txt file2.csv

# 示例输出:
# file1.txt: utf-8 with confidence 0.99
# file2.csv: GB2312 with confidence 0.85
在实际生产业务中运用 chardet 时,还需要警惕以下几处典型细节:
1. 纯 ASCII 文本的判定: 如果文件仅包含英文、数字和常见标点符号,chardet 会准确返回 'ascii',置信度通常为 1.0。由于 ASCII 是 UTF-8 的严格子集,在 Python 中无论是用 'ascii' 还是 'utf-8' 解码都能完美成功。
2. 带有 BOM 头的 UTF 编码: 很多在 Windows 环境下保存的文本文件会带有字节顺序标记(BOM,如 UTF-8 BOM 开头的 0xEF 0xBB 0xBF)。如果检测出 UTF-8-SIG 或 utf-8,建议在 open() 时优先使用 utf-8-sig 作为解码编码,它能自动去除开头的不可见 BOM 字符,防止输出乱码或影响第一行字符串匹配。
3. 极短文本的误判: 当输入的字节过少(例如仅有两三个汉字)时,没有足够的统计频度数据供模型匹配,置信度通常会低于 0.6,甚至误判为其他单字节编码(如 ISO-8859-1 或 windows-1252)。对于超短文本,应结合具体的业务上下文字段做强规则约束,不宜单靠 chardet 盲猜。
五、方案选型与最佳实践总结
为了让不同场景下的编码检测更加规范高效,下表对常见使用场景和推断策略进行了归纳对比:
| 文件场景 | 推荐方案 | 核心优势 | 注意事项 |
|---|---|---|---|
| 常规中小文件 (< 2MB) | chardet.detect(f.read()) |
实现简单,一步到位 | 注意使用 'rb' 读取原始字节 |
| 大文件 / 日志 (> 10MB) | UniversalDetector 分块 feed() |
避免全量加载,支持 done 提前截断 |
读取完成后必须调用 close() |
| 超高性能高并发场景 | 结合 BOM 优先探测 + 尝试 UTF-8 解码 | 95% 以上现代文件直接成功,省去统计开销 | 仅在抛出 UnicodeDecodeError 时再启用 chardet |
| 简体中文混合文本 | 推断为 GB2312/GBK 时回退至 GB18030 |
完美兼容繁体字、生僻字与少数民族文字 | GB18030 是 GBK/GB2312 的超集 |
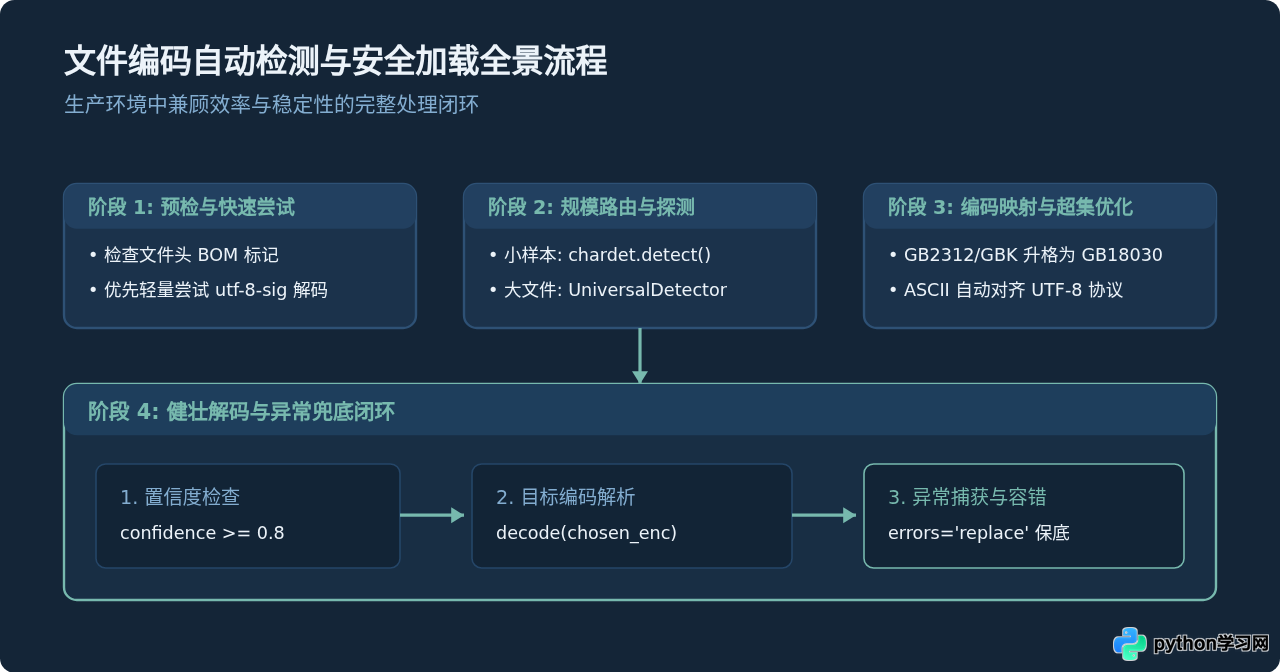
综上所述,在 Python 中使用 chardet 库自动检测文件编码的关键在于:保持以二进制形式读取字节流,对于小文件直接采用 chardet.detect() 快速推断,对于海量或大尺寸日志文件优先使用 UniversalDetector 分块并结合 detector.done 提前结束。同时,在获得预测结果后结合置信度阈值建立降级保护机制,即可彻底摆脱 UnicodeDecodeError 的困扰,保障数据导入管道的稳定运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









