

Python for循环中break和continue的区别与应用
深入解析Python中for循环的break与continue语句:核心执行机制、执行步骤对比、典型实际应用场景、结合else的避坑要点及嵌套循环处理技巧。
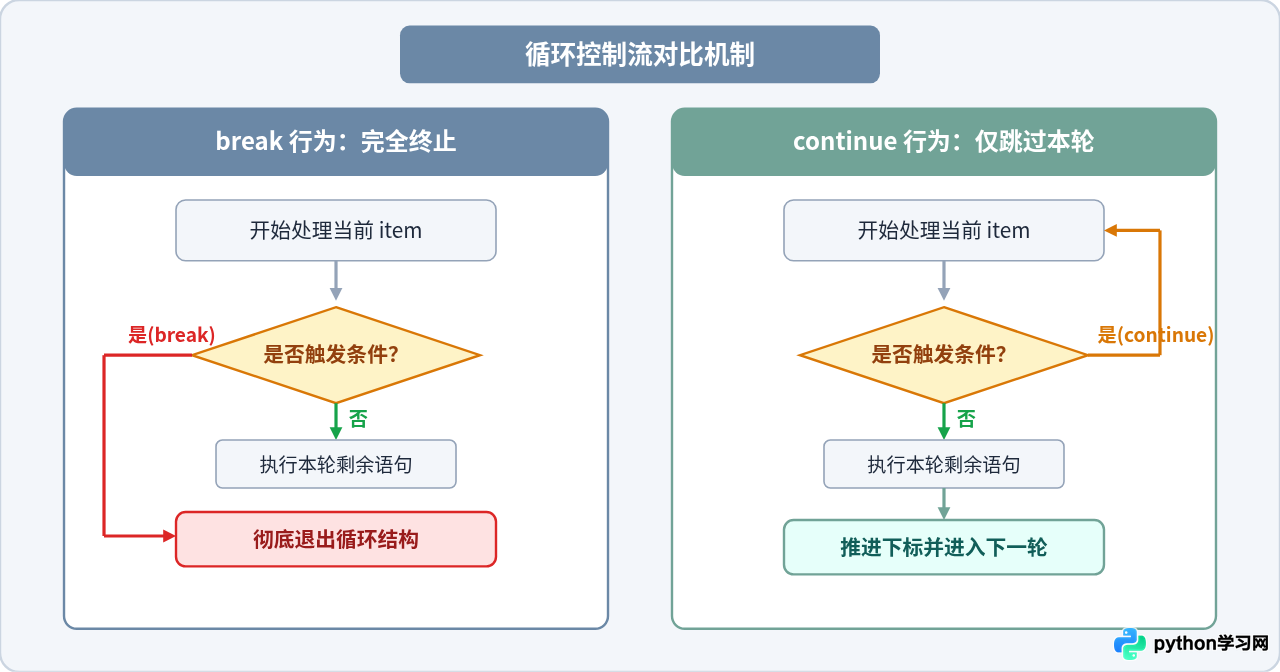
for 循环用于依次遍历序列或迭代器中的每一项。当需要在迭代过程中根据具体数据条件改变执行路径时,break 和 continue 是最基础也是最常用的两个关键字。简单而言:break 是直接终结整个循环的生命周期,剩余的所有元素都不再遍历;而 continue 仅仅跳过当前轮次的剩余语句,立即推进游标并开始处理下一个元素。本文将结合执行原理、步骤轨迹与实际应用案例,系统拆解两者的运行本质与最佳实践。
一、核心本质区别:控制流转向对比
为了直观对比两者的控制逻辑,我们可以把循环想象成一条流水线工序:流水线依次传送待处理的物品。在处理单个物品的步骤中:
- break(直接拉下急停电闸): 一旦检测到目标条件触发
break,当前循环结构立即解构,控制权直接交还给循环块外面的后续代码,队列中尚未被遍历的所有元素都将被就地遗弃。 - continue(挑拣并跳过废品): 当检测到特定条件触发
continue时,当前物品后续的工序被取消,流水线立即将下一个物品推进到操作台,继续正常执行后续循环轮次。
二、break 语句的工作原理与典型应用
break 的核心诉求在于“达成目标即停”或“遭遇异常即退”。在许多算法与业务逻辑中,一旦找到了所需的单个结果,继续遍历后续成千上万条数据就是单纯的资源浪费。此时使用 break 可以大幅提升运行效率。
1. 典型应用场景一:线性查找与命中提前退出
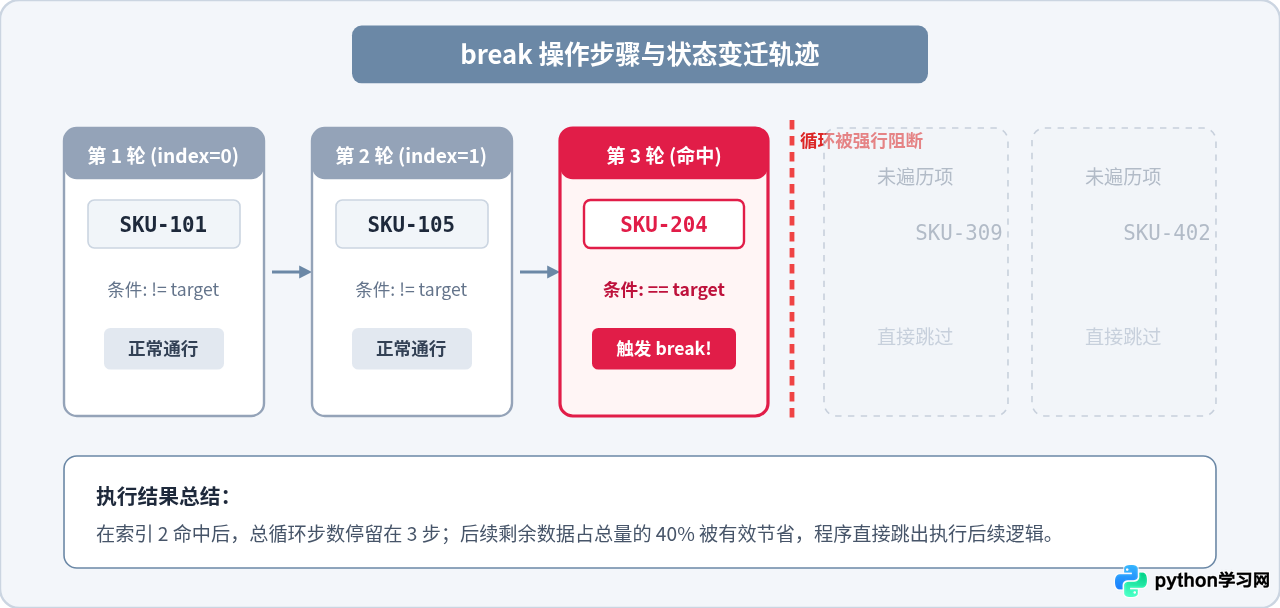
假设我们有一个商品库存编号列表,需要确认特定编号(如 "SKU-204")是否存在于批次中。找到后立即记录并终止搜索:
sku_list = ["SKU-101", "SKU-105", "SKU-204", "SKU-309", "SKU-402"]
target = "SKU-204"
found_index = -1

for index, sku in enumerate(sku_list):
    print(f"正在扫描索引 {index}:{sku}")
    if sku == target:
        found_index = index
        print(f"-> 命中目标 {target},提前中断搜索!")
        break

# 示例输出:
# 正在扫描索引 0:SKU-101
# 正在扫描索引 1:SKU-105
# 正在扫描索引 2:SKU-204
# -> 命中目标 SKU-204,提前中断搜索!
从输出中可以看出,当扫描到索引 2 时命中目标,break 触发后,列表中的 "SKU-309" 和 "SKU-402" 完全不会被遍历,避免了无意义的计算与 I/O 消耗。
2. 典型应用场景二:安全阀机制(防止超出阀值)
在批处理任务或调用第三方接口时,我们常常需要设定一个累计上限或错误重试上限,例如“累计消费金额达到 1000 元后不再处理后续扣费账单”:
bills = [120, 350, 480, 200, 150]
budget_limit = 1000
total_spent = 0

for amount in bills:
    if total_spent + amount > budget_limit:
        print(f"金额 {amount} 超出预算上限 (当前总额: {total_spent}),停止支付!")
        break
    total_spent += amount
    print(f"成功扣费: {amount},累计已花费: {total_spent}")

# 示例输出:
# 成功扣费: 120,累计已花费: 120
# 成功扣费: 350,累计已花费: 470
# 成功扣费: 480,累计已花费: 950
# 金额 200 超出预算上限 (当前总额: 950),停止支付!
三、continue 语句的工作原理与典型应用
continue 的核心诉求在于“过滤噪音、继续推进”。当面对脏数据、空值、格式异常或不需要本轮处理的项时,使用 continue 能够让业务核心处理逻辑保持整洁,避免深层次嵌套 if-else。
1. 典型应用场景一:清洗过滤数据(守护语句风格)
处理外部传入的数据列表时,经常会遇到 None、空字符串或负数。使用 continue 可以快速剔除坏数据,后续代码只关注有效数据的正常处理:
raw_records = [88, None, -5, 92, "", 100, 76]
valid_scores = []

for item in raw_records:
    # 步骤 1:守卫判定——排除空值
    if item is None or item == "":
        continue
    # 步骤 2:守卫判定——排除非法负数
    if not isinstance(item, (int, float)) or item < 0:
        continue

    # 步骤 3:核心业务代码,无需包在深层 if 内部
    normalized_score = round(item, 1)
    valid_scores.append(normalized_score)

print("清洗后有效成绩:", valid_scores)
# 示例输出:清洗后有效成绩: [88, 92, 100, 76]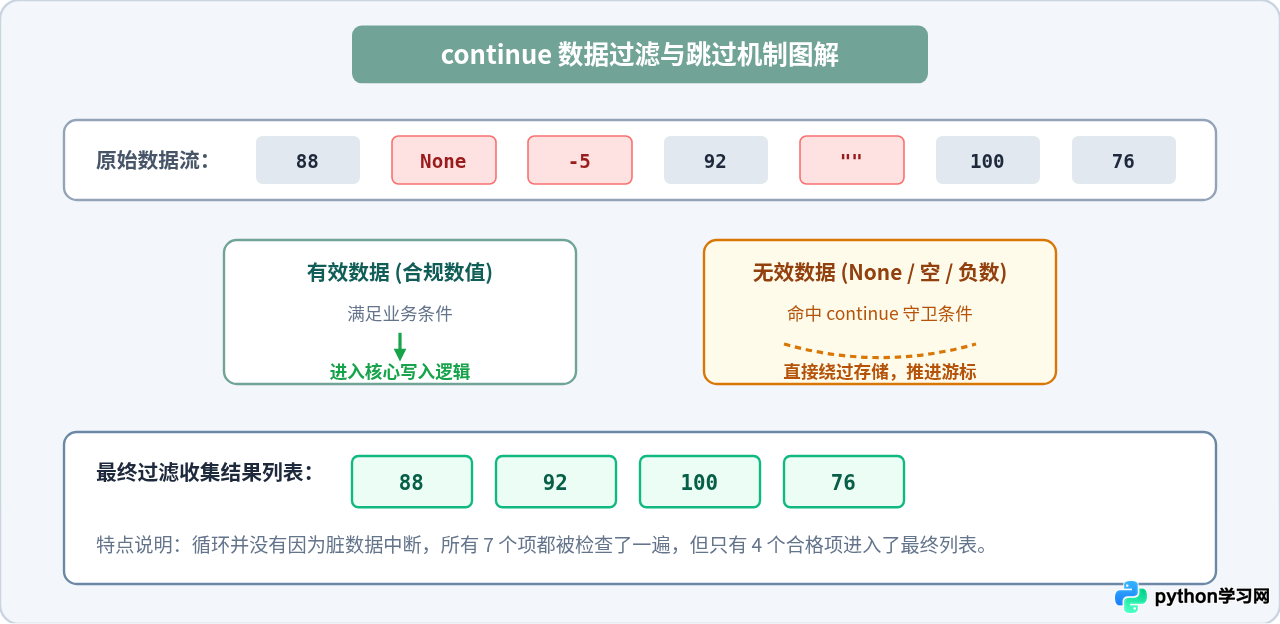
四、进阶对比与容易混淆的细节
虽然 break 和 continue 语义直观,但在结合 Python 的特定语法结构时,初学者极易产生误解。以下两个关键细节在实际编码中必须格外留心。
1. 与 for...else 配合时的表现差异
Python 支持在 for 循环末尾添加一个 else 子句。这里的 else 语义是:“当循环正常遍历完毕所有项,未曾被 break 打断时执行”。
- 触发 break 时:
else块绝对不会执行。 - 触发 continue 时: 只要所有元素顺利过完,
else块仍然会正常执行。
# 示例 A:break 阻断 else
print("--- 运行 break 示例 ---")
for n in [1, 3, 5, 6, 7]:
    if n % 2 == 0:
        print(f"找到偶数 {n},执行 break")
        break
else:
    print("没有找到任何偶数!")
# 结果:打印“找到偶数 6,执行 break”,else 分支被跳过!

# 示例 B:continue 保持 else 正常触发
print("--- 运行 continue 示例 ---")
for n in [1, 3, 5, 7]:
    if n % 2 == 0:
        continue
    print(f"处理奇数: {n}")
else:
    print("整个列表遍历完成,else 子句如期执行!")
# 结果:依次打印奇数,最后正常打印出 else 内的文字!for...else 常用于“查找或默认兜底”场景。通过 break 表达“查到了”,兜底逻辑写在 else 即可,省去了额外维护一个 is_found = False 布尔标记变量的麻烦。
2. 多层嵌套循环中的作用边界
在双层或多层循环中,无论是 break 还是 continue,默认都只对其直接所在的那一层最内层循环生效,不会波及外层循环。
matrix = [
    [1, 2, 3],
    [4, 999, 6],
    [7, 8, 9]
]

for row_idx, row in enumerate(matrix):
    print(f"开始检查第 {row_idx} 行")
    for val in row:
        if val == 999:
            print("-> 发现特殊标记 999,break 退出内层!")
            break  # 这里仅退出了当前的内层 for 循环
        print(f"  读取数值: {val}")

# 示例输出:
# 开始检查第 0 行: 读取数值 1, 2, 3
# 开始检查第 1 行: 读取数值 4 -> 发现特殊标记 999,break 退出内层!
# 开始检查第 2 行: 读取数值 7, 8, 9break。推荐的做法是将整个搜索过程封装进一个函数,直接使用 return 返回;或者在外层判断一个标志位(Flag)。
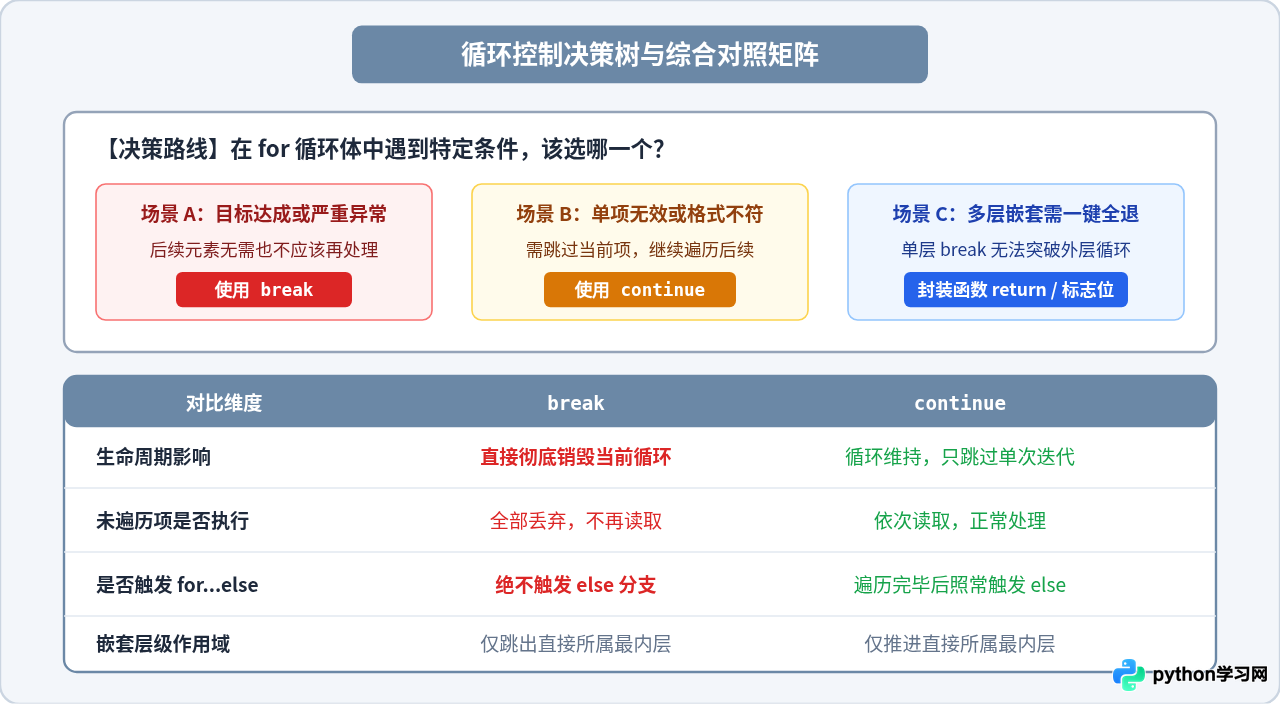
五、总结
在编写 Python 代码时,清晰把握 break 与 continue 的分界线是写出整洁、高效循环的基础:
| 关键字 | 核心意图 | 典型场景 | 性能/代码结构价值 |
|---|---|---|---|
break |
“找到就撤”或“发生严重异常立刻止损” | 查找指定元素、超时中断、命中阈值提前退出 | 避免多余计算,大幅缩短无意义遍历耗时 |
continue |
“坏数据挑走,下一个赶紧跟上” | 空值剔除、格式校验、特殊豁免项跳过 | 扁平化代码结构,避免出现三四层嵌套的深层 if |
结合 for...else 可以优雅替代传统布尔标志变量,而在多层嵌套循环中需时刻牢记二者“仅作用于单层”的特性。按需选用,能让你的循环逻辑既直观易读,又保持严谨的执行性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









