

seaborn做统计图表相比matplotlib好在哪?
深入解析在Python统计数据分析中,Seaborn相比Matplotlib的核心优势:语义化API、长表Tidy Data原生支持、自动化统计聚合与误差估计、开箱即用的分面网格,以及两者协同使用的最佳实践。
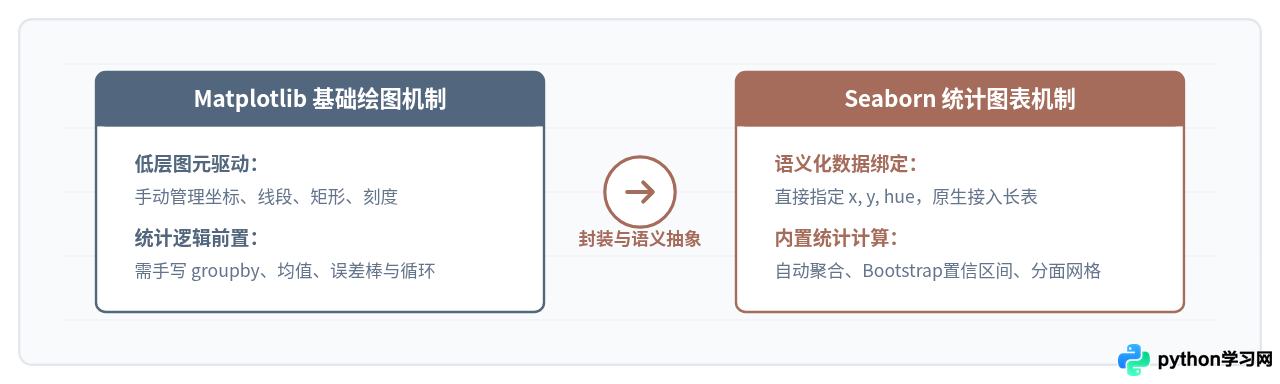
一、从几何图元到统计语义:抽象层级的本质差异
在探索性数据分析(EDA)中,分析师最常提出的问题往往是:“不同类别(category)在指标(metric)上的均值有何差异?”、“按性别(gender)分组后,销售额与工龄的回归趋势是否一致?”。
用 Matplotlib 回答这类问题时,你会发现大部分精力都消耗在“准备几何参数”上:先将 Pandas DataFrame 进行 groupby 聚合,提取均值数组与标准差数组;再手动计算柱状图的宽度与各分组柱子的 X 轴偏移量(例如 x - width/2 与 x + width/2);最后还要手动添加图例并调整标签。
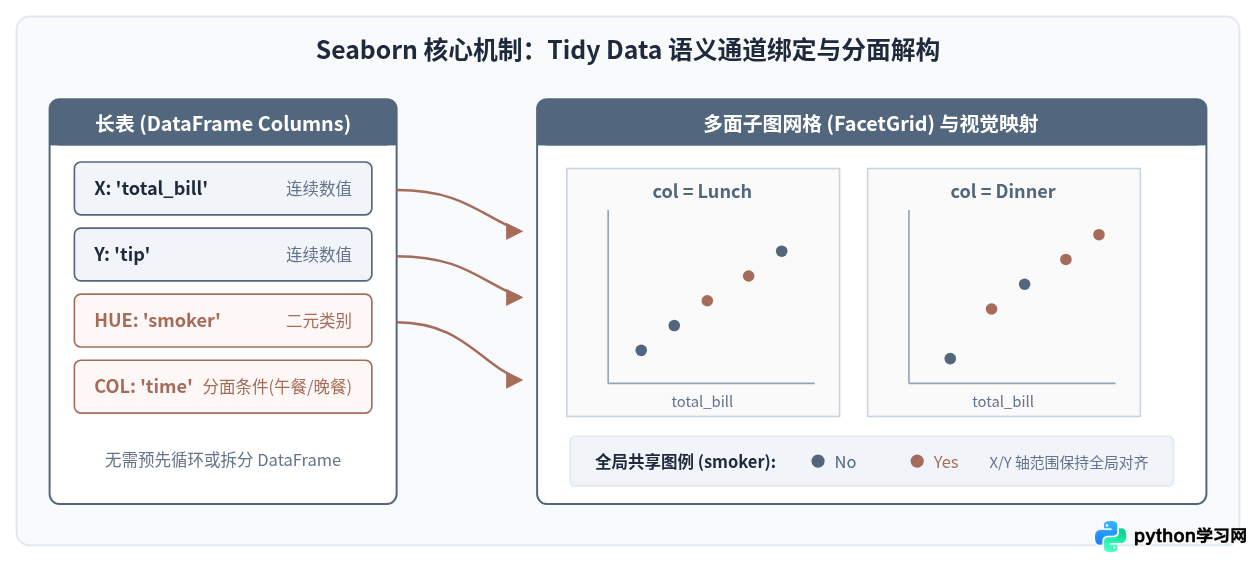
Seaborn 的核心价值正在于把这些高频的统计需求标准化为语义通道映射(Semantic Mapping)。你只需要将 DataFrame 传入,并通过字符串列名指定 x、y、hue(颜色分组)、col(按列分面),其余的分组聚合、置信区间推算与图例合并全部由 Seaborn 在后台自动执行。
二、核心优势对比:代码与执行链路的降维打击
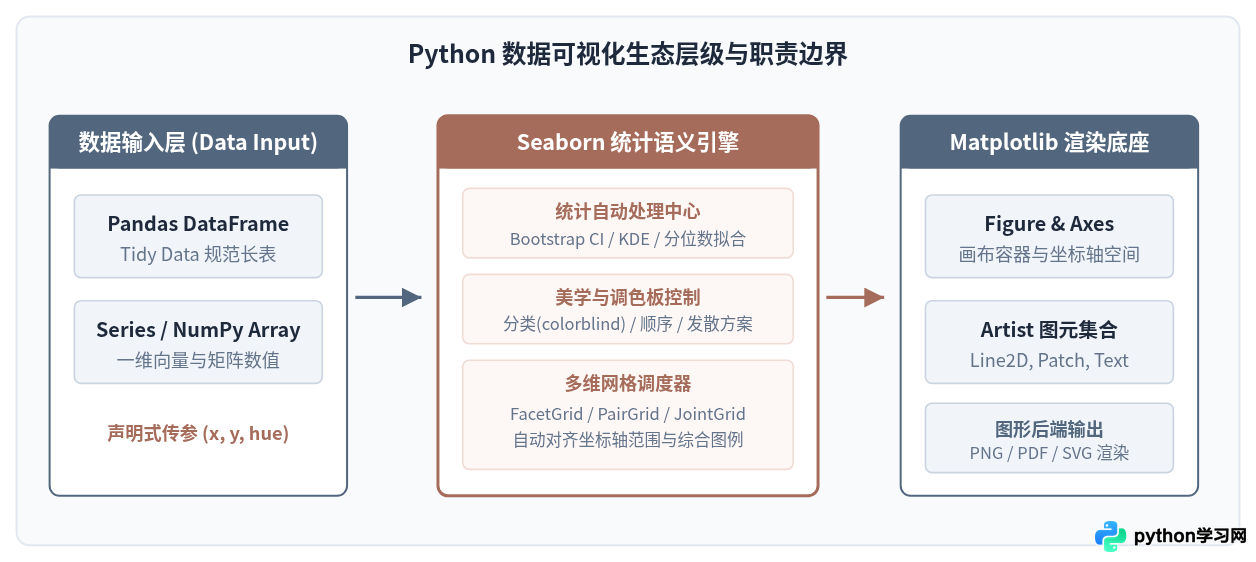
为了直观说明两者在实际开发中的体验差异,我们以一个典型的商业数据分析任务为例:“按部门和职级统计员工的平均薪资,并在柱状图上标注 95% 置信区间与图例”。
1. Matplotlib 的实现方式:繁重的辅助计算
在 Matplotlib 中,由于 ax.bar() 只接受原始坐标数值,开发者必须自己处理聚合与错位排列:
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

# 示例数据
df = pd.DataFrame({
    'dept': ['研发', '研发', '市场', '市场', '运营', '运营'] * 20,
    'level': ['初级', '高级'] * 60,
    'salary': np.random.normal(12000, 2000, 120)
})

# 步骤 1:手动聚合均值与标准误差 (SEM) 作为误差棒依据
summary = df.groupby(['dept', 'level'])['salary'].agg(['mean', 'sem']).unstack()
depts = summary.index
levels = summary['mean'].columns

# 步骤 2:手动计算 X 轴坐标点与每个柱子的物理偏移量
x = np.arange(len(depts))
width = 0.35

fig, ax = plt.subplots(figsize=(8, 5))
for i, lvl in enumerate(levels):
    means = summary['mean'][lvl]
    errors = summary['sem'][lvl]
    offset = (i - len(levels)/2 + 0.5) * width
    ax.bar(x + offset, means, width, yerr=errors, label=lvl, capsize=4)

# 步骤 3:手动补齐坐标刻度与图例
ax.set_xticks(x)
ax.set_xticklabels(depts)
ax.set_ylabel('平均薪资 (元)')
ax.set_title('各部门薪资对比 (Matplotlib 手动实现)')
ax.legend(title='职级')
plt.show()
2. Seaborn 的实现方式:单行语义声明
在 Seaborn 中,上述全部流程被浓缩为一条语义声明,并且误差区间默认使用更为稳健的非参数自助抽样法(Bootstrap Confidence Interval):
import seaborn as sns
import matplotlib.pyplot as plt

# 仅需传入 DataFrame,并通过语义列名直接声明映射规则
plt.figure(figsize=(8, 5))
sns.barplot(
    data=df,
    x='dept',
    y='salary',
    hue='level',
    errorbar=('ci', 95),  # 自动计算 95% Bootstrap 置信区间
    capsize=0.1
)
plt.title('各部门薪资对比 (Seaborn 语义声明)')
plt.show()
这段代码不仅行数减少了 70%,更关键的是思维模型的切换:开发者无需关心某个柱子应该向左偏移 0.175 还是向右偏移 0.175,思考焦点始终停留在“变量与统计关系”本身。
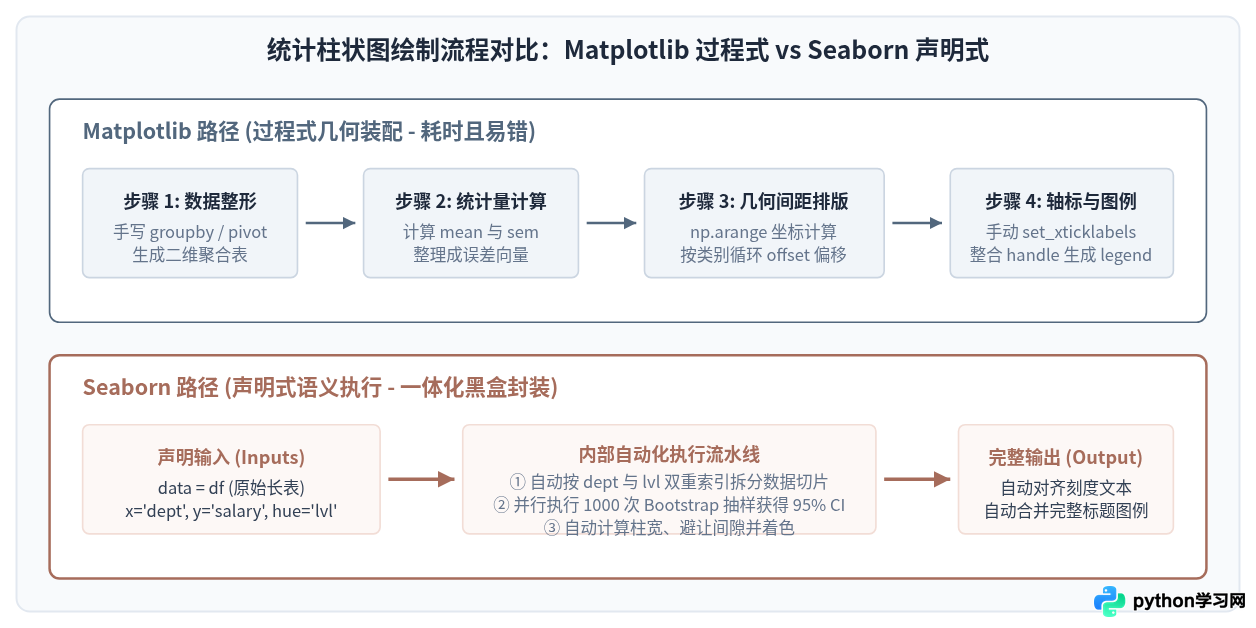
三、四大不可替代的统计专项能力
1. 原生契合 Tidy Data(长表格式)
在现代数据分析体系中,整洁数据(Tidy Data,即每行是一条观测,每列是一个变量)是标准的存储范式。Pandas 清洗后的数据大多以此形态存在。Seaborn 的所有高阶函数(如 scatterplot, lineplot, histplot)都原生以 Tidy DataFrame 作为第一公民。
当你想根据某个类别维度改变图形的颜色、形状或粗细时,只需要传入 hue='category'、style='platform' 或 size='volume'。而在 Matplotlib 中,任何一个维度的叠加都意味着多重 for 循环和手动分配颜色列表。
2. 统计估算器与概率分布可视化
很多统计图表并非单纯呈现原始数据点,而是呈现数学抽象。例如:
- 核密度估计(KDE):用平滑曲线展示连续变量的概率密度。在 Matplotlib 中需要先调用
scipy.stats.gaussian_kde手动拟合评估网格;而在 Seaborn 中,直接运行sns.kdeplot(data=df, x='age', hue='gender', fill=True)即可完成双变量平滑对比。 - 箱线图与小提琴图(Boxplot & Violinplot):Seaborn 的
sns.violinplot(..., split=True)可以把二分类的两组数据分别画在同一把小提琴的左右两侧,极其直观地对比分布形态,而这在 Matplotlib 原生 API 中几乎需要手写上百行 Patch 绘制逻辑。 - 线性回归与残差诊断:
sns.lmplot(data=df, x='spend', y='profit', hue='channel')会自动进行普通最小二乘回归,绘制拟合线并投射半透明的 95% 置信区间带。
3. 多面网格(Small Multiples / Faceting)
当变量维度超过 3 个(例如同时考察年份、地区、产品类型、销售额和利润率)时,最有效的方法不是将所有信息塞进单张图,而是绘制“小多面图(Small Multiples)”。
Seaborn 提供了基于 FacetGrid 架构的高阶接口(relplot, catplot, displot)。你只需传入 col='region', row='year',Seaborn 便会自动根据分类变量的唯一值数量,动态构建网格状子图,同时自动共享所有子图的 X/Y 轴范围,并把全图唯一的综合图例统一放置在画布右侧边缘。在 Matplotlib 中手写这样一套兼具轴对齐、空白子图裁剪与图例去重的系统,极度耗时且容易出现边缘刻度错位。
4. 符合信息传达准则的默认美学与调色板
Matplotlib 的早期默认样式(蓝、绿、红等原色线条,沉重的黑色外边框)一直饱受诟病。尽管现代 Matplotlib 引入了 vivid 样式和更现代的色彩循环,但在统计学术规范上仍显粗糙。
Seaborn 内置了一套经过统计学与感知学验证的主题体系(如 sns.set_theme(style='whitegrid'))以及三类专用调色板:
- 分类调色板(Qualitative Palettes):如
deep,colorblind,针对色盲友好且各颜色感知明度均衡,避免某类数据在视觉上被无意放大。 - 连续顺序调色板(Sequential Palettes):如
rocket,mako,单调递增感知亮度,适合表示从低到高的数值浓度。 - 双向发散调色板(Diverging Palettes):如
vlag,icefire,以纯中性灰为中点,两极分别向冷暖色对称发散,非常适合展示相关系数矩阵或偏离基准值的百分比。
四、两者的差异边界与实际选择指南
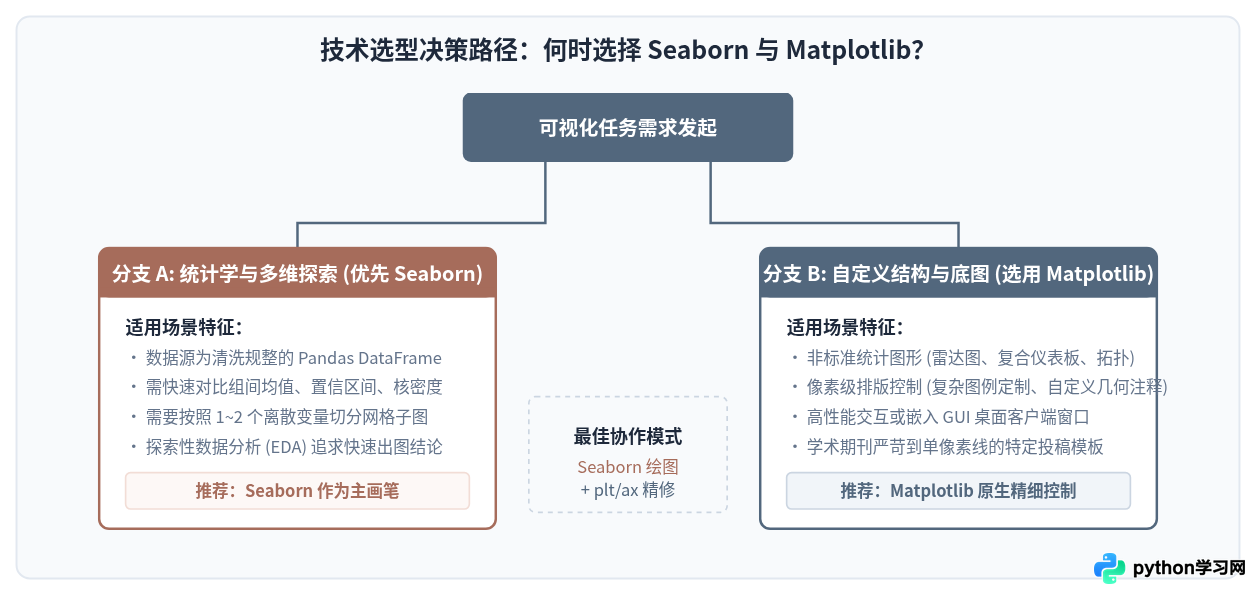
理解了 Seaborn 的强大之后,许多初学者容易产生一个误区:“既然 Seaborn 这么省事,是不是可以彻底抛弃 Matplotlib 了?”答案显然是否定的。
Seaborn 的局限性与代价值得警惕:
- 非标准图形支持弱:Seaborn 严格遵循统计图表范式(分布、关系、分类)。如果你要画的是工程 CAD 截面图、地理等值线复合图、极坐标雷达图或自定义树状层级拓扑,Seaborn 无能为力。
- 对非规范数据(Wide-form 宽表/脏数据)不够宽容:Seaborn 在长表格式下体验极佳,但如果遇到缺少规范索引、嵌套结构复杂的野数据,往往需要先耗费精力进行
melt转换。 - 深度定制最终仍需穿透到底层:Seaborn 函数返回的本质上就是 Matplotlib 的
AxesSubplot对象(或管理多个 Axes 的FacetGrid)。要微调某个坐标轴刻度的旋转角度、添加一条带箭头的特定注解文本,或者修改画布 DPI,依然必须调用 Matplotlib 原生方法。
五、总结:维度提升带来的生产力解放
回到最初的问题:seaborn做统计图表相比matplotlib好在哪?
它的优势并不在于能画出 Matplotlib 画不出来的图案,而在于把繁琐重复的统计计算与几何坐标编排封装成了直观的声明式接口。它让数据科学家从“如何计算偏移量画出第 3 根柱子”的机械劳动中解脱出来,转而专注于“变量之间的相关关系究竟如何”这一核心分析业务。
在日常数据分析工作中,优先使用 Seaborn 进行数据探索与多维模式挖掘;在需要导出定稿报告或有严苛排版规范时,借助底层 Matplotlib 调整坐标轴与标注,正是兼顾高效与灵活的最优解法。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









