

Python数据分析常用代码模板:Pandas数据清洗与预处理
针对Python数据分析常见的数据清洗任务,提供标准化、可复用的Pandas代码模板,涵盖数据体检、类型转换、缺失与重复值治理、文本规整及异常值清洗全流程。
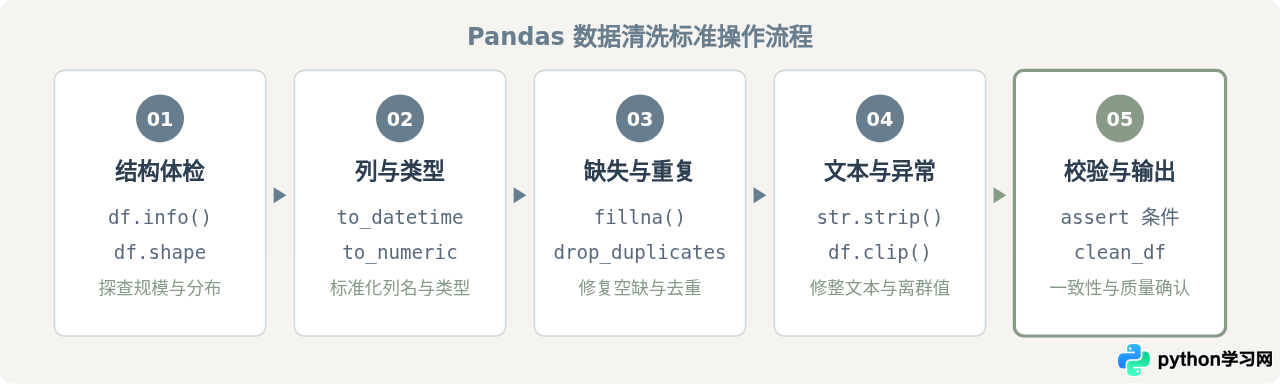
在实际数据分析与挖掘任务中,原始数据通常混杂着类型不匹配、缺失值、格式不一、重复记录以及异常偏离值等问题。本文提供一套基于 Python Pandas 的标准化数据清洗与预处理代码模板,涵盖从数据初始体检、字段与类型规范化、缺失及重复值处理,到文本清理与异常截断的完整流程,帮助读者快速落地生产级数据预处理操作。
一、数据初始探查与“体检”模板
在动笔写任何过滤或修改代码前,必须掌握数据集的物理尺寸、列名规范、内存占用及各字段的非空统计。以下模板用于快速输出数据的总体轮廓。
import pandas as pd
import numpy as np

# 1. 载入原始数据
df = pd.read_csv('raw_dataset.csv')

# 2. 基础体检探查
print("【数据维度 (行数, 列数)】:", df.shape)
print("\n【字段信息与内存占用】:")
df.info()

print("\n【各列缺失值统计与占比】:")
missing_summary = pd.DataFrame({
    '缺失数': df.isnull().sum(),
    '缺失率(%)': (df.isnull().sum() / len(df) * 100).round(2),
    '数据类型': df.dtypes
})
print(missing_summary[missing_summary['缺失数'] > 0])

# 3. 列名标准化处理(去除首尾空格、下划线替换、转小写)
df.columns = (
    df.columns
    .str.strip()
    .str.lower()
    .str.replace(r'[\s\.\-]+', '_', regex=True)
)
print("\n【规范化后的列名】:", df.columns.tolist())
该段代码首先通过 df.info() 与 df.shape 锁定基准规模,随后汇总出所有存在缺失值的列及其占比。最后将包含特殊字符与大小写混杂的列名转为下划线小写命名,避免后续代码因列名空格引发 KeyError。
二、字段类型转换与格式标准化
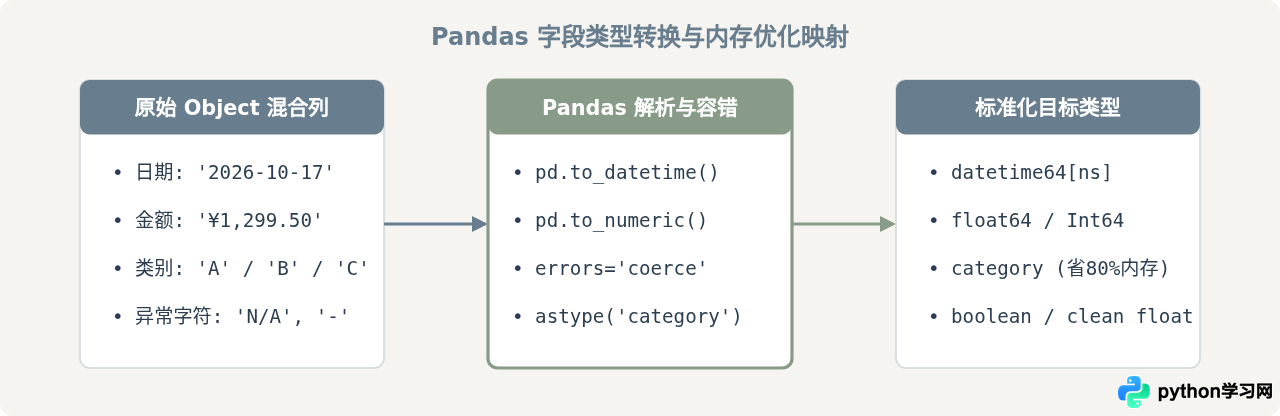
从 CSV 或 Excel 读取的数据常把日期、数值和布尔值误识别为 object(通用字符串或混合对象)。若不显式转换,后续的时间序列切片与数值计算将无法执行。
# 1. 日期时间解析(支持自动推断与非法值强制置为空值)
df['order_date'] = pd.to_datetime(df['order_date'], errors='coerce')

# 2. 数值转换(清洗币种符号与千分符后转换)
if 'amount' in df.columns:
    df['amount'] = (
        df['amount']
        .astype(str)
        .str.replace(r'[¥\$,]', '', regex=True)
        .str.strip()
    )
    df['amount'] = pd.to_numeric(df['amount'], errors='coerce')

# 3. 整型支持缺失值的转换(使用 Pandas 可空整数类型 Int64 代替原生 int)
df['user_id'] = pd.to_numeric(df['user_id'], errors='coerce').astype('Int64')

# 4. 低基数分类字段转 Category(大幅降低内存消耗并加快分组操作)
categorical_cols = ['status', 'city', 'payment_method']
for col in categorical_cols:
    if col in df.columns:
df[col] = df[col].astype('category')errors='coerce' 时,无法解析的脏文本会被自动转换为 NaN。在转换后应立即检查新增的空值数量,确认是否有正常数据因为格式问题被误转为缺失值。
三、缺失值与重复值治理实战
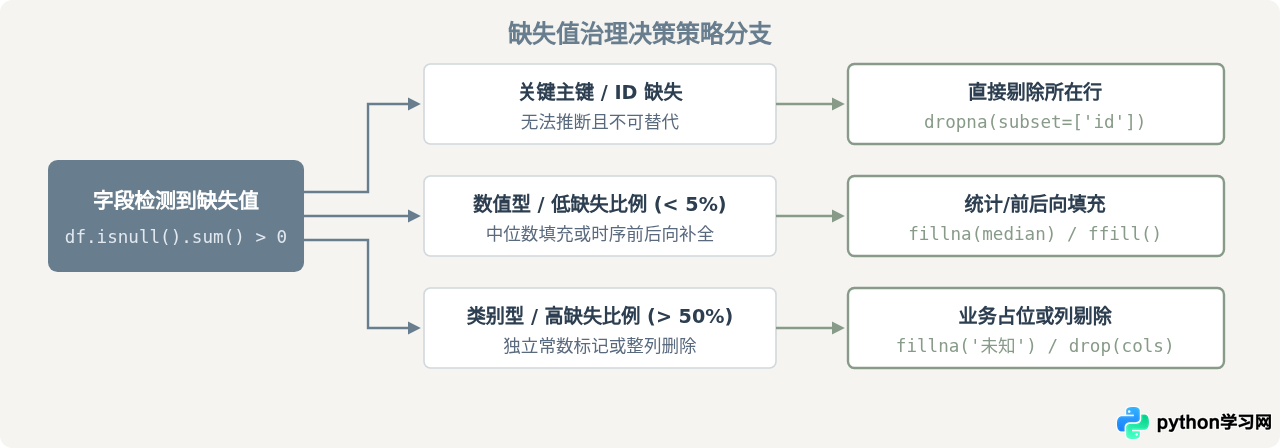
缺失值的出现通常有不同成因,盲目全部删除会导致有效样本量锐减,而盲目直接填充均值则容易稀释数据分布。治理策略应依据字段业务属性与缺失占比区别对待。
# 1. 关键标识字段(如用户ID、交易ID)缺失,直接剔除对应行
df = df.dropna(subset=['user_id', 'order_date'])

# 2. 连续数值型字段使用中位数填充(抗偏态与极值干扰)
if 'amount' in df.columns:
    median_val = df['amount'].median()
    df['amount'] = df['amount'].fillna(median_val)

# 3. 时序数据的前后向填充(按时间排序后沿用前值)
if 'stock_price' in df.columns:
    df = df.sort_values('order_date')
    df['stock_price'] = df['stock_price'].ffill().bfill()

# 4. 离散类别特征使用常量填充
if 'city' in df.columns:
    df['city'] = df['city'].fillna('未知')

# 5. 重复记录识别与清理(按核心业务主键去重,保留最新一条)
initial_len = len(df)
df = df.drop_duplicates(subset=['order_id'], keep='last')
print(f"清理重复记录: {initial_len - len(df)} 行")
四、文本字段规整与异常值截断
字符串字段容易包含不可见字符、首尾空格或前后缀符号。异常值(如录入失误导致的年龄 999 岁)则需要利用统计分布界定并修正。
# 1. 文本列基础清洗(去除首尾空白字符、压缩连续多余空格)
text_cols = df.select_dtypes(include=['object']).columns
for col in text_cols:
    df[col] = df[col].astype(str).str.strip().replace(r'\s+', ' ', regex=True)

# 2. 正则提取示例(从收货地址中提取省份)
if 'address' in df.columns:
    df['province'] = df['address'].str.extract(r'^(.*?省|.*?自治区|北京市|上海市|天津市|重庆市)')

# 3. IQR(四分位距法)识别并截断极端异常值
def clip_outliers_iqr(series, k=1.5):
    q25 = series.quantile(0.25)
    q75 = series.quantile(0.75)
    iqr = q75 - q25
    lower_bound = q25 - k * iqr
    upper_bound = q75 + k * iqr
    return series.clip(lower=lower_bound, upper=upper_bound)

if 'amount' in df.columns:
    df['amount_clipped'] = clip_outliers_iqr(df['amount'])
五、两种代码组织方式对比:链式调用 vs 逐步赋值
在编写 Pandas 数据清洗管道时,开发者通常会在“链式调用(Method Chaining)”与“传统逐步赋值”之间进行选择。在相同清洗目标与数据集条件下,两者的关键差异如下:
| 对比维度 | 链式调用 (Method Chaining) | 逐步赋值 (Step-by-step Assignment) |
|---|---|---|
| 语法形式 | df = (df.dropna(...).assign(...).rename(...)) |
df = df.dropna(...)df['col'] = ... |
| 中间变量 | 无中间变量污染,流水线语义清晰完整。 | 每步修改当前对象,或频繁产生 df1, df2。 |
| 排查与断点调试 | 若中间某一步报错,单步调试定位较繁琐。 | 每步可直接 print(df.head()) 查看即时结果,极易调试。 |
| 适用场景 | 清洗逻辑已固化、纳入生产 ETL 模块或 Airflow 调度脚本。 | Jupyter Notebook 探索性数据分析(EDA)与初期规则摸索阶段。 |
对于初学者或复杂多变的业务场景,建议在探索阶段采用逐步赋值,便于在每一步检查数据形状和空值变化;而在形成固定清洗流水线后,可重构成结构紧凑的函数封装或链式管道。
六、数据预处理总结与速查清单
数据清洗的最后一步必须执行断言(Assert)与质量校验,确保清洗后的数据完全符合下游分析或算法模型的输入契约。
# 校验清单代码模板
def validate_cleaned_data(clean_df):
    # 1. 验证关键唯一主键无空值且唯一
    assert clean_df['user_id'].notnull().all(), "错误: 用户ID仍存在空值"
    assert clean_df['order_id'].is_unique, "错误: 订单ID存在重复记录"

    # 2. 验证数值处于合法区间
    assert (clean_df['amount'] >= 0).all(), "错误: 金额存在负数"

    # 3. 验证时间类型符合要求
    assert np.issubdtype(clean_df['order_date'].dtype, np.datetime64), "错误: 日期类型未转换成功"

    print("【质量校验通过】: 样本行数 =", len(clean_df), ",各字段契约校验无误。")

validate_cleaned_data(df)

# 保存清洗后的高质量数据
df.to_csv('cleaned_dataset.csv', index=False, encoding='utf-8-sig')
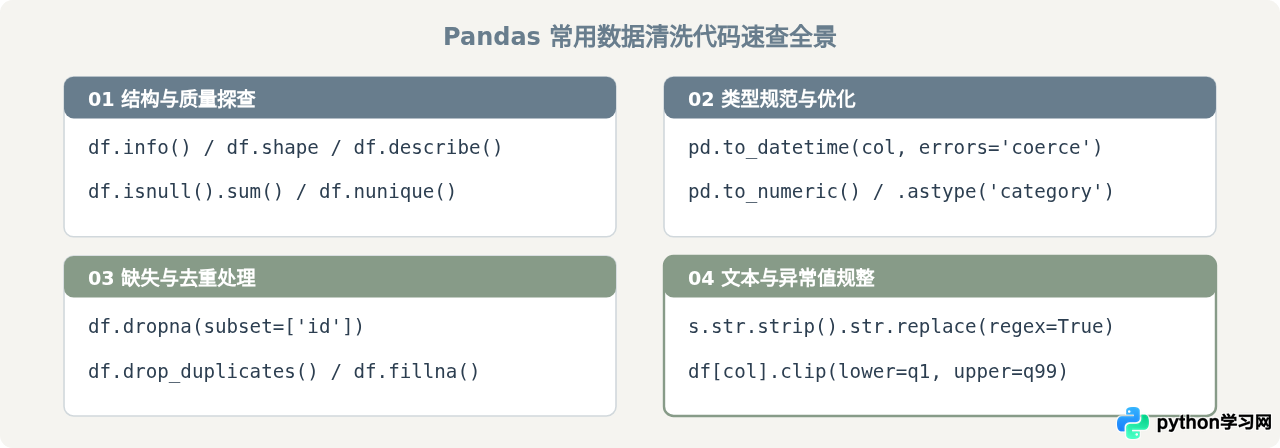
通过这套模板,开发者可以依照“探查结构 → 规整字段与类型 → 治理缺失与重复 → 文本与数值截断 → 最终质量断言”的标准化顺序,确保数据预处理过程既具有可复现性,又能有效防范隐蔽的数据质量风险。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









