

Python数据分析实战:Pandas数据清洗操作指南
一份结构化、实用的Pandas数据清洗实战指南,系统拆解数据探查、缺失值填补与剔除、重复记录处理、类型转换、字符串规范化及异常值检测的全流程操作与代码范例。
一、Pandas数据清洗作业全流程
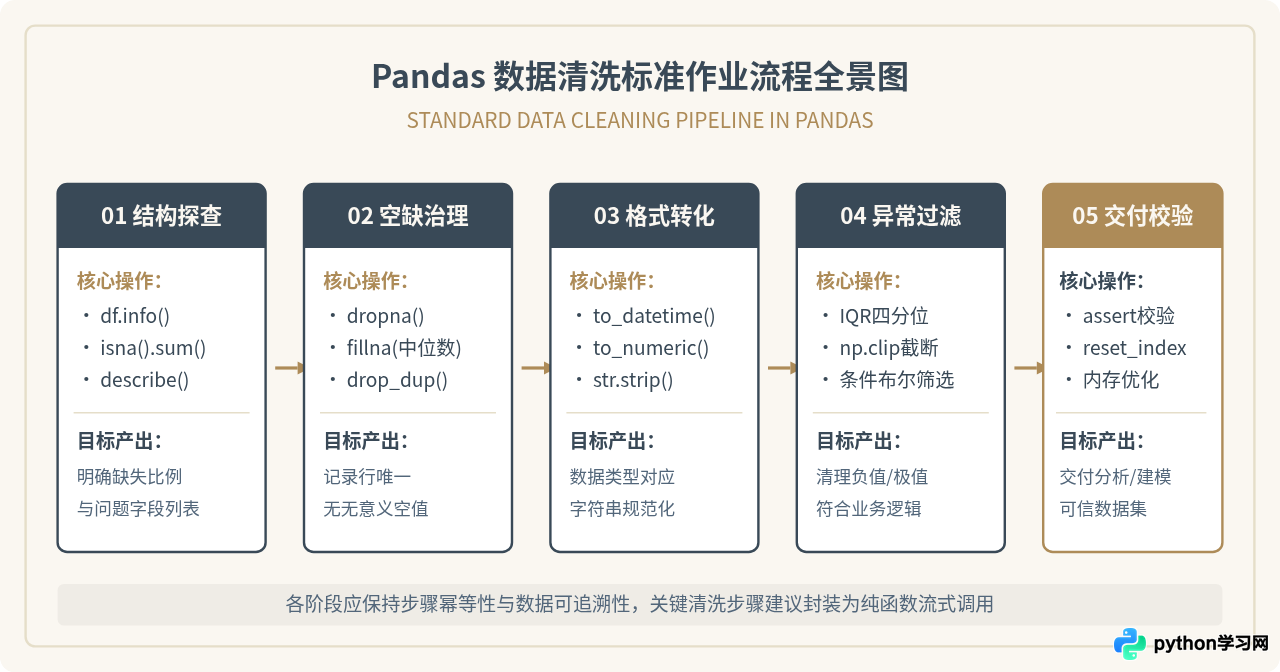
规范的数据清洗不建议想到哪改到哪,而应遵循严密的工程阶段。一个标准的清洗工作流涵盖五个关键节点:数据概况探查、空值与重复记录治理、字段类型规范化、数值范围与异常值校准,以及最终的质量核查。
二、第一步:数据快速诊断与探查
加载原始数据后的第一件事不是直接执行删除或替换,而是对表格进行全貌体检。这一步需要回答三个问题:有多少行和列?哪些列存在缺失?数值分布是否存在明显的越界?
import pandas as pd
import numpy as np

# 构造包含典型脏数据的模拟数据集
raw_data = {
    'order_id': ['A101', 'A102', 'A103', 'A103', 'A104', 'A105'],
    'user_name': ['  Alice ', 'Bob', 'Charlie', 'Charlie', ' David', np.nan],
    'signup_date': ['2023-01-15', '2023/02/18', '2023-03-01', '2023-03-01', 'not_available', '2023-05-12'],
    'amount': ['$120.50', '$89.00', '$310.20', '$310.20', '-$15.00', '$45000.00'],
    'score': [85, np.nan, 92, 92, 78, 88]
}

df = pd.DataFrame(raw_data)

# 1. 查看字段类型、非空计数与内存占用
df.info()

# 2. 统计各列缺失值数量与占比
missing_stats = pd.DataFrame({
    'missing_count': df.isna().sum(),
    'missing_pct': (df.isna().sum() / len(df) * 100).round(2)
})
print(missing_stats)
诊断输出解读:
order_id存在重复值(A103出现两次)。user_name包含前后不可见空格,且存在1个空缺。signup_date为混合格式,且包含非时间字符'not_available'。amount被识别为object(文本)类型,带货币符号$,并且含有负数及异常大值。
三、第二步:缺失值与重复记录治理
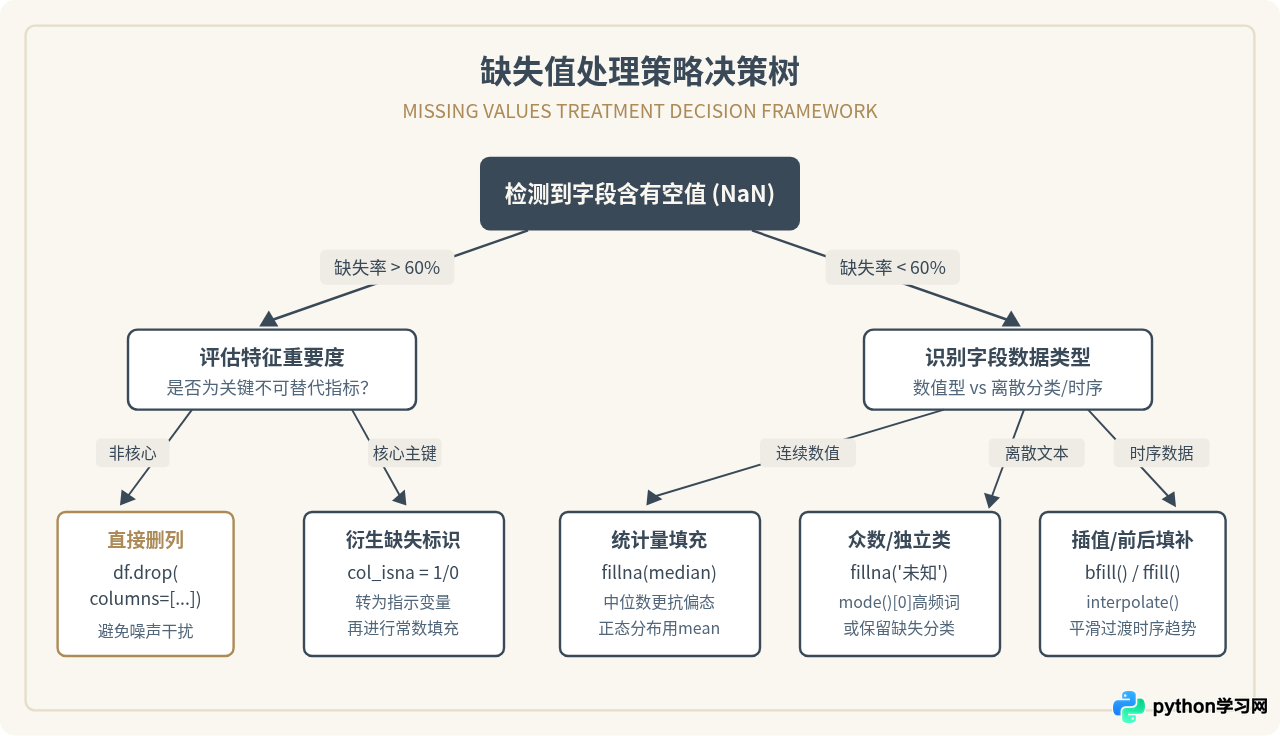
缺失与重复是破坏数据纯净度的首要元凶。对缺失值的处理绝不能一刀切地直接删除;盲目删除高缺失率列可能损失关键维度,盲目删除缺失行则可能引入样本选择偏差。
1. 缺失值的精准填充与行级剔除
对主键或核心索引列(如 order_id),任何空缺都不具备业务意义,必须直接剔除;对于数值指标(如 score),使用中位数填充比均值更能抵抗极端极值的影响。
# 针对核心主键,确保不为空
df = df.dropna(subset=['order_id'])

# 针对连续分值字段,使用中位数进行填充
score_median = df['score'].median()
df['score'] = df['score'].fillna(score_median)

# 针对文本分类字段,填补为具有明确含义的常数
df['user_name'] = df['user_name'].fillna('匿名客户')
2. 重复记录的去重操作
重复记录常源自客户端网络重试或多个数据源合并。去重前务必明确“去重主键”:全行匹配去重往往会遗漏只在时间戳有细微差异的逻辑重复数据。
# 检查是否存在按业务主键重复的记录
duplicate_rows = df[df.duplicated(subset=['order_id'], keep=False)]
print("重复主键样本:\n", duplicate_rows[['order_id', 'user_name']])

# 保留第一次出现的记录,丢弃后续冗余数据
df = df.drop_duplicates(subset=['order_id'], keep='first')
四、第三步:数据类型转换与字符串向量化清洗
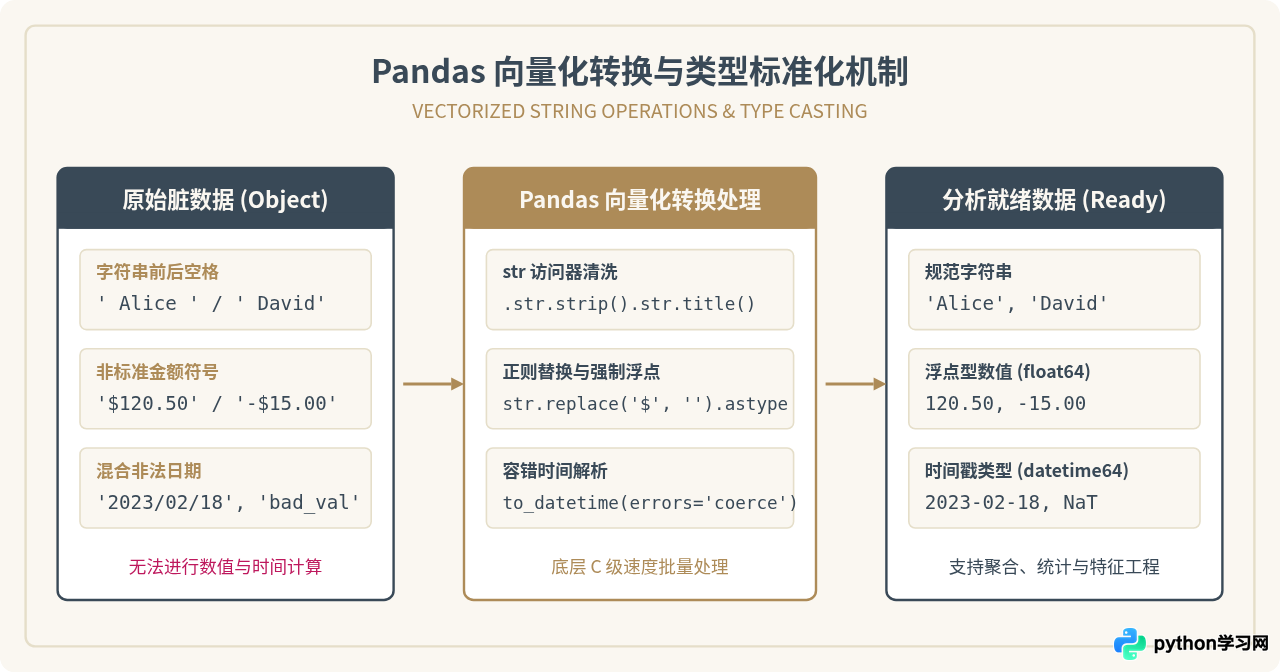
原始文件导入后,由于包含货币符号、格式各异的时间字符串,Pandas往往会将其默认识别为 object 类型的无类型文本。文本类型不仅占用内存翻倍,更无法参与任何数学运算与时间范围切片。
1. 字符串向量化清洗
在Pandas中,不要使用Python原生 for 循环逐行遍历文本。应当使用 Series.str 访问器,该机制会将调用下沉至底层C语言执行,速度提升数十倍。
# 1. 消除前后不可见空格,并将首字母大写规范化
df['user_name'] = df['user_name'].astype(str).str.strip().str.title()

# 2. 清理金额符号与特殊字符
# 将 -$15.00 规范处理为 -15.00
df['amount_clean'] = (
    df['amount']
    .astype(str)
    .str.replace('$', '', regex=False)
    .str.replace(',', '', regex=False)
    .str.strip()
)

# 转换为数值类型;遇到非法字符时转为 NaN 避免程序崩溃
df['amount_clean'] = pd.to_numeric(df['amount_clean'], errors='coerce')pd.to_numeric() 或 pd.to_datetime() 时,设置 errors='coerce' 是防御性编程的关键。遇到非标准格式文本(如 'not_available'),它会安全地将其转换为 NaN 或 NaT,而不会中断整个批处理任务。
2. 日期时间解析与派生
混合格式时间(如破折号 2023-01-15 与斜杠 2023/02/18)可以通过 pd.to_datetime 统一转为标准 datetime64[ns]:
# 统一转为时间戳
df['signup_date'] = pd.to_datetime(df['signup_date'], errors='coerce')

# 基于时间对象派生分析字段
df['signup_year'] = df['signup_date'].dt.year
df['signup_month'] = df['signup_date'].dt.month
df['is_weekend'] = df['signup_date'].dt.dayofweek.isin([5, 6])
五、第四步:业务异常值与越界值清洗
数据类型正确并不代表数据内容符合业务现实。例如:金额为负数(退款未打标)、年龄超过150岁、或者单笔订单金额异常巨大(录入失误)。
1. 逻辑边界硬性过滤
根据业务常识制定绝对硬性规则。例如订单实付金额必须大于等于0:
# 过滤掉金额小于0的脏数据,或根据业务打标退款
valid_amount_mask = df['amount_clean'] >= 0
df = df[valid_amount_mask]
2. 基于四分位距(IQR)的极值盖帽法
对于长尾分布的数值特征,使用 IQR 统计量界定上下限,使用 np.clip() 进行截断,避免极端极值拉偏整体统计模型。
# 计算四分位数
Q1 = df['amount_clean'].quantile(0.25)
Q3 = df['amount_clean'].quantile(0.75)
IQR = Q3 - Q1

lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR

# 将超出上下界的异常值进行盖帽平滑(或直接根据分析目的剔除)
df['amount_capped'] = df['amount_clean'].clip(lower=max(0, lower_bound), upper=upper_bound)
六、第五步:清洗后数据质量检验与流水线封装
清洗完成后的收尾工作至关重要。重设索引以避免旧索引留下的空洞,并使用断言(Assertions)进行自动化质量门禁核验。
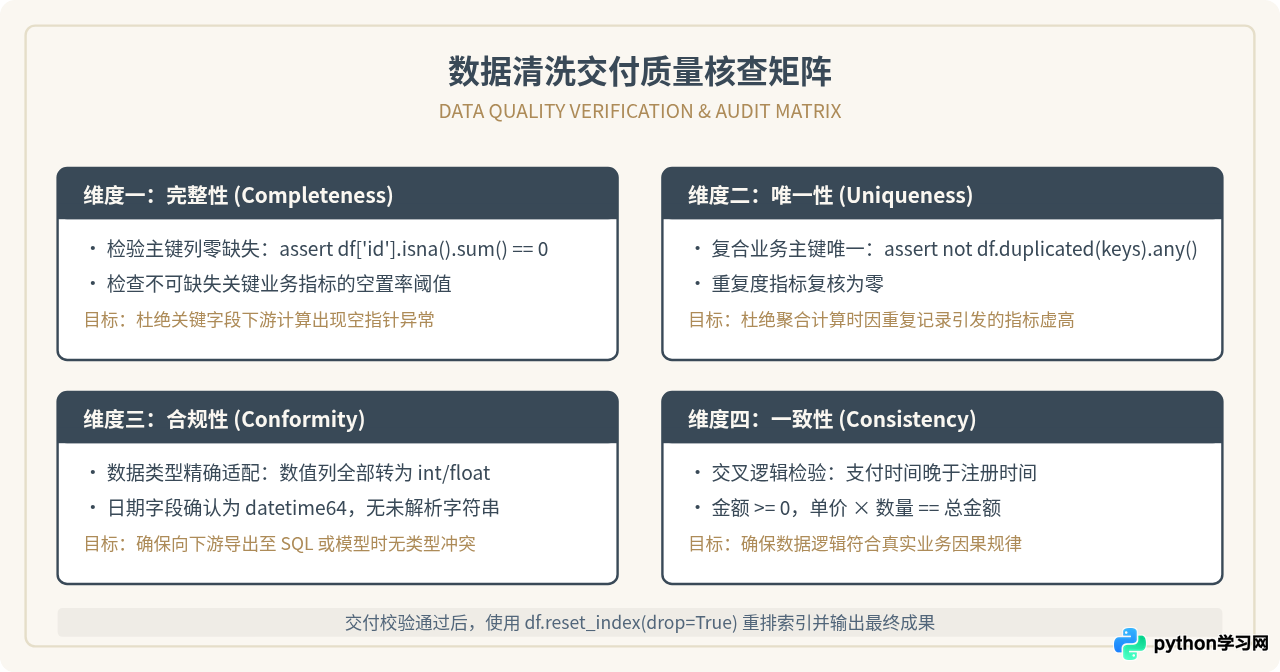
工程化实践:使用 pipe 构建可复用的清洗管道
在实际生产中,避免编写冗长的单体脚本。通过将各步骤封装为单一职责的函数,并使用 Pandas 的 DataFrame.pipe() 串联,能显著提升脚本的可读性与单元测试效率:
def drop_invalid_records(data: pd.DataFrame) -> pd.DataFrame:
    """清理空主键与重复记录"""
    return (
        data.dropna(subset=['order_id'])
            .drop_duplicates(subset=['order_id'], keep='first')
    )

def standardize_types(data: pd.DataFrame) -> pd.DataFrame:
    """标准化字段类型与字符串"""
    res = data.copy()
    res['user_name'] = res['user_name'].fillna('未知用户').astype(str).str.strip()
    res['signup_date'] = pd.to_datetime(res['signup_date'], errors='coerce')
    res['amount'] = (
        pd.to_numeric(
            res['amount'].astype(str).str.replace('$', '', regex=False),
            errors='coerce'
        )
    )
    return res

def filter_outliers(data: pd.DataFrame) -> pd.DataFrame:
    """过滤异常值并约束上下界"""
    return data[data['amount'] >= 0]

# 链式装配清洗流水线
cleaned_df = (
    df
    .pipe(drop_invalid_records)
    .pipe(standardize_types)
    .pipe(filter_outliers)
    .reset_index(drop=True)
)

# 最终质量核验
assert cleaned_df['order_id'].is_unique, "主键存在重复!"
assert cleaned_df['amount'].isna().sum() == 0, "金额列存在未处理的空值!"
print(f"清洗完成,最终合规记录数:{len(cleaned_df)} 行")
七、总结与排坑速查表
| 场景 / 目标 | 推荐方法 | 常见陷阱与注意事项 |
|---|---|---|
| 删除缺失或重复 | dropna(subset=[...])drop_duplicates(subset=[...]) |
避免不传 subset 导致全表整行空缺才触发删除;去重必须明确业务主键。 |
| 缺失值填充 | fillna(df['col'].median())bfill() / ffill() |
注意数据倾斜度,有偏分布慎用 mean();时序数据填充注意防止未来数据泄露。 |
| 文本数据清理 | Series.str.strip()Series.str.replace() |
不要使用 Python for 循环逐行遍历;正则替换注意 regex=False 的开关。 |
| 类型转换 | pd.to_numeric(errors='coerce')pd.to_datetime(errors='coerce') |
务必配置 errors='coerce' 防御脏字符崩溃;转换后立即检查是否有大量新产生的 NaN。 |
| 切片赋值报警 | df = df.copy()使用 .loc[row, col] = val |
警惕 SettingWithCopyWarning,链式切片赋值可能未真正修改原数据。 |
掌握以上数据清洗的标准范式与核心 API,能够帮助你在进入建模、可视化或指标统计前,建立坚实、可靠的数据底座,使后续的数据分析结论真正经得起推敲与检验。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









