

Python zip函数实现多个列表同步并行遍历
全面讲解在Python中使用zip函数实现多个列表同步并行遍历的实现方式、工作机制、长度不一致处理策略与典型应用技巧。
在 Python 编程实践中,同时处理两个或多个具有逻辑关联的列表是极为普遍的需求。例如学生姓名与对应成绩、经度与纬度坐标、产品名称与库存数量等。初学者常借助下标索引(如 for i in range(len(list1)))来访问各列表相同位置的元素,但这不仅代码冗长,还容易因列表长度不同而触发 IndexError 错误。Python 内置的 zip() 函数为解决该问题提供了最标准、高效且具 Pythonic 风格的原生方案,能够把多个可迭代对象的对应项聚合成元组,实现多序列的同步并行遍历。
一、zip 函数的核心工作机制
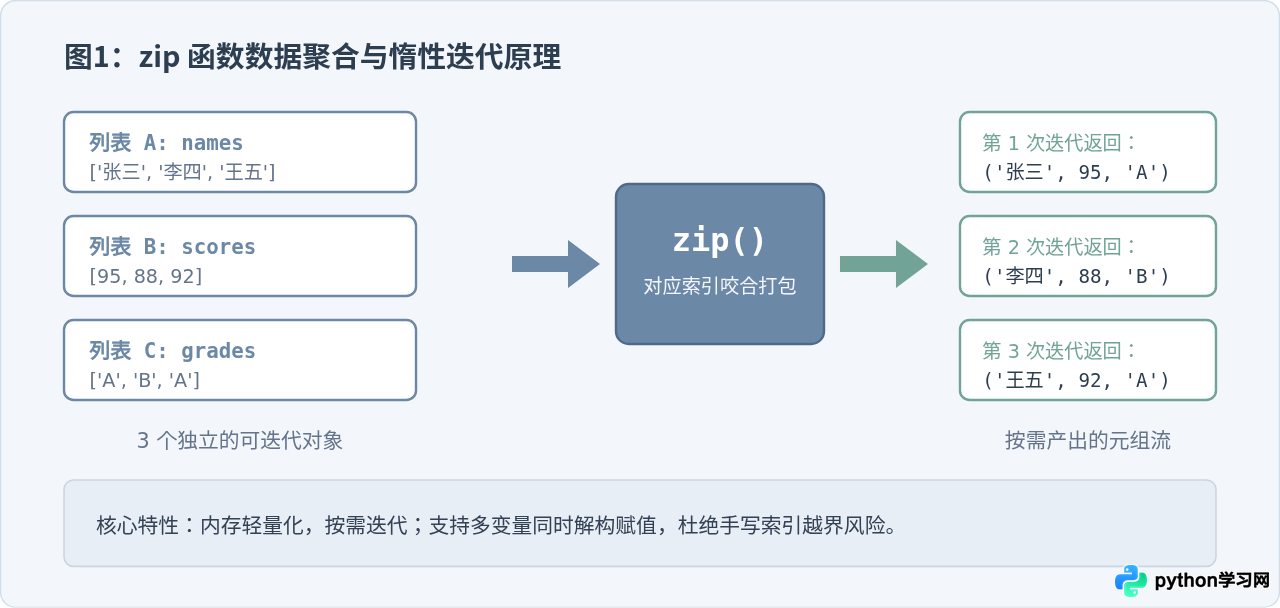
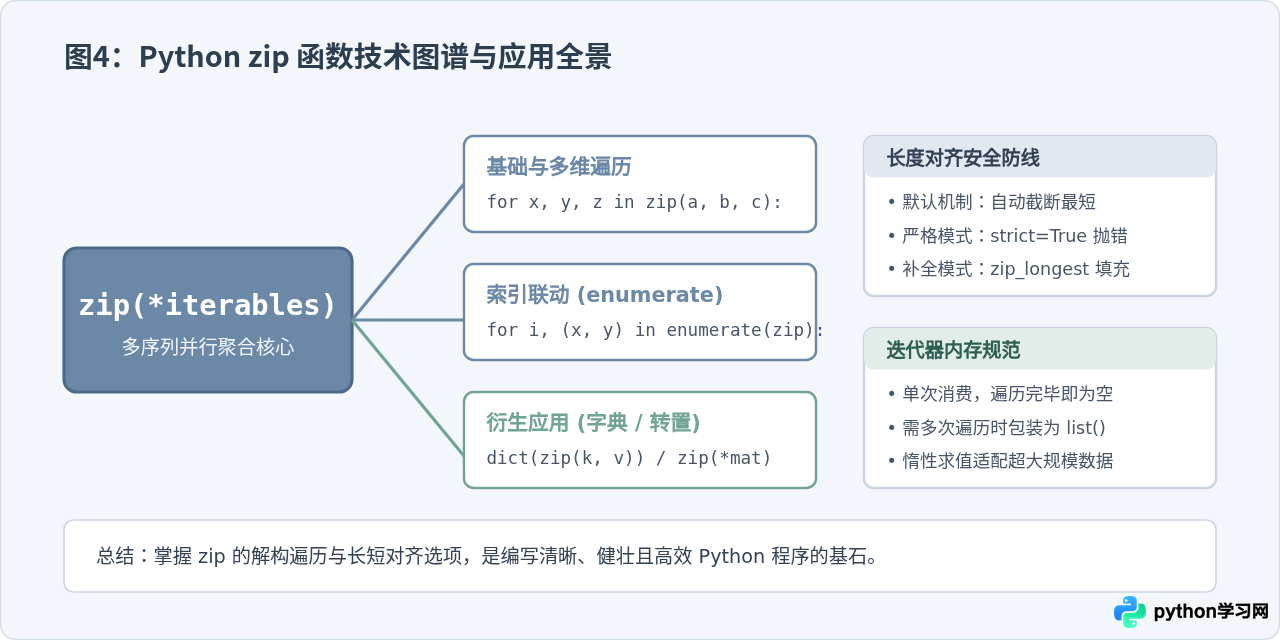
zip() 的命名取自现实中的拉链(zipper),其行为就如同拉链咬合齿牙一样,将传入的多个序列按照下标位置一一对齐,逐个组装成元组。理解 zip() 的工作原理,需要把握以下核心特征:
- 惰性求值(Lazy Evaluation):在 Python 3 中,调用
zip()返回的是一个迭代器对象(Iterator),而不是立即在内存中构建完整的列表。只有在循环遍历或显式转换(如list())时,它才会按需计算并产生下一个元组,因此即使处理百万级长度的数据流,其内存占用也极其微小。 - 多输入支持:
zip()接受任意数量的可迭代参数(列表、元组、集合、字符串、生成器等),并统一按位置聚合。 - 对齐产出:每次迭代产出一个包含各输入序列当前位置元素的元组(Tuple)。当结合
for循环的多变量解构时,语法将变得极为直观。
二、使用 zip 实现多列表同步遍历的标准步骤
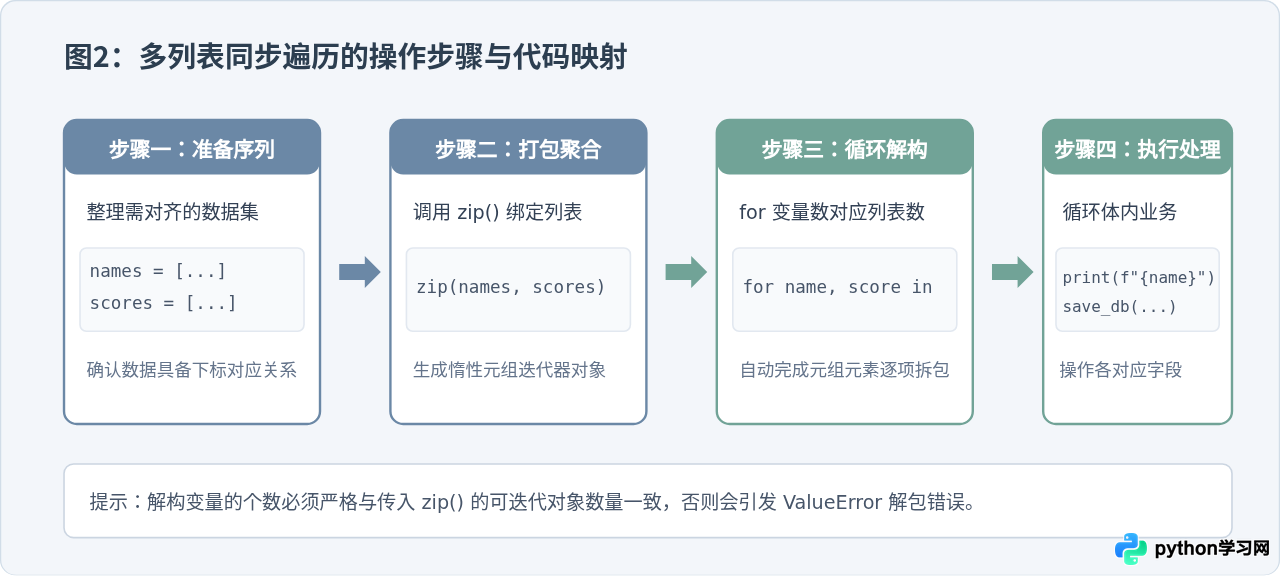
在实际编码中,通过 zip() 开展并行遍历通常遵循明确的四个执行阶段:准备源数据、装载至 zip、在 for 循环中展开多变量解构,最后在循环内部完成业务逻辑。
1. 两个列表的并行遍历基础范例
下面展示同时遍历“学员姓名”和“考核成绩”两个列表并输出格式化结果:
# 1. 准备等长源数据
names = ["张三", "李四", "王五"]
scores = [88, 92, 79]

# 2. 使用 zip 实现并行遍历与元组解构
for name, score in zip(names, scores):
    print(f"学员: {name} | 成绩: {score} 分")
学员: 李四 | 成绩: 92 分
学员: 王五 | 成绩: 79 分
2. 三个及更多列表的同步遍历
zip() 并不仅限于两个列表。无论是三个、五个甚至更多列表,语法均保持统一。只需向 zip() 中追加列表参数,并在 for 后提供对应数量的接收变量即可:
names = ["张三", "李四", "王五"]
scores = [88, 92, 79]
cities = ["北京", "上海", "广州"]
roles = ["班长", "学委", "组长"]

for name, score, city, role in zip(names, scores, cities, roles):
    print(f"[{role}] {name} (城市: {city}) - 得分: {score}")
[学委] 李四 (城市: 上海) - 得分: 92
[组长] 王五 (城市: 广州) - 得分: 79
三、序列长度不一致时的三种处理策略
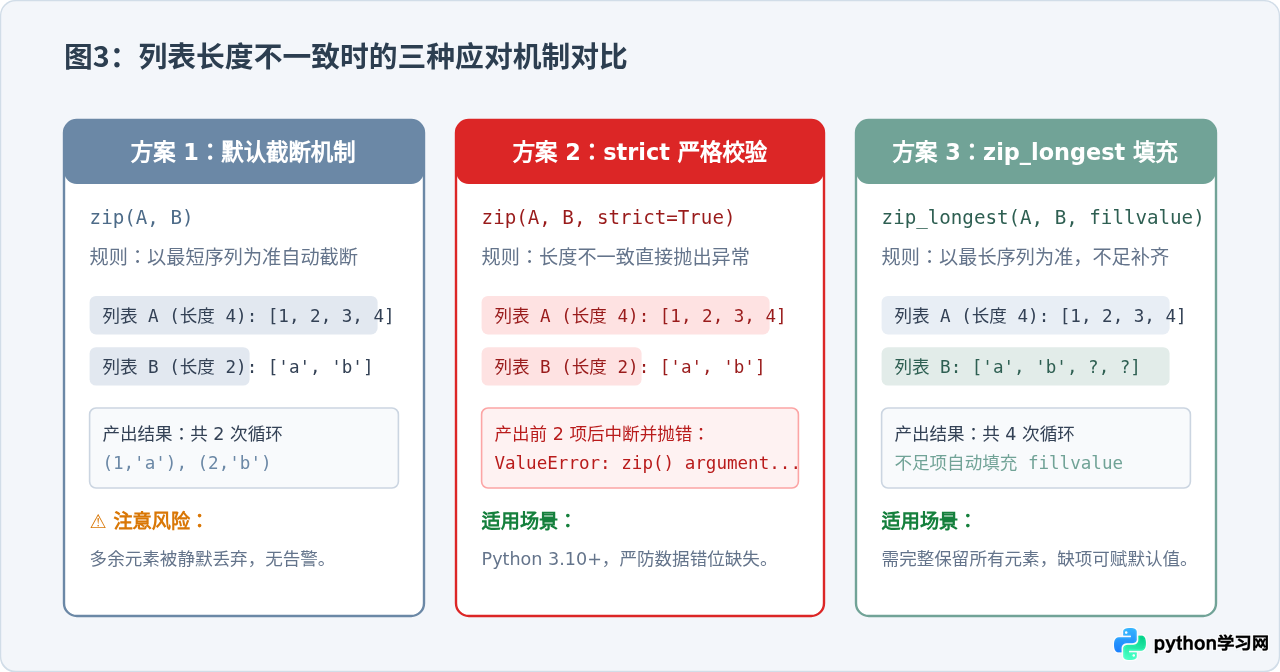
在现实工程中,多个列表的长度往往不能保证绝对一致(如由于爬虫部分失败、网络延迟或字段缺失)。针对长度不对齐的情况,Python 提供了三种截然不同且覆盖各类业务要求的处理策略。
策略 1:默认截断(短板效应)
默认状态下,只要有任意一个列表耗尽元素,zip() 就会停止迭代。长列表中超出部分的元素将被静默丢弃:
keys = ["A", "B", "C", "D"]
values = [1, 2]

for k, v in zip(keys, values):
    print(k, v)
B 2
注意:该特性在有意截取前 N 项时非常方便,但在要求数据一一对应的严格业务场景中容易隐藏 Bug。
策略 2:Python 3.10+ 的 strict=True 严格模式
为了防止开发者在不知情的情况下丢失尾部数据,Python 3.10 引入了 strict=True 参数。一旦检测到各序列长度不一,在产出匹配元素后立即引发 ValueError:
# 需要 Python 3.10 或更高版本
keys = ["A", "B", "C"]
values = [1, 2]

try:
    for k, v in zip(keys, values, strict=True):
        print(k, v)
except ValueError as e:
    print(f"捕获异常: {e}")
B 2
捕获异常: zip() argument 1 is longer than argument 2
策略 3:使用 itertools.zip_longest 保全所有数据
如果希望以“最长”的列表为基准完成遍历,缺失的值填充为指定默认值(如 None 或 0),可以使用标准库 itertools 模块提供的 zip_longest() 函数:
from itertools import zip_longest

names = ["张三", "李四", "王五", "赵六"]
scores = [90, 85]

for name, score in zip_longest(names, scores, fillvalue="缺考"):
    print(f"{name}: {score}")
李四: 85
王五: 缺考
赵六: 缺考
四、zip 函数的高频实用技巧与进阶应用
1. 结合 enumerate 获取并行遍历的索引
当同步遍历多个列表的同时还需要获取当前步进的索引号(序号)时,可直接嵌套使用 enumerate():
users = ["Alice", "Bob", "Charlie"]
roles = ["Admin", "Editor", "Viewer"]

for idx, (user, role) in enumerate(zip(users, roles), start=1):
    print(f"序号 {idx} -> 用户: {user}, 权限: {role}")
for idx, (user, role) in enumerate(...) 中,(user, role) 外层的括号不可省略,它告知解释器将 enumerate 返回的第 2 项(即 zip 打包的元组)进一步解构为两个局部变量。
2. 快速将两个列表配对合并为字典
利用 dict() 构造函数直接接收键值对序列的特性,结合 zip() 可以一行代码将“键列表”与“值列表”转化为字典:
fields = ["id", "username", "status"]
record = [1001, "admin", "active"]

user_dict = dict(zip(fields, record))
print(user_dict)
3. 矩阵转置(行列互换)的解包逆操作
利用星号 * 解包运算符,zip(*matrix) 能够以极其精炼的方式实现二维列表的行与列对调:
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]

# 解包 matrix 后相当于 zip([1,2,3], [4,5,6], [7,8,9])
transposed = [list(col) for col in zip(*matrix)]
print(transposed)
zip() 返回的是迭代器对象。一旦被遍历完毕或使用 list() 消费后,其内部指针便移动到了末尾。如果试图对同一个 zip 对象再次发起循环,将无法获取任何内容。如需多次复用,请在初始化时使用 list(zip(...)) 固化存储为列表。
五、总结与选型指南
为了在不同场景下精准选择最稳健的遍历方式,下表归纳了主流遍历方式的优劣对比与选型原则:
| 方法形式 | 适用场景 | 优势 | 局限 / 风险 |
|---|---|---|---|
for a, b in zip(A, B) |
多列表并行处理、对截断无害或已预先验证等长 | 语法精炼直观,内存开销最小 | 默默吞掉长序列超出项,易隐匿数据错位 |
zip(A, B, strict=True) |
数据完整性敏感业务(金融、审计、数据迁移) | 第一时间暴露长度不匹配,杜绝静默失败 | 仅支持 Python 3.10+,需捕获 ValueError |
itertools.zip_longest(...) |
报表补全、主从补位、需完整保留全量元素 | 不丢弃任何数据,支持灵活自定义缺省占位值 | 需额外引入 itertools 模块 |
传统下标 range(len(...)) |
遍历过程中需要动态修改原列表元素,或进行跨步操作 | 支持复杂的非线性索引用法 | 可读性差,极易发生 IndexError |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









