

Python包管理工具对比:pip与conda在安装科学计算库时的选择

深入对比pip与conda在安装科学计算库时的机制差异、底层依赖处理及环境隔离,提供明确清晰的选型标准与实操建议。
在搭建数据科学与数值计算环境时,选用 pip 还是 conda 是开发者首要面对的分歧点。结论可以明确概括为:如果你的工作重度依赖跨语言底层加速库(如 OpenBLAS、Intel MKL、CUDA、GDAL 等)、需要一键搞定非 Python 共享动态库且希望跨平台行为高度一致,conda(或其轻量实现 Miniconda、Pixi 等)是更稳妥的选择;若你的项目以标准 Web、云原生轻量镜像构建为主,或者目标库已在 PyPI 上提供了完善的预编译 Wheel 轮子,且无需复杂的系统级 C/C++ 运行时隔离,使用 pip 配合标准虚拟环境(venv)则更轻巧直接。
一、核心本质差异:包管理器的管辖边界
理解两者差异的根源,在于认清工具的设计目标。pip 是 Python 官方的标准包安装器,它的管辖边界严格限定在 Python 语言生态内。PyPI(Python Package Index)上分发的主要是源码包(sdist)或预编译的 Wheel 文件(bdist_wheel)。当安装纯 Python 模块时,pip 表现得极为优雅高效;但科学计算库(如 NumPy、SciPy、TensorFlow、PyTorch)核心通常由 C、C++、Fortran 乃至 CUDA 编写,它们需要链接底层的代数运算库与系统级动态链接库。
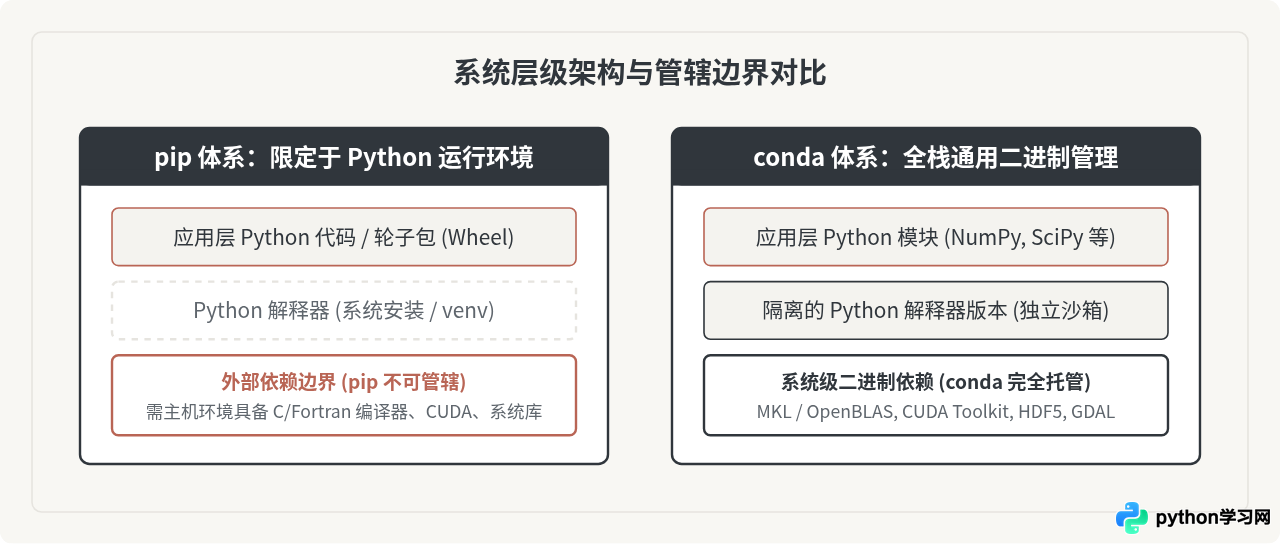
相比之下,conda 是一个通用二进制包管理器与环境管理器。在 conda 的视角下,Python 解释器自身、C 运行库、底层科学计算加速库(如 Intel MKL、OpenBLAS、LLVM)与 Python 代码没有本质区别,全都被打包为同等地位的二进制包纳入管理。这就使 conda 能够把非 Python 的复杂依赖完整安装进独立沙箱,完全无需操作系统提权或污染主机环境。
二、科学计算场景下的关键考量指标
在做选择时,脱离具体约束谈优劣是不切实际的。对于科学计算与机器学习工程师而言,核心考量通常集中在以下四个维度:
| 对比维度 | pip + venv | conda (Anaconda / Miniconda) |
|---|---|---|
| 非 Python 依赖 | 仅依赖已内置的 Wheel 或操作系统宿主动态链接库 | 统一管理 C/C++ 运行时、BLAS/LAPACK、CUDA 等二进制 |
| 算力与加速库 | PyPI 上的 Wheel 多打包 OpenBLAS,需特定编译才可换 MKL | 默认或可通过通道无缝选用 Intel MKL 加速,运算性能高度一致 |
| 依赖求解器能力 | 回溯式依赖求解(自 pip 20.3 起),对复杂跨包多版本求解较保守 | SAT 求解器(如 conda-libmamba-solver),全局统筹二进制与多语言依赖 |
| 环境隔离与轻量度 | 体积小、创建快速,适合 Docker 镜像与标准部署流水线 | 环境自包含度高但体积偏大,求解耗时较长(推荐搭配 mamba) |
三、安装与环境构建的标准操作流程
为了让不同场景的操作清晰可复现,以下分别展示使用 pip 与 conda 构建科学计算环境的标准执行步骤。
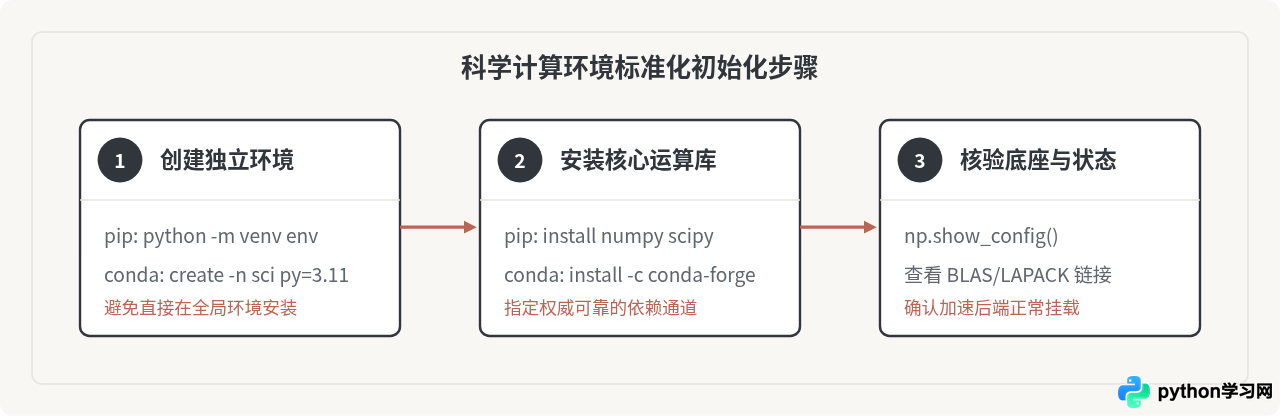
方案 A:使用 conda-forge 创建独立科学计算环境
如果选择 conda,强烈建议通过 Miniconda 或 Anaconda 搭配社区驱动的 conda-forge 频道。终端操作示例如下:
# 1. 创建指定 Python 版本的独立环境
conda create -n sci-env python=3.11 -y

# 2. 激活新创建的虚拟环境
conda activate sci-env

# 3. 指定 conda-forge 安装科学计算核心库(包含 OpenBLAS 或 MKL 运行时)
conda install -c conda-forge numpy scipy pandas matplotlib jupyterlab -y
方案 B:使用 pip 与标准 venv 构建环境
在已具备稳定系统环境或容器内,使用 pip 能够获得更精简的磁盘占用:
# 1. 初始化标准轻量虚拟环境
python3 -m venv .venv

# 2. 激活虚拟环境
source .venv/bin/activate  # macOS / Linux
# Windows 请执行: .venv\Scripts\activate

# 3. 升级 pip 并直接拉取预编译 Wheel 包
pip install --upgrade pip
pip install numpy scipy pandas matplotlib jupyterlab避坑提示:绝对不要在未激活虚拟环境的状态下直接运行 sudo pip install。这会混淆系统底层 Python 与应用依赖,导致包冲突且难以清理。
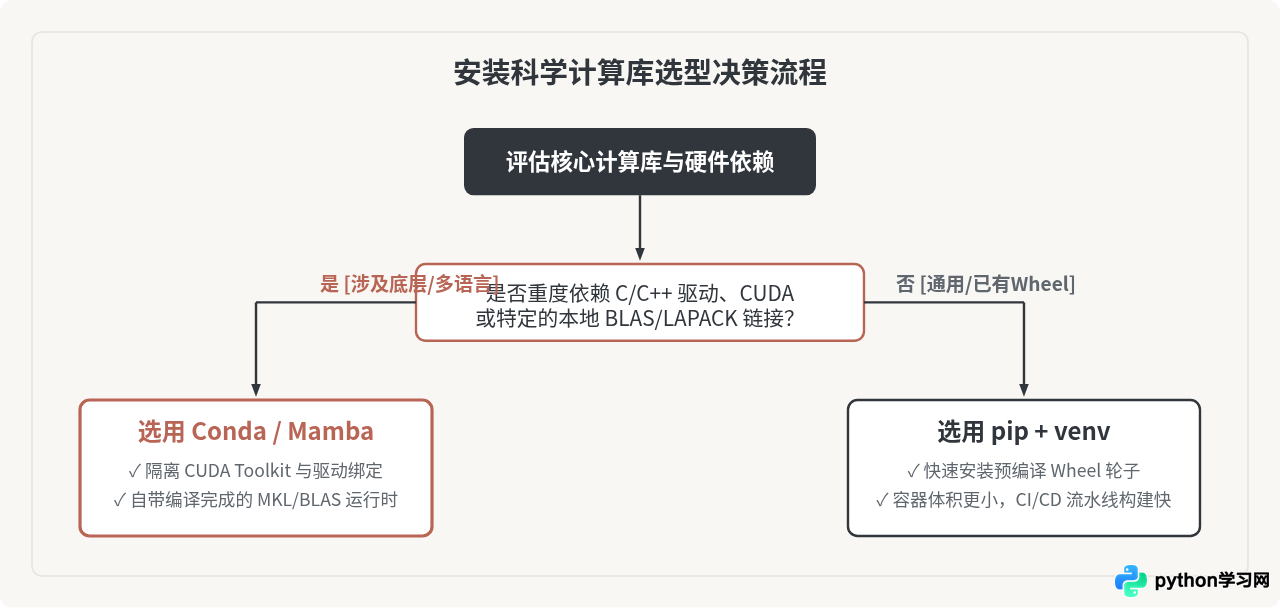
四、典型场景选型决策树
面对具体工程项目,你可以根据下列决策流程图快速定位最匹配的包管理方案:
五、混用两种工具的规范与隐患规避
在实际生产中,有些前沿库仅发布在 PyPI 上,而基础环境又必须依托 conda。此时必然涉及混合使用。如果不遵守依赖注入顺序,极易导致环境元数据损坏(所谓的“环境炸裂”)。
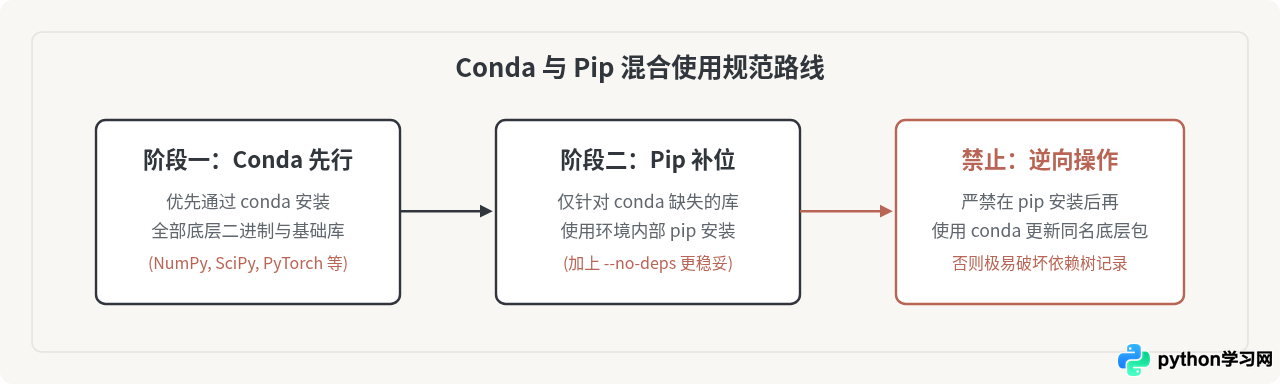
混合管理时的铁律是:先 conda 后 pip,pip 装完不再 conda。这是因为 pip 无法感知 conda 的依赖元数据仓库,如果后期再次运行 conda install,conda 求解器可能因为检测到文件系统被外部修改,而覆盖或降级关键共享库,导致难以排查的 ImportError: DLL load failed 或符号缺失异常。
六、安装后验证:确认底层线性代数库挂载
安装完成后,无论使用哪种工具,都应在 Python 交互环境中确认底层 BLAS/LAPACK 加速后端的具体实现。执行以下代码:
import numpy as np

# 打印当前 NumPy 链接的底层线性代数库详细配置
np.show_config()
在典型的 conda 安装环境下,输出通常会显示明确链接至 mkl_rt 或 libopenblas;而在通用 pip 安装中,则多显示由 Wheel 内置的打包版 OpenBLAS。通过这一验证,可以确保你的科学计算代码在矩阵乘法与分解运算时,真正跑在硬件加速的最佳路径上。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









