

Python读取非标准分隔符CSV文件的方法
全面讲解在Python中读取非标准分隔符(如分号、竖线、制表符、不定长空格及多字符标记)CSV文件的有效方案,涵盖内置csv模块与pandas核心配置及异常处理。
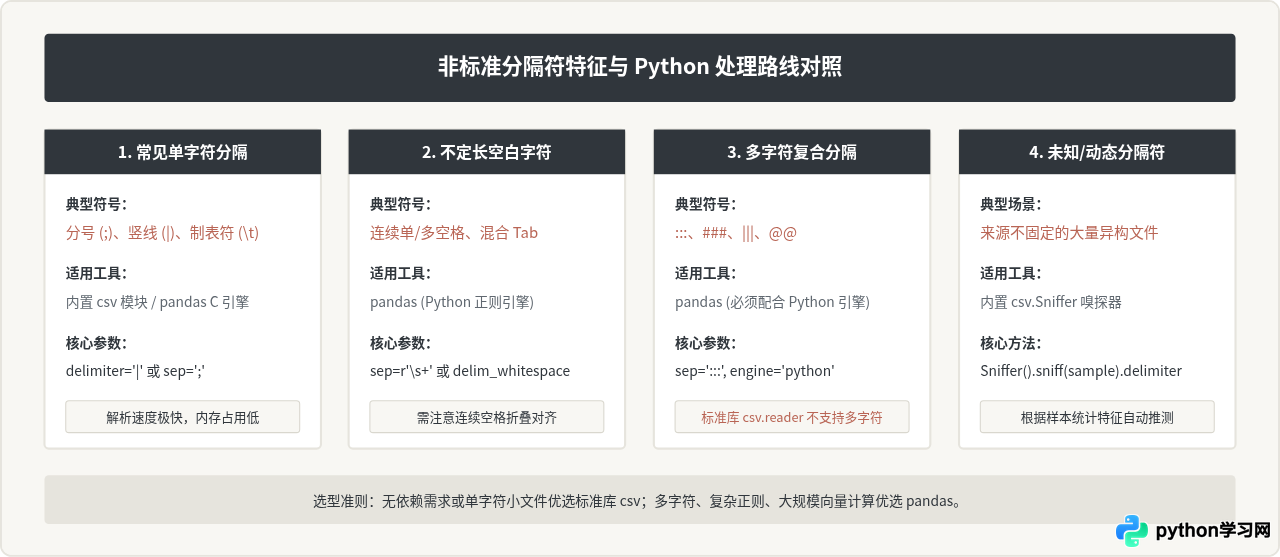
在数据处理任务中,虽然 CSV 格式名称包含“逗号分隔”(Comma-Separated Values),但实际工业生产与数据库导出文件中,经常会出现制表符(\t)、竖线(|)、分号(;)、多字符标记(如 :::)甚至是不定长空格等非标准分隔符。这类设计的初衷通常是为了避免文本字段内部逗号冲突,却给直接解析带来了阻碍。在 Python 中,解决这一问题主要依赖两套工具:无外部依赖的内置 csv 模块,以及擅长高效批量处理的第三方数据分析库 pandas。本文将按场景讲解具体读取方法、底层机制与核心参数配置。
方法一:使用 Python 内置 csv 模块
在不便安装第三方库或仅需轻量逐行处理的场景下,Python 标准库中的 csv 模块是最直接的选择。csv.reader 和 csv.DictReader 均提供了 delimiter 参数,允许显式指定单字符分隔符。
1. 手动指定已知单字符分隔符
例如,当文件使用竖线 | 作为字段切分标记时,直接在构造读取器时将 delimiter='|' 传入即可。以下是完整示例代码:
import csv

file_path = "dataset_pipe.csv"

# 示例数据内容格式:
# id|name|role
# 101|Alice|Developer
# 102|Bob|Tester

with open(file_path, mode="r", encoding="utf-8") as f:
    # 显式指定竖线作为字段分隔符
    reader = csv.reader(f, delimiter="|")
    header = next(reader)
    print("表头:", header)
    for row in reader:
print("数据行:", row)csv 模块中的底层 C 语言解析器强制要求 delimiter 必须是恰好一个字符(如 ';'、'\t'、'|')。如果传入长度大于 1 的字符串(例如 delimiter='||'),程序会直接抛出 TypeError: "delimiter" must be a 1-character string 异常。
2. 使用 csv.Sniffer 自动嗅探分隔符
当面对来自外部系统的批次文件且分隔符可能在逗号、分号、制表符之间变动时,可以使用 csv.Sniffer。它通过抽取文本前几个数据块的行结构和字符出现频率,自动判定最可能的分隔模式(Dialect):
import csv

file_path = "unknown_delimiter.csv"

with open(file_path, mode="r", encoding="utf-8") as f:
    # 读取前 2048 字节作为样本用于特征分析
    sample = f.read(2048)
    # 重置文件指针到起始位置,以便后续完整读取
    f.seek(0)

    # 自动识别方言并获取推断出的分隔符
    dialect = csv.Sniffer().sniff(sample)
    print(f"推断出的分隔符为: {repr(dialect.delimiter)}")

    # 将推断出的方言配置传入 reader
    reader = csv.reader(f, dialect=dialect)
    for row in reader:
        print(row)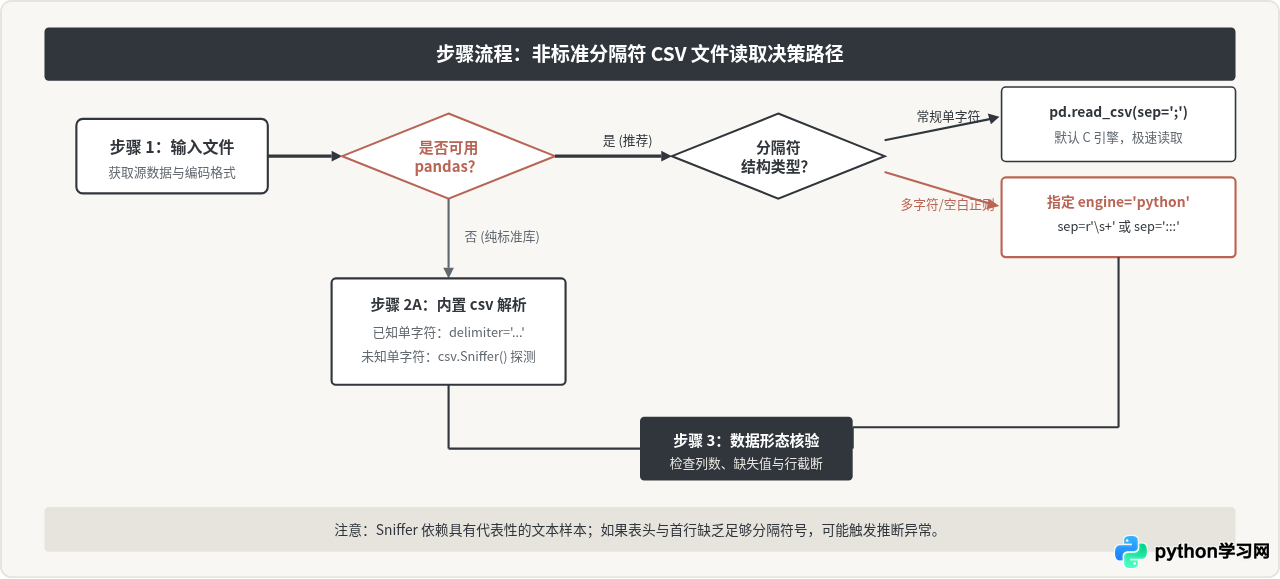
方法二:使用 Pandas 处理复杂与多字符分隔符
在涉及批量数据分析或复杂分隔符时,pandas.read_csv() 提供了更强、更灵活的解析能力。其核心参数为 sep(或 delimiter),同时内建了对正则表达式和长字符串标记的直接支持。
1. 读取单字符非标分隔符
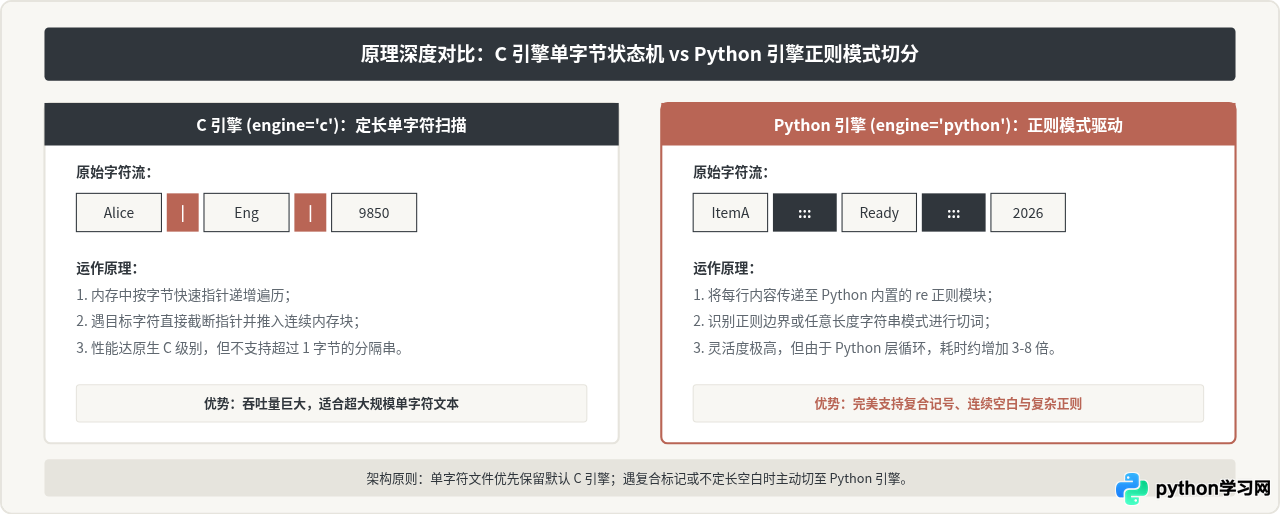
对于分号、竖线或 Tab 分隔符,传入 sep 即可。Pandas 默认使用高度优化的 C 语言解析引擎(engine='c'),在几秒内就能完成上百万行的解析:
import pandas as pd

# 读取分号分隔文件(常见于欧洲地区的数值导出文件)
df_semicolon = pd.read_csv("data_semicolon.csv", sep=";")

# 读取制表符分隔文件 (TSV)
df_tsv = pd.read_csv("data_tab.tsv", sep="\t")

print(df_semicolon.head())
2. 读取不定长空格分隔文件
许多科学计算软件(如 Fortran 输出或系统监控日志)导出的文本常使用多个空格对齐列。此时如果简单设置 sep=' ',会导致连续空格被拆分成大量空的无名列。正确的方法是传入正则表达式匹配一个或多个空白字符:
import pandas as pd

# 方式一:显式使用正则表达式,并声明 engine='python'
df_space = pd.read_csv("metrics.log", sep=r"\s+", engine="python")

# 方式二:在较早或兼容模式下使用专用快捷参数
# df_space = pd.read_csv("metrics.log", delim_whitespace=True)

print(df_space.info())
3. 读取多字符标记分隔符(如 ::: 或 |||)
某些文本日志或爬虫产物会使用 ::: 或 ||| 作为字段切分标记,彻底杜绝字段内容与分隔符混淆。对于这类多字符标记,Pandas 的 C 引擎无法支持,必须显式启用 Python 引擎:
import pandas as pd

# 读取三冒号分隔的多字符文件
df_multi = pd.read_csv("custom_export.txt", sep=":::", engine="python")

print(df_multi.shape)sep 的长度大于 1 字符或者包含正则元字符时,若未主动指定 engine='python',Pandas 会在运行时发出 ParserWarning: Falling back to the 'python' engine because the 'c' engine does not support regex separators 警告。主动声明 engine='python' 可以消除警告并显式确立代码执行行为。
常见边界问题与异常处理方案
在处理非标准分隔符文件时,通常还会伴随编码冲突、引号嵌套和脏数据行等问题。仅配置分隔符往往不足以顺利完成任务,以下是三类必须掌握的防御性配置:
1. 字段内包含分隔符与引号保护(Quoting)
如果某一列的值本身就包含分隔符(例如地址字段中含有分号 "Room 101; Tower A"),标准做法是用双引号将该字段包裹。解析时需确保引号转义机制处于开启状态:
import pandas as pd

# quotechar 默认为双引号,确保处于包裹状态下的分号不会被误判为列分割
df = pd.read_csv("addresses.csv", sep=";", quotechar='"')
2. 异常损坏行的跳过与日志追踪
工业数据中偶发某些行因意外换行或缺失分隔符导致字段数与表头不一致。默认情况下 Pandas 会抛出 ParserError 并中断整个流程。可以使用 on_bad_lines 参数进行过滤或告警:
import pandas as pd

# 跳过列数不匹配的脏行,防止程序崩溃中断
df = pd.read_csv("faulty_data.csv", sep="|", on_bad_lines="skip")

# 若希望在控制台打印被跳过的脏行内容,可设置为 'warn'
# df = pd.read_csv("faulty_data.csv", sep="|", on_bad_lines="warn")
3. 字符编码(Encoding)协同配置
非标准分隔符文件往往来自特定工业软件或旧版 Windows 数据库,极容易出现 UnicodeDecodeError。需根据文件来源指定编码:
- 微软 Excel 导出的带 BOM UTF-8 文件:配置
encoding='utf-8-sig'。 - 国内传统数据库或旧系统导出的中文字符:配置
encoding='gbk'或encoding='gb18030'。
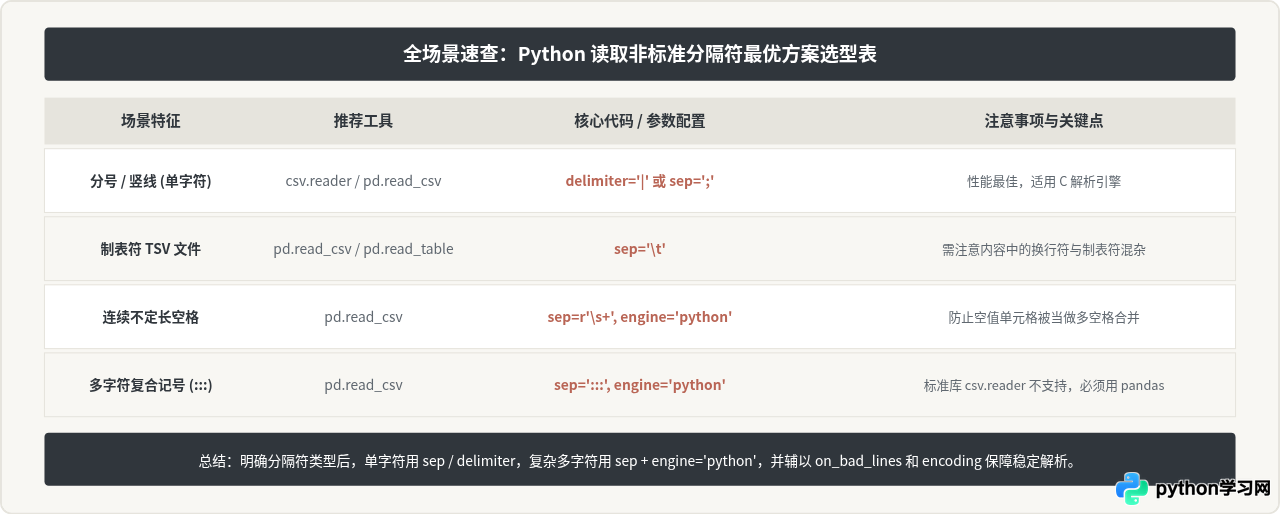
总结
读取非标准分隔符 CSV 文件的关键在于准确识别分隔符形态并匹配正确的解析引擎:
- 对于常规的单字符非标准分隔符(如
;或|),标准库csv.reader(delimiter='...')和pd.read_csv(sep='...')均能完美处理,且 Pandas 的 C 引擎可提供最高吞吐量。 - 对于连续空格或多字符复合记号(如
\s+或:::),应优先使用pandas.read_csv,并显式指定engine='python'以启用正则匹配能力。 - 在批处理自动化场景中,可结合
csv.Sniffer实现单字符分隔符的自动探测;面对现实脏数据时,务必协同配置encoding与on_bad_lines='skip',构建健壮的数据提取管道。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









