

Python中文字符串长度计算:len()与字节长度的区别
发布时间:2026-11-19| 4人浏览过
深入解析Python中计算中文字符串长度的核心机制,对比len()字符计数与encode()字节长度的本质区别、编码实现方式及实际业务场景选型指南。
核心结论:在 Python 3 中,直接调用
len() 返回的是逻辑字符数量(Unicode 码点个数),一个英文字符计数为 1,一个中文字符计数同样为 1。如果要获取字符串在存储或传输时实际占用的字节长度(Byte Length),必须显式调用 encode() 将其转为字节序列后再调用 len()。在 UTF-8 编码下一个汉字通常占用 3 个字节,在 GBK 编码下则占用 2 个字节。
1. 核心概念对比:字符长度与字节长度
很多刚从其他语言或从 Python 2 迁移过来的开发者,常常会对 Python 3 的字符串长度产生误解。理解二者区别的关键,在于厘清“字符(Character)”与“字节(Byte)”的底层抽象。
字符是人类书写语言的视觉符号(例如字母 'a'、汉字 '中'、标点 ','),而字节是计算机存储和网络传输的基本物理单元(每个字节由 8 个二进制位组成,取值范围为 0 到 255)。
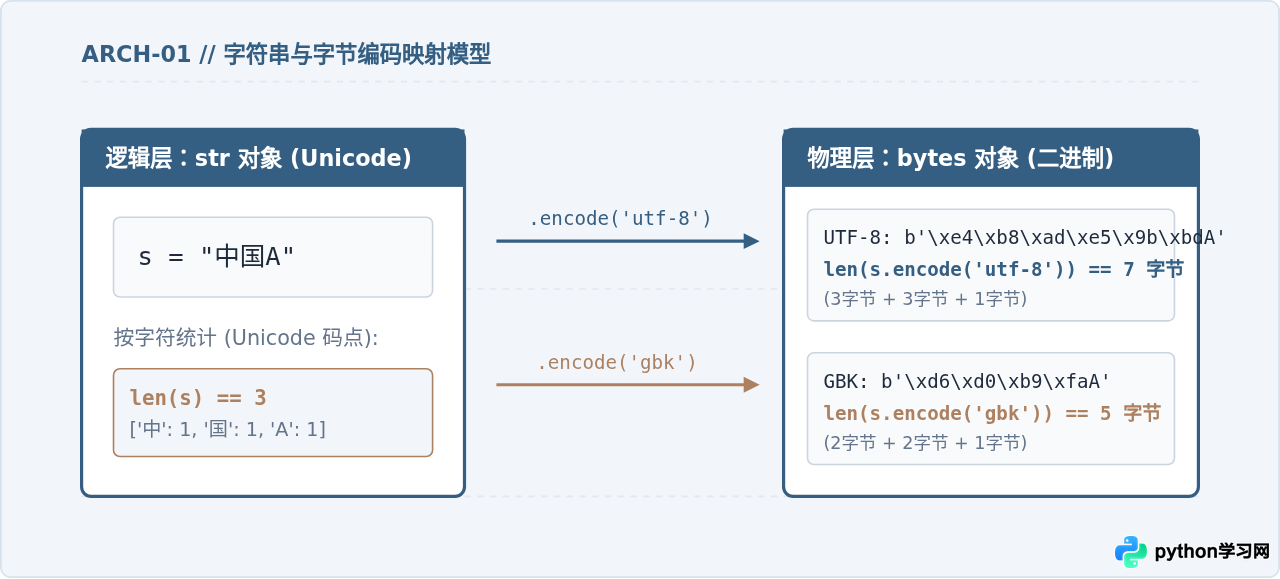
运行以下示例代码可以直观看到计算结果的差异:
# 示例代码:查看字符串长度与字节长度
text = "你好,Python"

# 1. 计算字符数
char_len = len(text)
print(f"字符长度 len(text): {char_len}")  # 输出: 9

# 2. 计算 UTF-8 编码下的字节长度
utf8_bytes = text.encode('utf-8')
print(f"UTF-8 字节长度: {len(utf8_bytes)}")  # 输出: 15 (3个汉字*3 + 1个中文逗号*3 + 6个ASCII字母*1)

# 3. 计算 GBK 编码下的字节长度
gbk_bytes = text.encode('gbk')
print(f"GBK 字节长度: {len(gbk_bytes)}")  # 输出: 14 (3个汉字*2 + 1个中文逗号*2 + 6个ASCII字母*1)
2. 常见编码格式对中文字节占用的影响
脱离编码格式去谈“中文字符占几个字节”是不严谨的。在 Python 3 中,字符串在内存中以 Unicode 规范进行统一管理,只有当需要将其落盘存储或通过套接字发送时,才具体转换为某种编码格式:
- UTF-8 编码:变长编码方案。ASCII 字符占 1 字节;常用中文字符(基本汉字区间 U+4E00 至 U+9FA5)占用 3 个字节;少数极冷僻汉字或特定 Emoji 占用 4 个字节。
- GBK / GB2312 编码:双字节中文编码方案。ASCII 字符占 1 字节;简体中文字符固定占用 2 个字节。
- UTF-16-LE / BE:绝大多数常用字符(包括中文字符与英文字母)均占用 2 个字节。
- ASCII 编码:仅支持标准 128 个英文字符与控制符。如果尝试对中文字符执行
text.encode('ascii'),Python 会直接抛出UnicodeEncodeError异常。
| 测试字符串 | 字符数 (len) | UTF-8 字节数 | GBK 字节数 | UTF-16 字节数 (含BOM) |
|---|---|---|---|---|
"A" |
1 | 1 | 1 | 4 (2字节数据+2字节BOM) |
"中" |
1 | 3 | 2 | 4 (2字节数据+2字节BOM) |
"中国" |
2 | 6 | 4 | 6 (4字节数据+2字节BOM) |
"Python编程" |
8 | 12 (6+3*2) | 10 (6+2*2) | 18 (16+2) |
3. 准确计算字节长度的操作流程
在工程实现中,计算字节长度并不是简单写一行代码,而是需要明确编码格式、处理可能存在的编码异常,并形成标准化的处理链路。
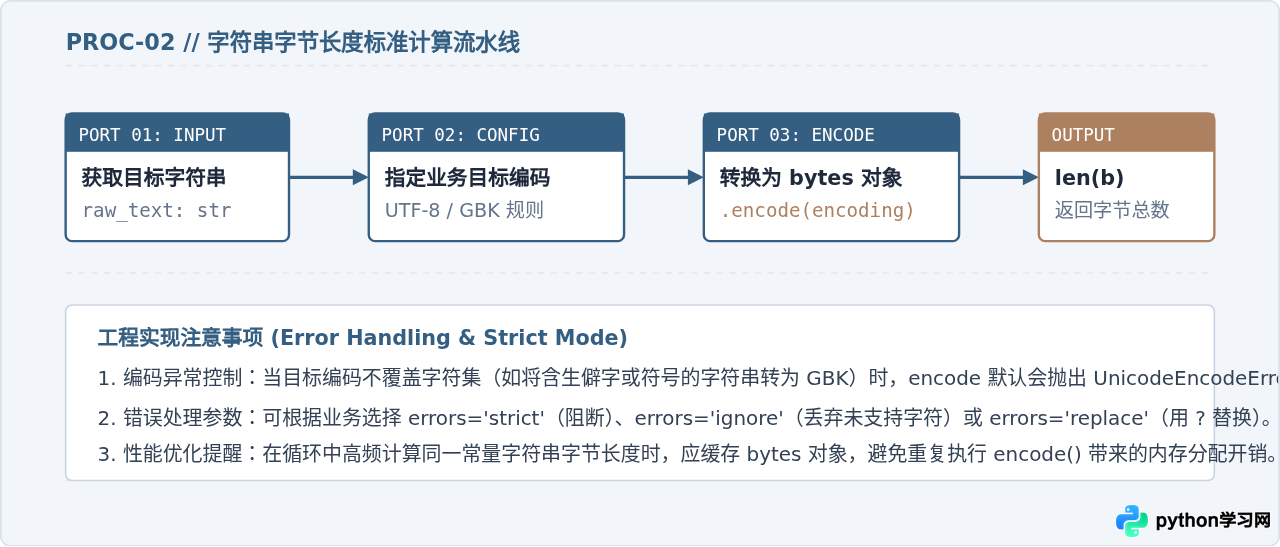
推荐封装如下函数作为公共工具方法:
def get_byte_length(text: str, encoding: str = 'utf-8', errors: str = 'strict') -> int:
    """
    安全计算字符串在指定编码下的字节长度

    :param text: 输入字符串
    :param encoding: 字符编码,默认 'utf-8',支持 'gbk', 'ascii' 等
    :param errors: 编码异常处理机制,默认为 'strict'
    :return: 字节总数
    """
    if not isinstance(text, str):
        raise TypeError(f"预期输入 str 类型,实际得到 {type(text).__name__}")

    return len(text.encode(encoding, errors=errors))

# 调用示例
print(get_byte_length("Python中文字符串", encoding="utf-8"))  # 输出: 21
print(get_byte_length("Python中文字符串", encoding="gbk"))    # 输出: 16
4. 业务场景中的三个长度维度:字符数、字节数与显示宽度
在实际开发中,开发者面临的需求往往不仅仅是“字符数”与“字节数”,还经常遇到排版对齐带来的“显示宽度”需求。这三个维度的应用场景截然不同:
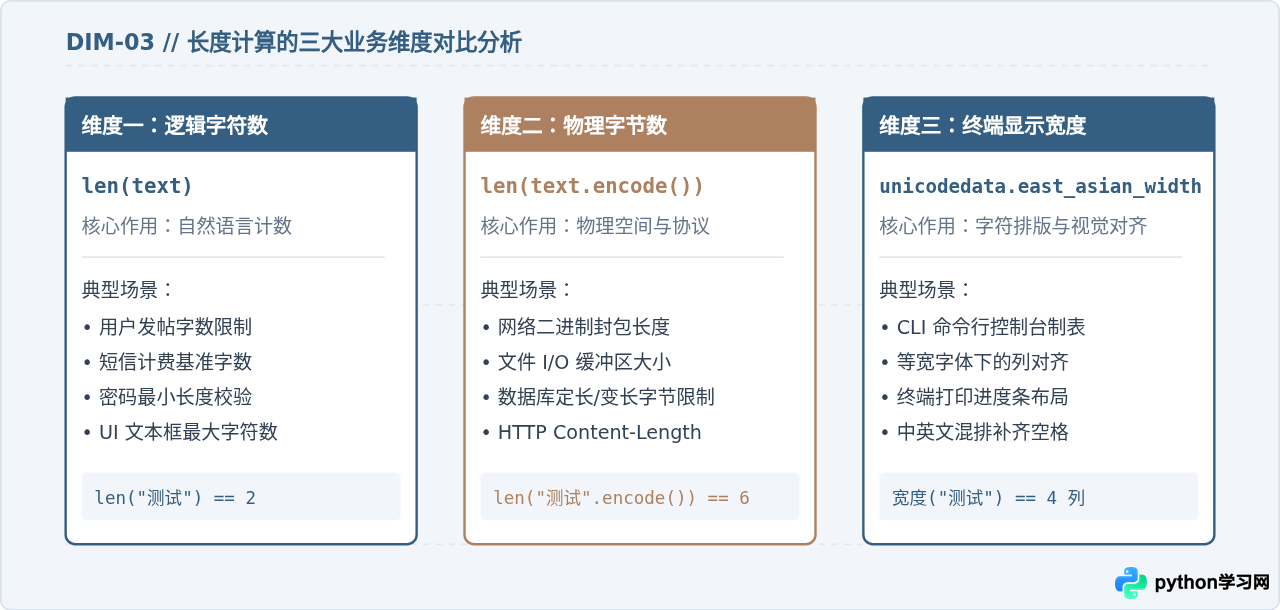
注意:在控制台打印表格时,不能使用
len() 进行 str.ljust() 填充,因为一个汉字在屏幕上占据两个英文字符的宽度(全角字符),但 len() 只计为 1。此时应使用 Python 内置的 unicodedata.east_asian_width() 函数计算东亚字符宽度。
import unicodedata

def get_display_width(text: str) -> int:
    """计算字符串在终端等宽字体下的视觉显示宽度"""
    width = 0
    for char in text:
        status = unicodedata.east_asian_width(char)
        # 'W' 代表 Wide(宽字符/全角),'F' 代表 Fullwidth
        if status in ('W', 'F'):
            width += 2
        else:
            width += 1
    return width

# 对比三种长度:
text = "Python中文"
print("len() 字符数:", len(text))                                 # 8
print("UTF-8 字节数:", len(text.encode('utf-8')))                 # 12
print("终端显示宽度:", get_display_width(text))                   # 10 (6个字母*1 + 2个汉字*2)
5. 常见开发误区与避坑指南
-
误区一:混淆 Python 2 与 Python 3 的行为差异
在已经淘汰的 Python 2 中,默认的str实际上是字节串(byte string),对包含中文的str执行len()得到的是字节数;而在 Python 3 中,str严格为 Unicode 字符串,len()始终返回字符数。老项目迁移时必须重点核查。 -
误区二:按字节截断字符串导致半个汉字(乱码)
如果系统要求“内容不得超过 10 个字节”,切忌直接切片字节数组后强行解码:
正确方案:在字符级别计算累计字节数逐步截断,或者使用# 错误的做法:直接截断 bytes 可能截断字符内部字节 raw = "你好世界" b = raw.encode('utf-8') # 12 字节: 每个汉字3字节 # 如果强行截取前 10 个字节: try: truncated = b[:10].decode('utf-8') except UnicodeDecodeError as e: print(f"解码失败: {e}") # 第4个汉字只留下了第1个字节,导致解码失败decode('utf-8', errors='ignore')自动丢弃残缺字节。 -
误区三:数据库字段配置的字符与字节混淆
在 MySQL 5.0 之后,VARCHAR(20)代表最多存储 20 个字符,不论中英文均可存 20 个;而在 Oracle 中,若未指定单位,VARCHAR2(20)默认指 20 个字节,如果采用 AL32UTF8 编码,最多只能存 6 个汉字。在编写 Python 校验逻辑前,必须确认底层数据库的具体定义。
6. 总结与选型对照
为了在实际编码过程中快速做出正确判断,可参考下方的选型决策对照模型:
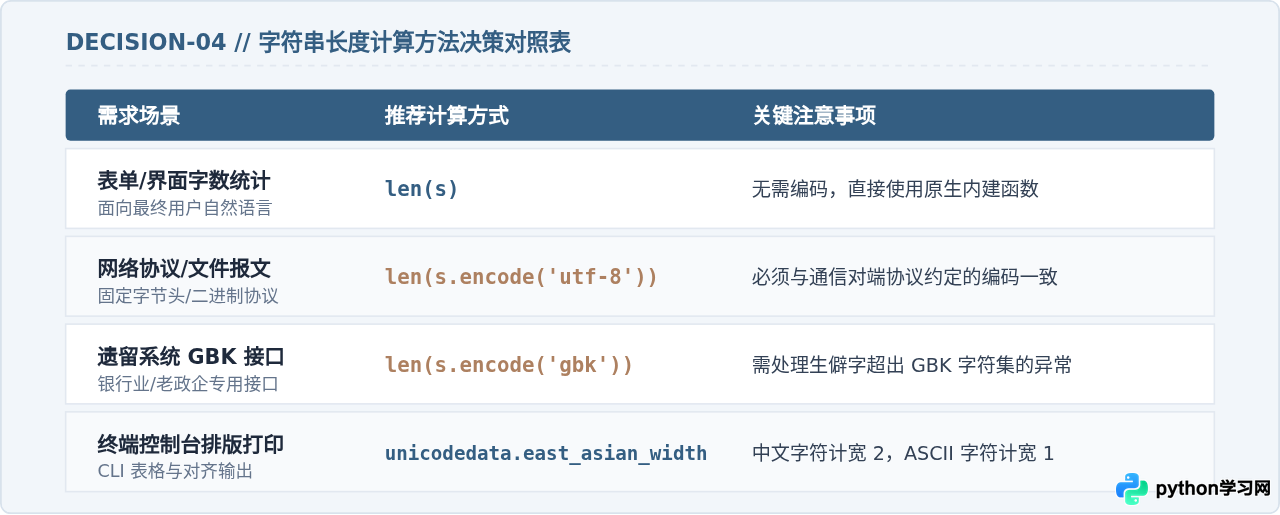
掌握 len() 与字节长度的本质差异,核心在于区分逻辑表示与物理存储。在编写涉及时长、容量、校验与传输的 Python 程序时,始终明确当前操作面向的是用户阅读界面还是底层字节流,即可准确选用正确的计算方式。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









