

Python主流Web开发与爬虫第三方库推荐
针对Python主流Web开发与网络爬虫第三方库进行深度梳理与推荐,涵盖Django、Flask、FastAPI、Requests、HTTPX、Scrapy与Playwright的定位、选型依据、实战示例与技术协同。
在Python技术生态中,Web服务端开发与网络爬虫是两项紧密关联且应用极其广泛的技术方向。构建一个稳定可靠的系统,关键在于根据业务规模、并发需求和团队维护成本,选用最合适的第三方库。本文直接梳理当前Python在Web后端与数据采集领域的主流库,分析它们的核心机制、典型场景与选型边界,并提供直接可用的代码示例与协同方案。
一、主流Web开发框架选型分析
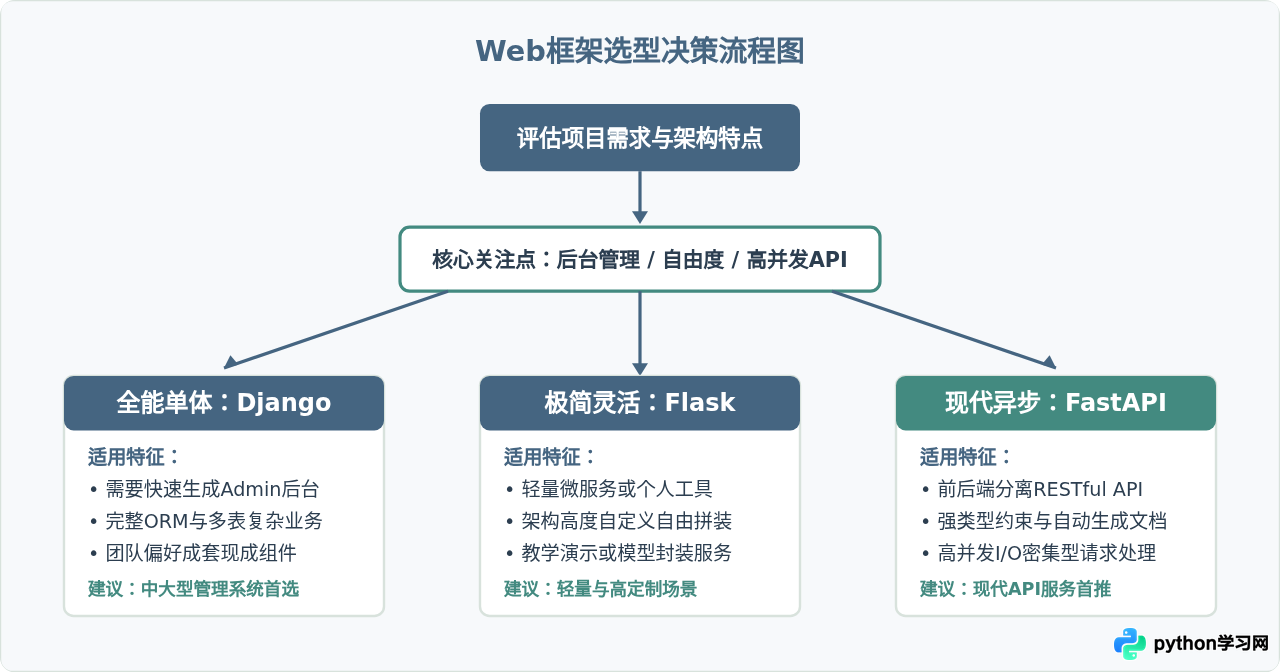
Python Web框架经历了从传统全栈单体到现代异步微服务的演进。目前技术选型已高度收敛于三大主力:Django、Flask与FastAPI。选择框架的本质是选择开发约束与扩展灵活度之间的平衡点。
1. Django:成熟稳健的全能型框架
Django秉持“电池齐备(Batteries-Included)”理念,内置了强大的ORM对象关系映射、自动化Admin管理后台、身份认证系统及防CSRF/SQL注入机制。当项目需要快速上线包含用户权限、内容管理和多模型交互的企业级应用时,Django能节省大量基础架构代码。
但全功能也意味着较高的学习曲线和较强的技术侵入性。Django更适合团队协作规范严格、需要快速建立业务骨架的场景,而不适合追求微内核与极限自定义的简单脚本服务。
# views.py (Django视图函数示例)
from django.http import JsonResponse
from django.views.decorators.http import require_GET

@require_GET
def health_check(request):
    return JsonResponse({
        "status": "success",
        "service": "Django Application",
        "version": "5.0"
    })
2. Flask:极简轻量的微型框架
Flask遵循微内核架构,核心仅包含WSGI封装(Werkzeug)与模板引擎(Jinja2)。数据库连接、权限校验、表单验证等均以插件或自定义形式按需引入(如Flask-SQLAlchemy、Flask-Login)。
Flask的优势在于上手快、侵入性弱、自由度高,是轻量工具接口、机器学习模型快速部署和微型Web站点的首选。由于其缺乏强制的项目目录约束,在大型复杂团队项目中需要开发者自行制定严密的工程化规范,否则容易出现结构松散、耦合严重的问题。
# app.py (Flask基础应用示例)
from flask import Flask, jsonify

app = Flask(__name__)

@app.route("/api/status", methods=["GET"])
def get_status():
    return jsonify({
        "status": "online",
        "framework": "Flask"
    })

if __name__ == "__main__":
    app.run(host="0.0.0.0", port=5000)
3. FastAPI:现代高性能异步API框架
FastAPI基于ASGI标准(Starlette与Uvicorn),深度结合了Python 3.7+的原生类型提示(Type Hints)与Pydantic数据验证机制。它在提供接近Node.js/Go级别的高并发吞吐性能的同时,能根据代码自动生成符合OpenAPI规范的交互式Swagger文档。
在当前前后端分离、微服务集群和AI/数据服务API盛行的背景下,FastAPI已成为构建高性能RESTful API的新标准。需要注意的是,要完全发挥其性能优势,数据库驱动与外部HTTP调用必须全面采用异步版本(如asyncpg、HTTPX)。
# main.py (FastAPI典型接口示例)
from fastapi import FastAPI
from pydantic import BaseModel

app = FastAPI(title="数据服务接口", version="1.0.0")

class TaskPayload(BaseModel):
    task_name: str
    target_count: int

@app.post("/tasks/create")
async def create_task(payload: TaskPayload):
    # 自动进行类型检查与数据校验
    return {
        "code": 200,
        "message": "任务创建成功",
        "data": payload.model_dump()
    }
二、主流网络爬虫第三方库推荐
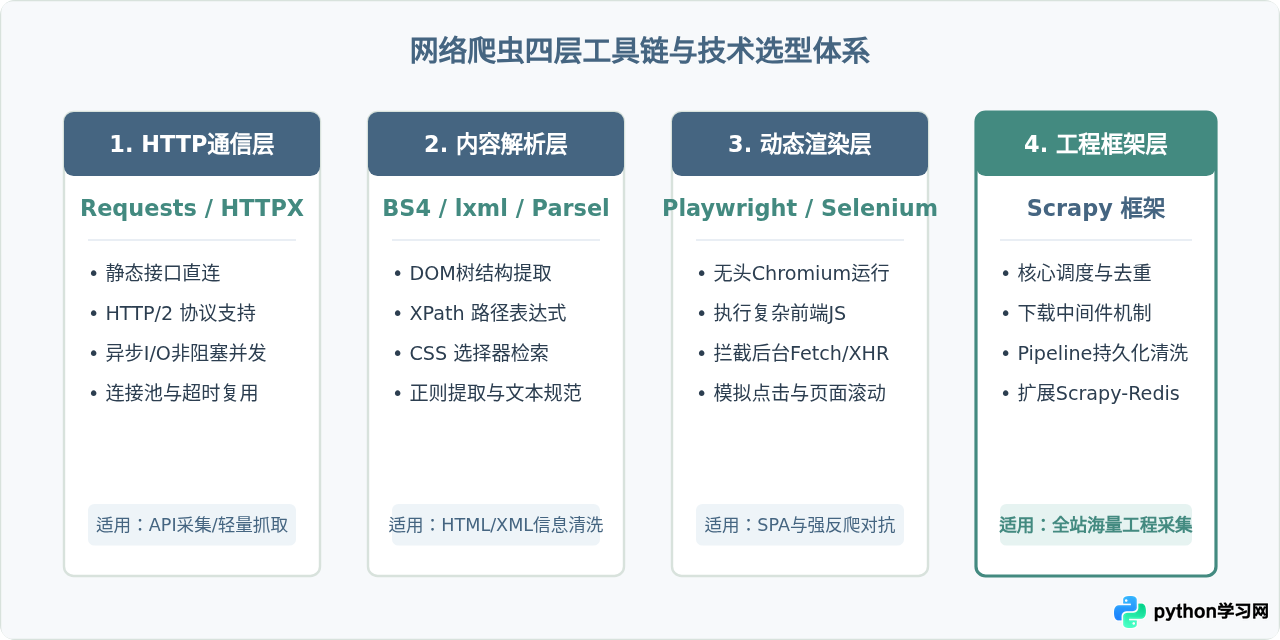
网络爬虫在Python生态中已形成明确的分层工具链:从底层的HTTP通信、中间层的数据解析,到处理动态渲染的浏览器自动化工具,以及顶层的分布式爬虫框架。根据目标站点的技术特征选型,能够成倍提高抓取效率与开发稳定性。
1. HTTP通信库:Requests 与 HTTPX
Requests:Python生态中使用最广泛的同步HTTP客户端,API设计极其人性化。对于接口请求简单、网页为静态渲染、无极高并发要求的抓取任务,Requests是稳定可靠的基石。
HTTPX:下一代HTTP客户端,完全兼容Requests的常用API,同时原生支持HTTP/2协议以及基于asyncio的异步并发请求。在需要单机高并发抓取海量接口或与FastAPI深度结合时,HTTPX是替代Requests的理想方案。
# 同步Requests基础调用
import requests

resp = requests.get("https://api.github.com/events", timeout=10)
if resp.status_code == 200:
    data = resp.json()
    print("获取事件数量:", len(data))

# 异步HTTPX并发调用
import httpx
import asyncio

async def fetch_page(url):
    async with httpx.AsyncClient(http2=True) as client:
        r = await client.get(url, timeout=10.0)
        return r.status_code
2. 结构解析库:BeautifulSoup4 与 lxml / Parsel
BeautifulSoup4(BS4):语法简单直观,对破损或不规范的HTML结构具备良好的容错能力,底层可灵活绑定Python内置html.parser或lxml解析器。适合初学者或对解析性能要求不高的页面抓取。
lxml 与 Parsel:lxml基于C语言库libxml2与libxslt编写,执行效率极高,支持标准的XPath 1.0与CSS选择器;Parsel则是Scrapy底层抽离出来的选择器库,结合了XPath与CSS选择器的优势。在大规模HTML文本提取时,使用lxml/Parsel相比纯BS4能带来数倍的解析加速。
# Parsel多方式精准提取示例
from parsel import Selector

html_content = """
<div class="content">
  <h1>文章标题</h1>
  <a href="/detail/101" class="read-more">阅读详情</a>
</div>
"""
sel = Selector(text=html_content)
title = sel.css("div.content h1::text").get()
link = sel.xpath("//a[contains(@class, 'read-more')]/@href").get()
print(f"解析结果: 标题={title}, 链接={link}")
3. 动态渲染与浏览器自动化:Playwright
随着现代前端单页应用(SPA)与复杂反爬技术的普及,许多网页数据依赖JavaScript异步加载或经过高强度混淆。传统HTTP请求难以直接获取有效内容,此时需要无头浏览器参与渲染。
Playwright:由微软开源的现代化浏览器自动化库,逐渐取代老旧繁琐的Selenium。Playwright原生支持多标签页、事件驱动等待(无需机械设置sleep)、全异步操作(asyncio)以及网络请求拦截与改写。不仅能真实渲染JS,还能监听拦截后台JSON接口数据,抓取效率大幅优于传统模拟操作。
# Playwright异步抓取示例
import asyncio
from playwright.async_api import async_playwright

async def run_crawler():
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        page = await browser.new_page()
        await page.goto("https://news.ycombinator.com", wait_until="networkidle")
        title = await page.title()
        print("页面标题:", title)
        await browser.close()

# asyncio.run(run_crawler())
4. 工业级爬虫框架:Scrapy
当爬虫任务从“单页抓取”演变为“站点级全量采集”或“周期性分布式抓取”时,纯脚本编写往往面临调度混乱、去重失效、连接池耗尽等工程难题。Scrapy基于Twisted异步网络引擎,提供了工业级的解决方案:
- 内建引擎与调度器:自带高效的内存/磁盘请求队列与指纹去重(RFPDupeFilter)。
- 中间件体系:通过Downloader Middleware统一管理User-Agent轮转、代理IP池注入与Cookie管理。
- Item Pipeline清洗管道:解耦数据抽取与持久化存储(如自动写入MySQL/MongoDB/Elasticsearch)。
三、系统协同:爬虫采集与Web后端的数据闭环
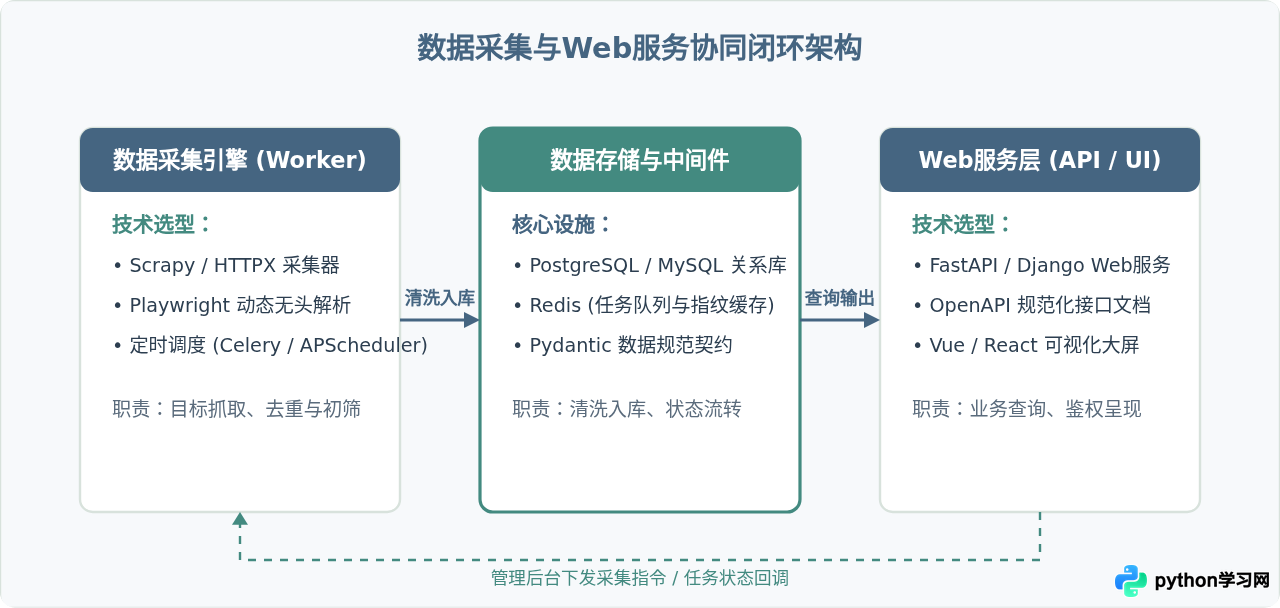
在实际生产环境中,网络爬虫与Web后端往往不是割裂存在的。最普遍的架构是由爬虫负责外部数据的抓取与初筛,入库后由Web服务(如Django或FastAPI)负责数据校验、业务聚合与前端展示。
构建数据闭环的关键在于解耦调度与服务:
- 解耦采集与展示:爬虫模块独立运行,不占用Web主服务的Worker进程。通常借助Celery分布式任务队列或Redis消息队列触发调度。
- 统一数据模型约束:在写入数据库前,使用Pydantic或Django ORM Model作为统一的数据契约,杜绝爬虫脏数据污染核心数据库。
- 服务化对外输出:Web端(如FastAPI)通过只读视图或聚合接口,向管理后台和前端用户输出结构化数据。
四、主流库核心技术指标与选型矩阵
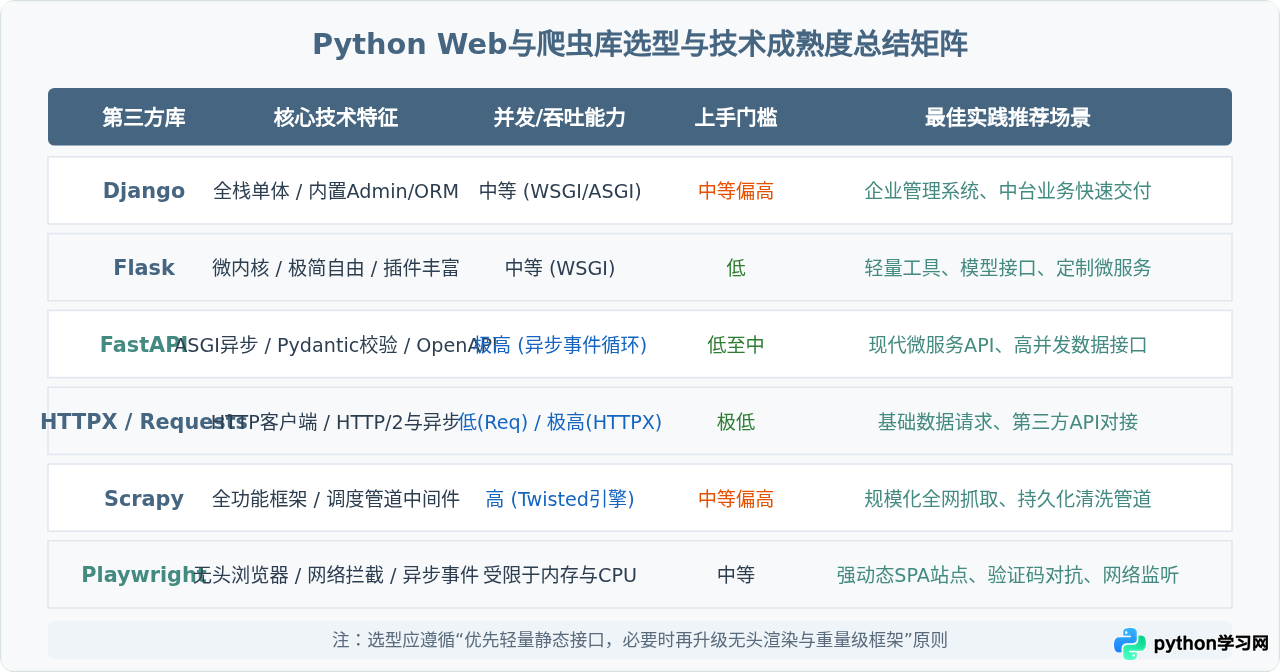
为了帮助读者根据实际团队状况快速做出判断,以下整理了本文推荐的Python主流Web与爬虫库在性能、学习难度与适用场景上的横向对比:
五、工程实施与选型注意事项
在爬虫选型中,很多初学者在面对简单接口时直接上手复杂的Scrapy或启动昂贵的Playwright浏览器集群。实际上,只要通过浏览器的开发者工具(F12)找到真实数据返回的JSON接口,一个使用Requests或HTTPX的轻量脚本通常比无头浏览器快数十倍,且资源消耗极低。
在Web后端开发中,若决定拥抱FastAPI等异步生态,务必注意代码库内部的调用链条一致性。如果在async def定义的异步路径函数中调用了阻塞式的代码(例如传统的time.sleep()或同步数据库驱动),将直接阻塞主事件循环线程,导致所有并发请求排队挂起。在混合使用同步与异步库时,应使用anyio.to_thread.run_sync()或标准线程池将其隔离执行。
综上所述,当开发完整的现代Python网络应用时,“FastAPI提供对外接口 + HTTPX/Playwright按需抓取 + PostgreSQL/Redis存储调度”已成为兼顾开发体验、性能与可维护性的主流工业级组合。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









