

使用asyncio.gather和TaskGroup高效管理Python并发任务
深入解析Python异步并发中asyncio.gather与TaskGroup的工作原理、代码示例、异常传播机制与工程选型建议。
在 Python 异步编程中,同时分发并聚合多个 I/O 密集型任务是提高吞吐量的常规手段。Python 提供了历史悠久的 asyncio.gather 函数,并在 Python 3.11 中引入了基于结构化并发理念的 asyncio.TaskGroup 上下文管理器。解决多任务并发的核心在于两点:一是如何将任务高效发起并在全部完成后收集结果,二是在任务发生异常或取消时如何确保资源不泄漏且没有未决任务漂移在事件循环中。
一、并发执行模型与生命周期边界
要选择合适的并发工具,首先需要理解它们在协程生命周期管理机制上的根本差异。传统方法与现代结构化并发的核心区别在于是否拥有强约束的作用域边界。
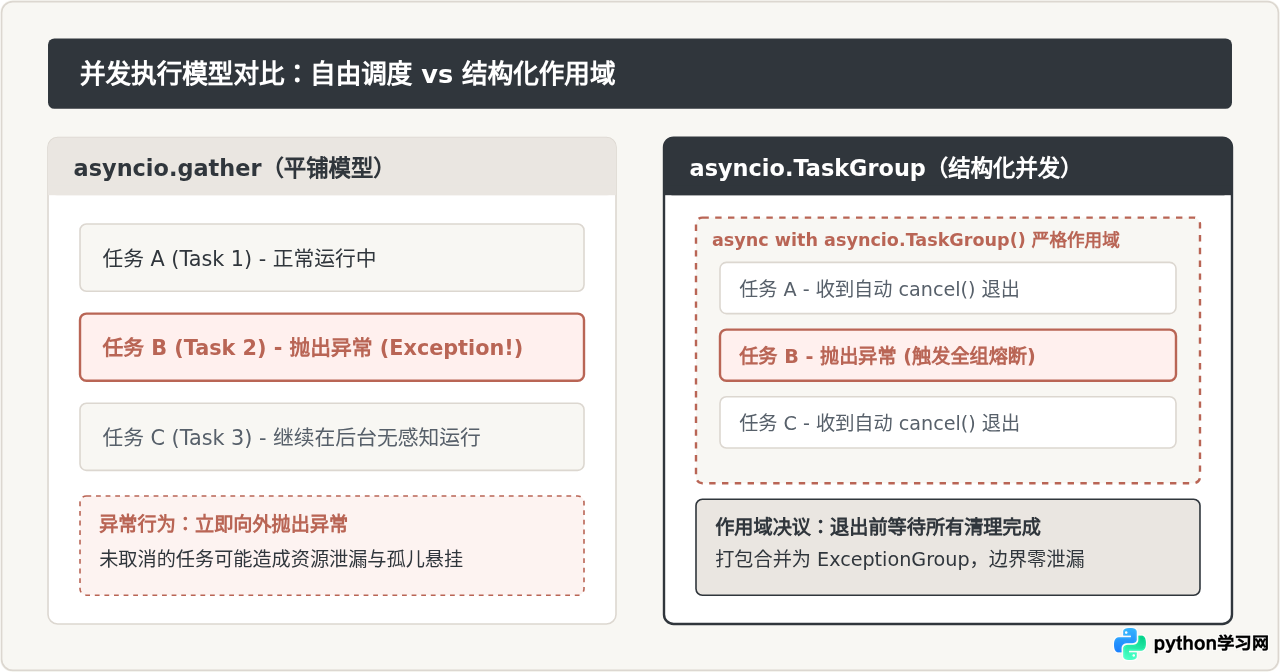
asyncio.gather 是一种“无强边界”的任务聚合工具。当你把一组协程传递给 gather 时,它将它们包装为 asyncio.Task 并交给全局事件循环调度。如果其中某一个任务抛出异常,默认情况下 gather 会立即向外部调用者抛出该异常,但其余正在运行的任务并不会被自动取消,而是继续在后台运行,形成“孤儿任务”(Orphan Tasks)。
与此相对,asyncio.TaskGroup 引入了结构化并发(Structured Concurrency)规范。它通过 async with 代码块建立明确的进入与退出边界。只有当代码块内创建的所有任务全部执行完成(无论是正常结束还是被取消),执行流才会离开上下文;一旦某个任务出错,TaskGroup 会立即向同组内所有其他活跃任务发送取消信号,并等待它们清理退出,彻底杜绝孤儿任务。
二、使用 asyncio.gather 收集并发结果
asyncio.gather 是 Python 3.4 起内置的经典并发工具。其核心应用场景在于:传入多个可等待对象(协程或 Task),等待它们全部就绪,并按传入的先后顺序返回由各任务返回值组成的列表。
1. 基础用法与顺序一致性
gather 保证返回结果的列表顺序与传入参数的顺序完全一致,而不管各个任务实际上谁先执行完毕。下面是一个抓取多个数据源的标准示例:
import asyncio

async def fetch_data(service_id: int, delay: float) -> dict:
    await asyncio.sleep(delay)
    return {"service_id": service_id, "status": "ok"}

async def main():
    # 同时并发发起三个耗时不同的请求
    results = await asyncio.gather(
        fetch_data(1, 0.5),
        fetch_data(2, 0.1),
        fetch_data(3, 0.3)
    )
    # 结果按传入顺序组织,即使 service_id 2 最先完成
    for item in results:
        print(f"收到结果: {item}")

if __name__ == "__main__":
    asyncio.run(main())
运行结果示例:
收到结果: {'service_id': 1, 'status': 'ok'}
收到结果: {'service_id': 2, 'status': 'ok'}
收到结果: {'service_id': 3, 'status': 'ok'}
2. return_exceptions 参数的两种策略
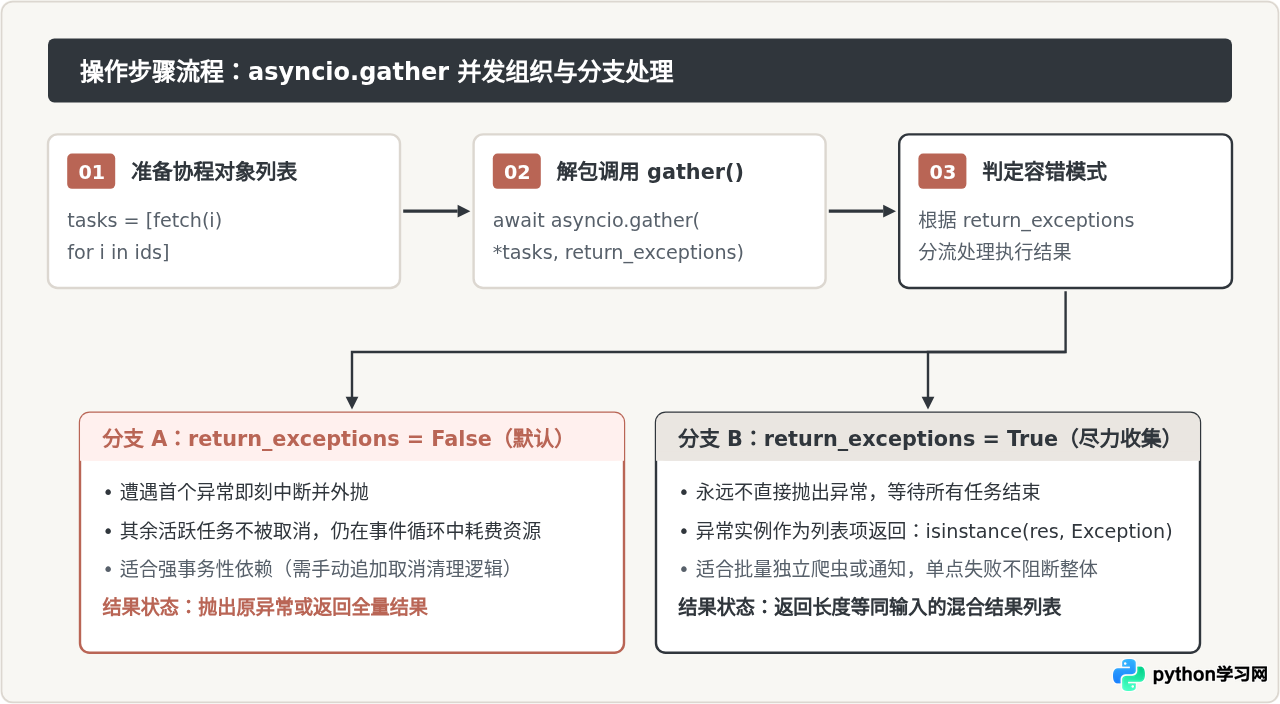
在生产环境中,网络 I/O 随时可能失败。asyncio.gather 提供了 return_exceptions 关键参数(默认值为 False):
return_exceptions=False(默认):一旦任意一个协程抛出异常,await asyncio.gather(...)会立即抛出该异常,主调用链中断。此时其他协程仍在运行。return_exceptions=True:将异常作为正常结果对象返回。返回列表中成功项为返回值,失败项为对应的Exception实例,不会抛出异常中断执行流。
async def fetch_with_fail(service_id: int):
    if service_id == 2:
        raise ValueError(f"服务 {service_id} 拒绝连接")
    await asyncio.sleep(0.1)
    return f"数据_{service_id}"

async def main_tolerant():
    # 开启 return_exceptions=True,实现尽力收集(Best-effort)
    results = await asyncio.gather(
        fetch_with_fail(1),
        fetch_with_fail(2),
        fetch_with_fail(3),
        return_exceptions=True
    )

    for idx, res in enumerate(results, start=1):
        if isinstance(res, Exception):
            print(f"任务 {idx} 失败: {res}")
        else:
            print(f"任务 {idx} 成功: {res}")
三、使用 asyncio.TaskGroup 实现现代结构化并发
在 Python 3.11 及以上版本中,官方推荐使用 asyncio.TaskGroup。它基于上下文管理器实现,解决了 gather 无法安全处理关联任务取消的痛点。任何在 TaskGroup 内部启动的任务,其生命周期都严格受限于该 async with 代码块。
1. TaskGroup 的标准语法
使用 TaskGroup 时,任务通过 tg.create_task() 动态派发。代码不需要对所有任务执行解包,结构更为自然直观:
import asyncio

async def worker(task_id: int, duration: float) -> str:
    await asyncio.sleep(duration)
    return f"任务 {task_id} 完成"

async def main():
    tasks = []
    async with asyncio.TaskGroup() as tg:
        for i in range(1, 4):
            # 将创建的任务句柄收集起来,供退出上下文后读取结果
            t = tg.create_task(worker(i, i * 0.1))
            tasks.append(t)

    # 离开 async with 时,保证所有任务已全部完成
    for t in tasks:
        print(t.result())

if __name__ == "__main__":
    asyncio.run(main())
2. 异常自动级联取消与 ExceptionGroup
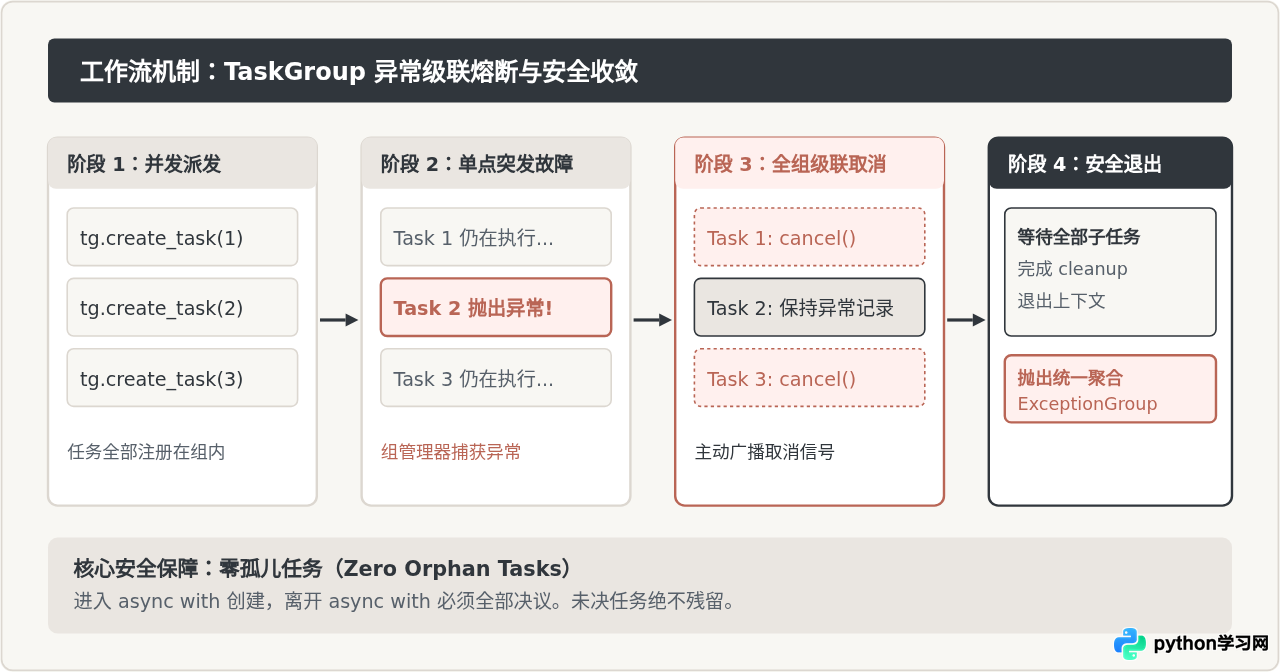
结构化并发的真正威力在发生故障时显现。如果某个任务崩溃,TaskGroup 会自动对该组内还在运行的其他任务调用 cancel(),并等待所有被取消的任务妥善结束,最后将所有异常归总为一个 ExceptionGroup 向上抛出。调用方可以使用 Python 3.11 引入的 except* 语法针对特定异常类型进行拆解捕获:
async def flawed_worker(task_id: int):
    if task_id == 1:
        await asyncio.sleep(0.1)
        raise ConnectionResetError("连接重置")
    elif task_id == 2:
        await asyncio.sleep(0.1)
        raise TimeoutError("请求超时")
    else:
        # 该任务将被 TaskGroup 自动取消,不会变成孤儿
        await asyncio.sleep(5.0)
        return "正常完成"

async def test_error_handling():
    try:
        async with asyncio.TaskGroup() as tg:
            tg.create_task(flawed_worker(1))
            tg.create_task(flawed_worker(2))
            tg.create_task(flawed_worker(3))
    except* ConnectionResetError as eg:
        print(f"捕获到网络重置异常群: {eg.exceptions}")
    except* TimeoutError as eg:
        print(f"捕获到超时异常群: {eg.exceptions}")
四、并发控制:使用 Semaphore 限制最大并发数
无论是使用 gather 还是 TaskGroup,一次性创建数万个任务都会消耗大量内存,并可能导致连接池耗尽或对端服务限流。在工程落地中,通常需要配合 asyncio.Semaphore(信号量)将瞬时并发度限制在一个安全阈值内。
下面展示在 TaskGroup 体系下优雅集成信号量的标准范式:
import asyncio

async def bounded_request(sem: asyncio.Semaphore, item_id: int):
    # 使用信号量控制同时进入临界区的并发数量
    async with sem:
        print(f"正在处理项目 {item_id}...")
        await asyncio.sleep(0.5)
        return f"结果_{item_id}"

async def main():
    concurrency_limit = 5
    sem = asyncio.Semaphore(concurrency_limit)
    total_items = 20

    results = []
    async with asyncio.TaskGroup() as tg:
        tasks = [tg.create_task(bounded_request(sem, i)) for i in range(total_items)]

    for t in tasks:
        results.append(t.result())

    print(f"全部 {len(results)} 个任务处理完毕。")

if __name__ == "__main__":
    asyncio.run(main())
五、选型指南与工程对比
在实际项目重构或新项目架构设计中,面对 asyncio.gather 和 asyncio.TaskGroup,开发者应当如何决策?下表总结了它们的核心特性与差异:
| 对比维度 | asyncio.gather | asyncio.TaskGroup |
|---|---|---|
| 支持版本 | Python 3.4+(成熟稳定) | Python 3.11+(现代标准) |
| 设计范式 | 非结构化任务收集 | 结构化并发(Structured Concurrency) |
| 异常行为 | 首个报错立即抛出,其余任务继续后台漂移 | 自动取消组内全部剩余任务,防止孤儿悬挂 |
| 异常捕获方式 | 标准 try...except 或 return_exceptions=True |
统一聚合为 ExceptionGroup,使用 except* 细粒度过滤 |
| 结果获取形式 | 直接返回对应顺序的值列表 | 需保留 Task 句柄,退出作用域后调用 t.result() |
| 尽力而为(Best-effort) | 原生支持(return_exceptions=True) |
需在各子协程内部自行 try...except 吸收异常 |
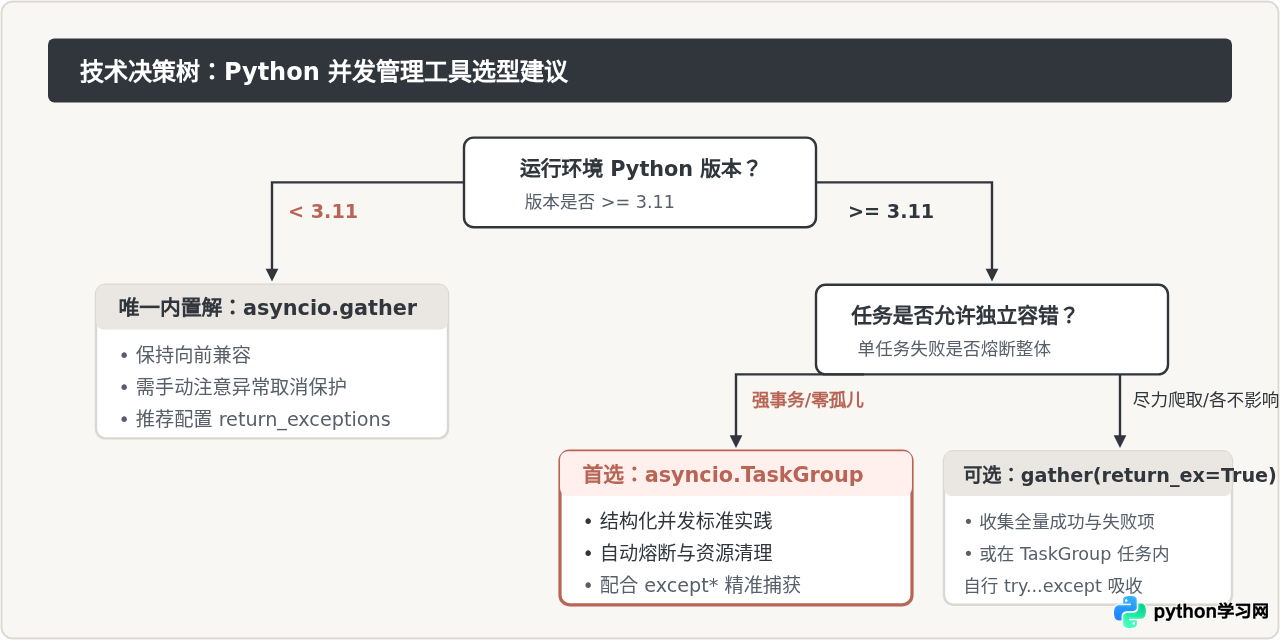
总结
高效管理 Python 异步并发任务不仅关乎执行速度,更关乎异常边界与系统稳定性:
- 对于 Python 3.11+ 的现代业务系统,应默认优先采用
asyncio.TaskGroup。它通过结构化并发范式,确保任务生命周期被严格封限在作用域内,彻底消除未取消的孤儿协程。 - 当需要维护旧版本代码(Python 3.10 及以下),或面对“容忍个别单点失败、收集全部可用数据”的特定批处理场景时,
asyncio.gather(..., return_exceptions=True)仍是轻量便捷的实用方案。 - 在高并发生产环境中,无论采用哪种工具,都必须搭配
asyncio.Semaphore显式约束并发上限,保障底层网络连接与系统资源的健康稳定。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









