

Python标准库包含哪些常用模块

假设你刚刚在服务器或本地电脑上安装了纯净的 Python 环境,准备编写一个数据批处理脚本:你需要扫描多层嵌套目录、解析格式各异的 JSON 配置文件、对海量数据进行分类统计,并在出错时将日志准确记录到独立文件中。面对这些需求,很多初学者会不假思索地打开终端运行 pip install 安装第三方包。然而,Python 自诞生起就秉承着“开箱即用(Batteries Included)”的设计哲学,其内置的标准库早已涵盖了从底层操作系统交互到高级数据结构处理的几乎所有基础能力。掌握这些自带模块,不仅能消除冗余的外部依赖、提升脚本的跨平台可移植性,更能避免因第三方库版本迭代带来的破坏性更新。
本文将围绕“Python标准库包含哪些常用模块”这一核心问题,分类梳理日常开发中最高频、最实用的模块集合,深入讲解它们的核心职责、典型代码模式与实践注意事项,帮助读者建立起清晰的标准库选型图景。
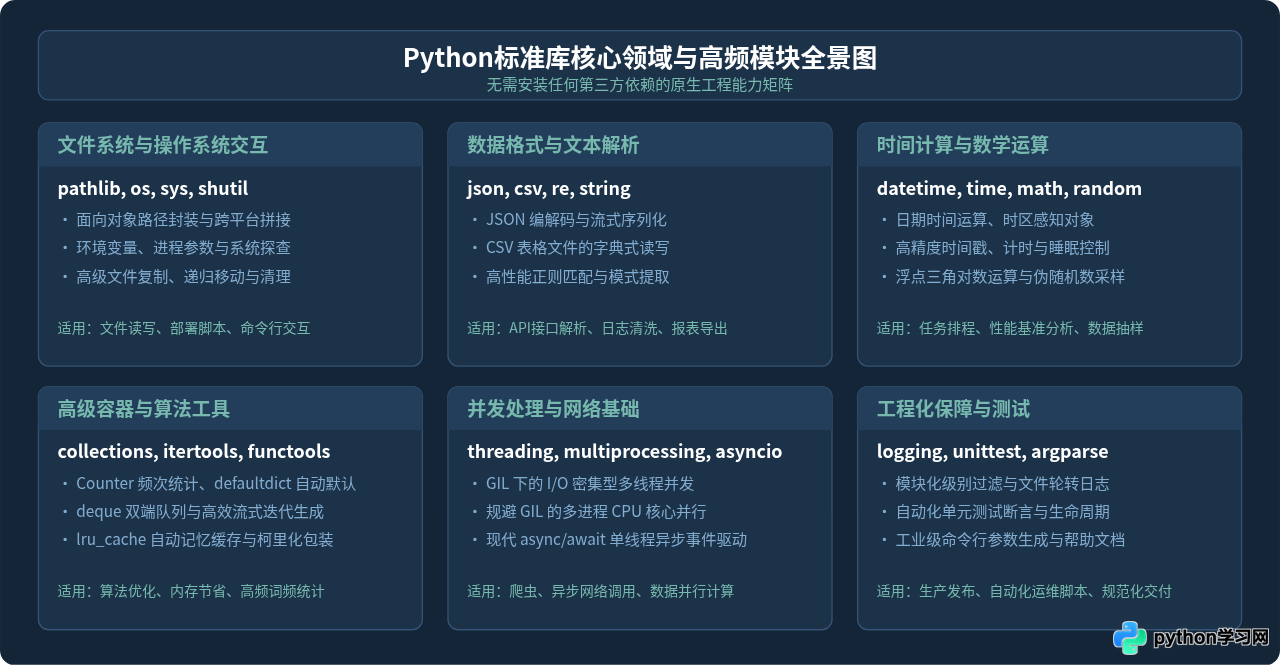
一、系统探查与文件操作模块
在所有自动化脚本与工程项目中,与底层文件系统打交道是发生频率最高的操作。Python 提供了多层次的模块来处理路径与进程控制。
1. pathlib:现代面向对象的文件路径操作
在早期 Python 代码中,开发者普遍使用 os.path 处理路径,经常写出难以维护的字符串嵌套调用(例如 os.path.join(os.path.dirname(os.path.abspath(__file__)), 'data'))。从 Python 3.4 开始引入的 pathlib 模块已成为路径处理的首选标准。它将路径抽象为对象,重载了斜杠运算符 /,使路径拼接和元数据读取直观优雅。
from pathlib import Path

# 获取当前工作目录,并构建子目录路径
base_dir = Path.cwd()
data_file = base_dir / "storage" / "app_config.json"

# 检查父目录是否存在,若不存在则递归创建
data_file.parent.mkdir(parents=True, exist_ok=True)

# 安全写入与读取文本内容
data_file.write_text('{"status": "ok"}', encoding="utf-8")
print("文件内容:", data_file.read_text(encoding="utf-8"))

# 遍历目录下的所有 .py 文件
for py_file in base_dir.glob("*.py"):
    print("发现脚本:", py_file.name, "大小(字节):", py_file.stat().st_size)
2. os 与 sys:操作系统接口与运行时环境
sys 模块主要负责与 Python 解释器本身的交互,例如获取命令行参数 sys.argv、当前模块搜索路径 sys.path 以及主动终止运行 sys.exit()。而 os 模块则负责与宿主操作系统交互,最典型的用途是读取环境变量 os.environ 与执行进程级操作。
import os
import sys

# 1. 获取传入的命令行参数
print("执行脚本名称:", sys.argv[0])
if len(sys.argv) > 1:
    print("附加参数:", sys.argv[1:])

# 2. 读取系统环境变量(附带默认回退值)
database_url = os.environ.get("DATABASE_URL", "sqlite:///default.db")
print("数据库连接目标:", database_url)

# 3. 获取当前运行平台的标识(如 'linux', 'darwin', 'win32')
print("当前运行平台:", sys.platform)
3. shutil:高级文件集合与归档操作
当需要复制整个文件夹树、移动非空目录或解压缩文件包时,os 模块的功能显得十分底层,此时 shutil 便派上用场。例如,shutil.copytree() 可以完整递归复制目录结构,shutil.rmtree() 可以安全删除整棵目录树,而 shutil.make_archive() 则支持一键打包生成 zip 或 tar 压缩归档。
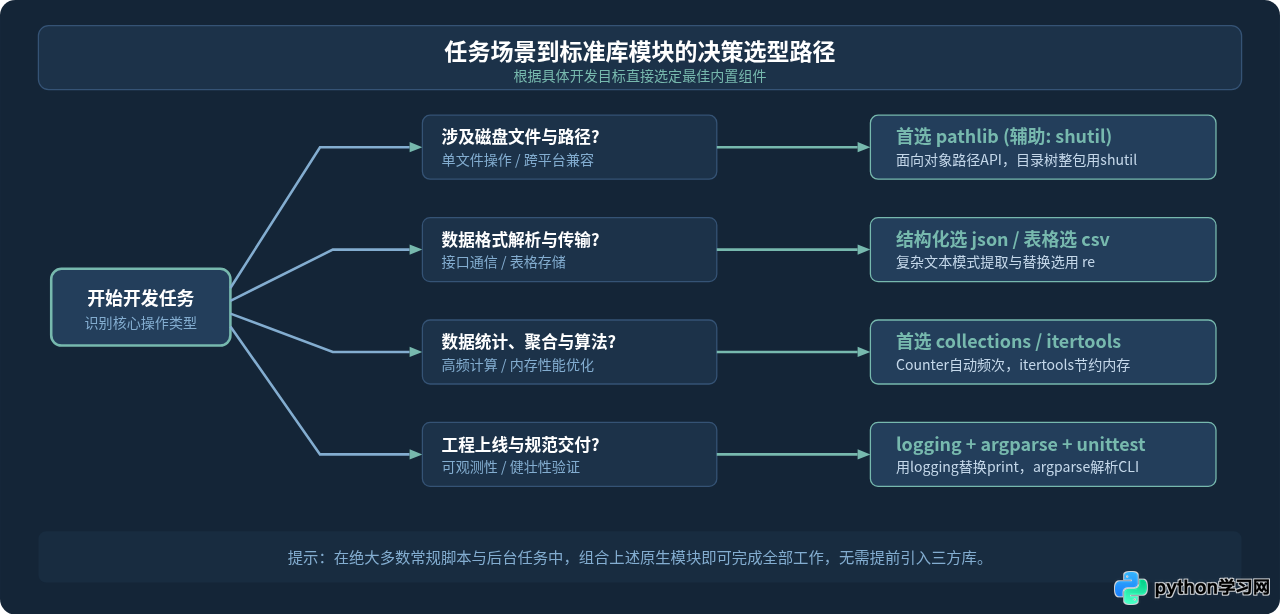
二、数据解析与序列化模块
现代应用绝大多数时间都在进行数据的接收、清洗、转换与落地。标准库为常见的数据载体提供了完备的编解码支持。
1. json:JSON 数据的高效互转
json 模块是前后端交互、配置文件管理的核心。需要牢记的是两对函数的使用区别:
json.loads()与json.dumps():作用于内存中的 Python 字符串(以 s 结尾代表 String)。json.load()与json.dump():直接作用于实现了.read()或.write()的文件句柄。
import json

user_payload = {
    "user_id": 1024,
    "username": "developer_ku",
    "permissions": ["read", "write"],
    "is_active": True
}

# 序列化为格式化字符串(ensure_ascii=False 确保中文正常输出而非 \u 编码)
json_text = json.dumps(user_payload, indent=2, ensure_ascii=False)
print("JSON 字符串输出:\n", json_text)

# 反序列化还原为 Python 原生字典
recovered_data = json.loads(json_text)
assert recovered_data["permissions"][0] == "read"避坑提示:原生 json 模块默认不支持 datetime、UUID 或自定义类的直接序列化。若直接传入会抛出 TypeError: Object of type datetime is not JSON serializable。解决方案是指定 default 参数提供转换函数,或在输出前显式转为 ISO 格式字符串。
2. re:强大的正则表达式引擎
对于日志清洗、邮箱手机号校验或非结构化文本抽取,re 模块提供了快速的模式匹配。在性能敏感场景中,推荐使用 re.compile() 先行编译正则表达式对象,避免在循环体内重复解析正则规则。
import re

log_line = "2026-10-23 13:45:00 [ERROR] Connection timeout to 192.168.1.108:8080"

# 预编译正则,使用命名分组 (?P<name>...) 提取结构化数据
pattern = re.compile(r"\[(?P<level>\w+)\]\s+(?P<message>.*)\s+to\s+(?P<ip>\d+\.\d+\.\d+\.\d+):(?P<port>\d+)")
match = pattern.search(log_line)

if match:
    parsed = match.groupdict()
    print("解析出的日志级别:", parsed["level"])
    print("目标服务器IP:", parsed["ip"], "端口:", parsed["port"])
三、高级数据结构与函数工具模块
虽然 Python 已经内置了 list、dict、set 与 tuple,但在复杂业务场景下,如果仅仅依赖这些基础容器,往往需要手写冗长的条件判断或双重循环。collections、itertools 与 functools 被誉为 Python 编写高效优雅代码的“三大神器”。
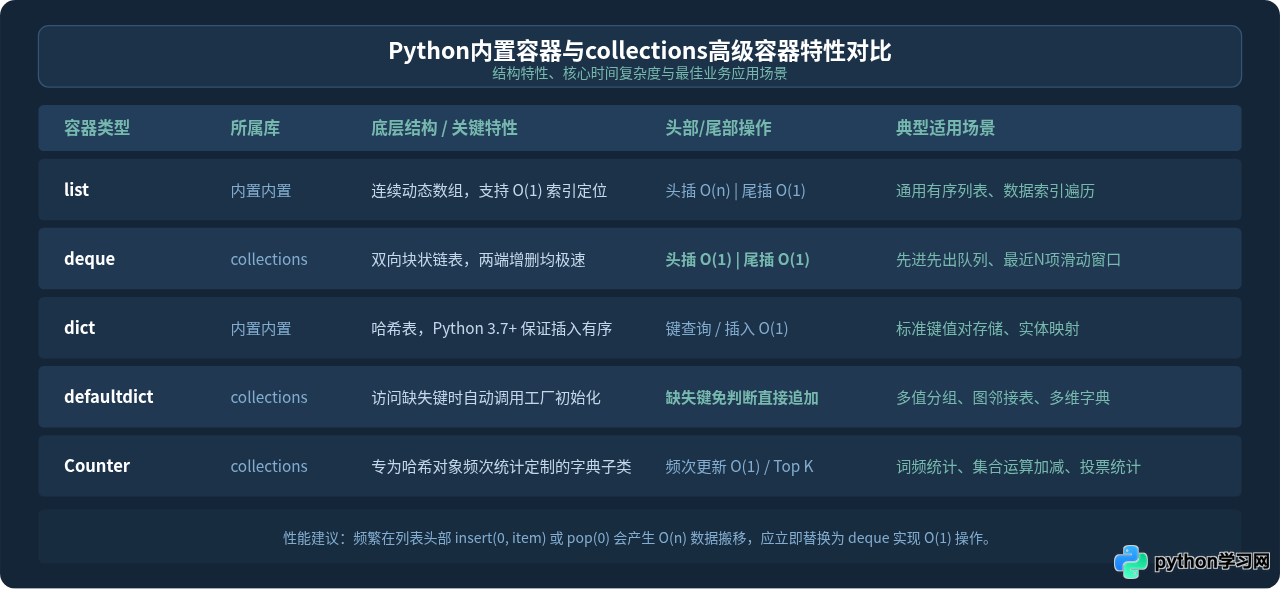
1. collections:解决现实痛点的专用容器
Counter:一行代码统计列表、字符串中各元素的出现频次,并提供most_common(k)直接输出 Top K 元素。defaultdict:免去反复判断if key not in dict: dict[key] = []的繁杂写法。deque:双端队列,两端入队出队均为严格常数级时间复杂度 $O(1)$,并支持maxlen属性自动维持固定长度滑动窗口。
from collections import Counter, defaultdict, deque

# 1. 词频统计
words = ["python", "java", "python", "rust", "go", "python", "rust"]
counter = Counter(words)
print("出现最多的语言:", counter.most_common(1))  # [('python', 3)]

# 2. 自动分组
records = [("tech", "python"), ("tech", "linux"), ("sales", "contract")]
grouped = defaultdict(list)
for dept, item in records:
    grouped[dept].append(item)
print("分组结果:", dict(grouped))

# 3. 滑动窗口
recent_events = deque(maxlen=3)
for i in range(5):
    recent_events.append(f"event_{i}")
print("最近3个事件:", list(recent_events))  # ['event_2', 'event_3', 'event_4']
2. itertools:高效的内存友好型迭代器
处理大型数据集或无限序列时,一次性把全部内容加载成 list 很容易导致内存崩溃。itertools 产出的是惰性计算的迭代器,随用随算:
itertools.chain(*iterables):零内存拷贝地把多个可迭代对象串联成一个连续的数据流。itertools.islice(iterable, stop):对迭代器执行切片,避免提前实例化全部数据。itertools.product()与permutations():生成笛卡尔积或排列组合,避免嵌套多重for循环。
3. functools:高阶函数与性能加速
functools 最知名的功能是 @lru_cache 装饰器。只要被装饰的函数参数可哈希,它就能自动将执行结果缓存至内存中,避免重复的递归或耗时计算:
from functools import lru_cache

@lru_cache(maxsize=128)
def fibonacci(n: int) -> int:
    if n < 2:
        return n
    return fibonacci(n - 1) + fibonacci(n - 2)

print("斐波那契第50项:", fibonacci(50))
print("缓存命中情况:", fibonacci.cache_info())
四、工程化保障与网络并发模块
当项目从简单的练习脚本走向正式交付或生产部署时,代码的可观测性、健壮性与运行效率成为衡量工程水平的关键标准。
1. logging:取代 print 的生产级日志记录
严禁在正式工程中使用 print() 打印关键运行状态,因为 print 无法动态调整级别、缺乏时间戳与上下文线程信息,且无法直接输出到轮转日志文件。logging 模块提供了从 DEBUG、INFO、WARNING、ERROR 到 CRITICAL 的完整分级支持。
import logging

# 配置日志基础格式与输出级别
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] (%(name)s) %(message)s",
    datefmt="%Y-%m-%d %H:%M:%S"
)

logger = logging.getLogger("DataProcessor")

def process_batch(items):
    logger.info("开始处理批次数据,共 %d 条", len(items))
    try:
        # 模拟业务逻辑
        result = 100 / len(items)
        logger.debug("运算平均耗时: %.2f", result)
    except ZeroDivisionError:
        logger.error("数据批次为空,无法执行均分逻辑", exc_info=True)

process_batch([])
2. datetime 与 time:时间与时区精准计算
在处理日志打标、任务调度和跨国时间时,datetime 是绝对的核心。务必注意“原生朴素时间(Naive Datetime)”与“时区感知时间(Aware Datetime)”的区别:
from datetime import datetime, timezone, timedelta

# 获取当前的 UTC 时间(带有时区信息)
utc_now = datetime.now(timezone.utc)
print("当前 UTC 时间:", utc_now.isoformat())

# 时间偏移加减(如计算3天后的过期时间)
expire_at = utc_now + timedelta(days=3, hours=4)
print("过期时间:", expire_at.strftime("%Y/%m/%d %H:%M:%S"))
3. argparse 与 unittest:交付与测试保障
argparse:只需定义预期的参数类型和帮助文字,该模块即可自动生成符合 GNU/POSIX 规范的命令行帮助界面(--help),并严密校验输入类型。unittest:标准测试框架,通过继承unittest.TestCase并配合assertEqual等断言方法,确保每一次代码改动都能通过自动化验证。
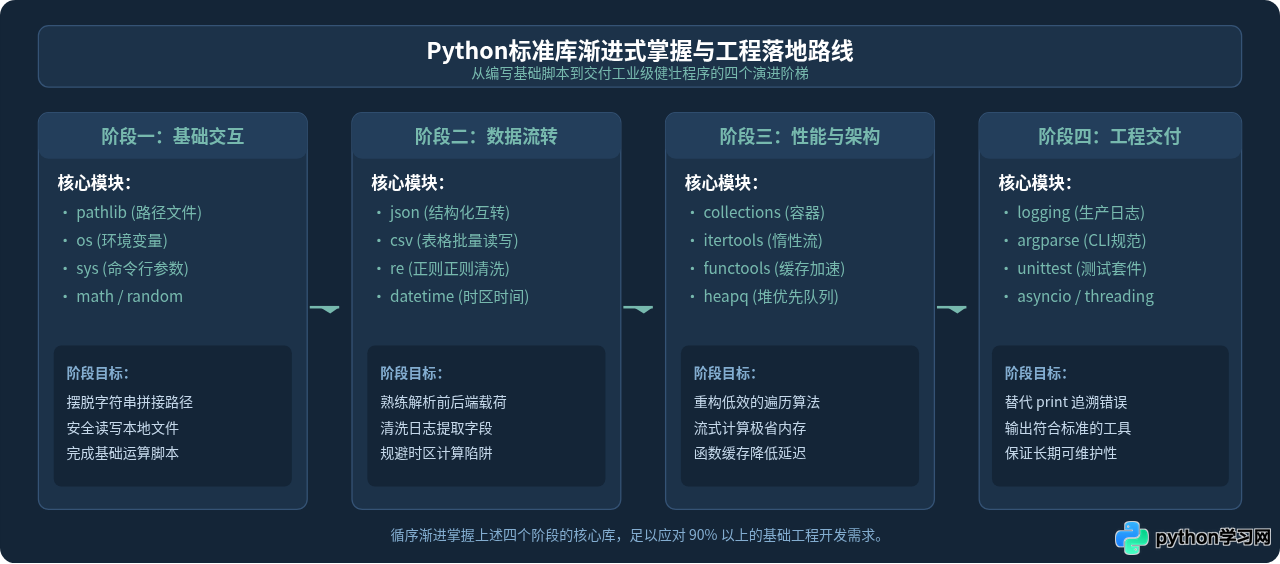
五、标准库的选型边界:何时应该引入第三方库?
了解标准库包含哪些模块不仅意味着知道用它们能做什么,更意味着知道它们的局限与适用边界。标准库追求的是极致的稳定性与向后兼容,这往往意味着它的 API 演进速度慢于社区生态:
| 功能场景 | 内置标准库 | 标准库优势与局限 | 何时选用成熟第三方库 |
|---|---|---|---|
| HTTP 网络请求 | urllib.request |
无需安装;但 API 繁琐,处理 Cookie/Session 与连接池较为复杂。 | 高频 REST API 交互或需要连接池复用时,推荐 requests 或异步 httpx。 |
| 数据分析与矩阵运算 | math, csv |
单条数据处理轻量直观;不支持 SIMD 向量化加速。 | 涉及百万行以上报表或科学计算时,必须选用 numpy 与 pandas。 |
| 对象模型与模式校验 | dataclasses |
原生强类型声明与默认方法生成;但运行时类型校验较弱。 | 需要严密运行时类型转换与 API 载荷校验时,推荐 pydantic。 |
| 测试用例与夹具 | unittest |
开箱即用,类继承规范明确;但断言方法较繁琐。 | 中大型工程推荐 pytest,其强大的参数化与 fixture 机制能大幅提升编写体验。 |
总结:Python 标准库是每一位开发者最稳固的基石。在着手安装庞大的外部依赖之前,花几分钟核对当前任务是否属于 pathlib、json、collections、itertools 或 logging 的能力范围,往往能用极其轻巧、原生且易于维护的方式解决问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









