

怎么用Python标准库替代requests和pandas?轻量级开发技巧
深入讲解如何使用Python内置标准库(urllib、json、csv、collections、itertools)完全替代外部重型库requests与pandas。涵盖核心网络请求封装、流式数据清洗聚合、内存控制与适用边界对比。
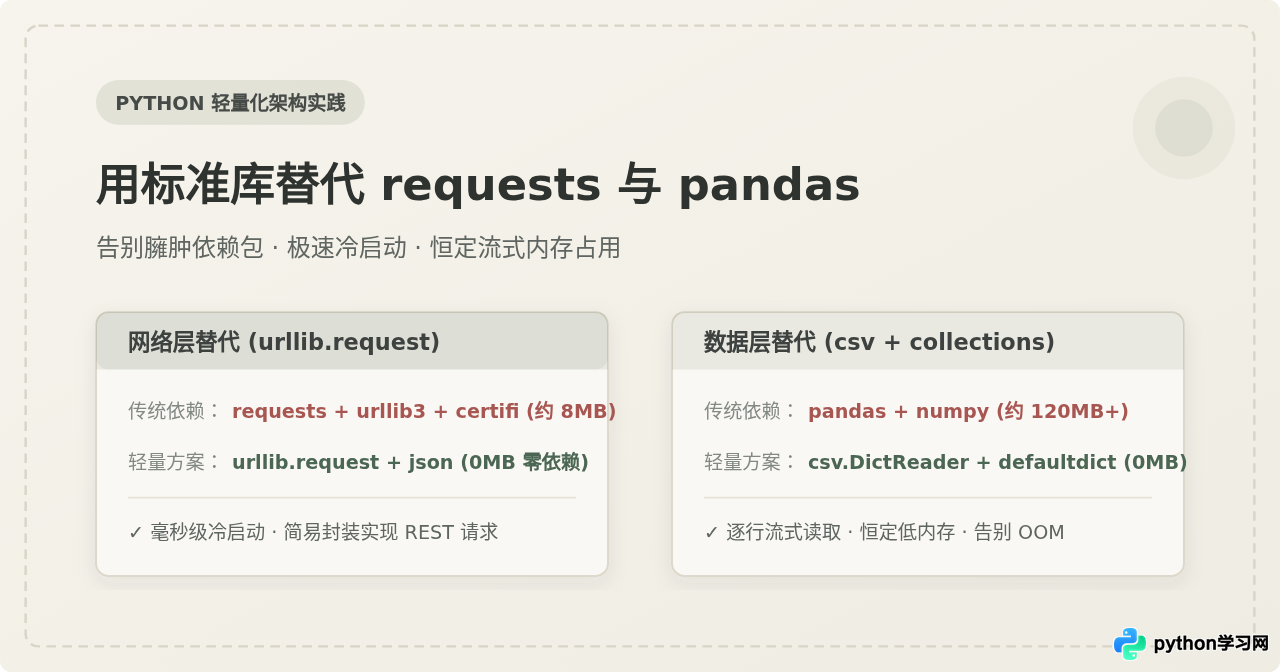
requests 和 pandas 往往会带来数十至上百兆的体积开销与冷启动延迟。掌握 Python 标准库中的 urllib、csv、collections 与 itertools,就能用极其简练的代码实现完整的网络请求与流式数据聚合,在零外部依赖的前提下获得毫秒级启动与恒定低内存的运行表现。
一、为什么以及何时替换?权衡思维与常见误区辨析
在很多 Python 教程中,发送网络请求默认推荐 requests,处理表格数据默认绑定 pandas。这种思维惯性让许多初学者产生了一种错觉:“Python 的内置库太弱,不装第三方库什么也干不了”。这种说法在复杂场景下看似合理,但在大量日常任务中并不成立。
我们首先需要分清“轻量级需求”与“重型数据科学需求”的界限:
- 依赖包膨胀:安装
pandas会连带引入numpy、pytz、python-dateutil等包,解压后体积往往超过 120MB。而在 AWS Lambda、阿里云 FC 或 Docker 极小基础镜像(如 Alpine/Distroless)中,体积每增加一分,镜像构建、分发和冷启动时间就成倍放大。 - 环境冲突与隔离成本:在公司的隔离内网或生产跳板机上,外网 PyPI 无法访问,也没有预先配置私有镜像源。纯靠标准库运行的单个
.py脚本可以随贴随用,彻底免除安装 wheel 包或编译 C 扩展的困扰。 - 内存机制差异:
pandas默认将整张表格载入内存,构建高开销的 DataFrame 对象。对于一个 500MB 的 CSV 文件,其 DataFrame 常会吃掉 1.5GB 至 2.5GB 内存。而标准库的csv模块天生支持基于迭代器的流式逐行读取,哪怕处理 10GB 数据,内存占用也能稳定在几十兆。
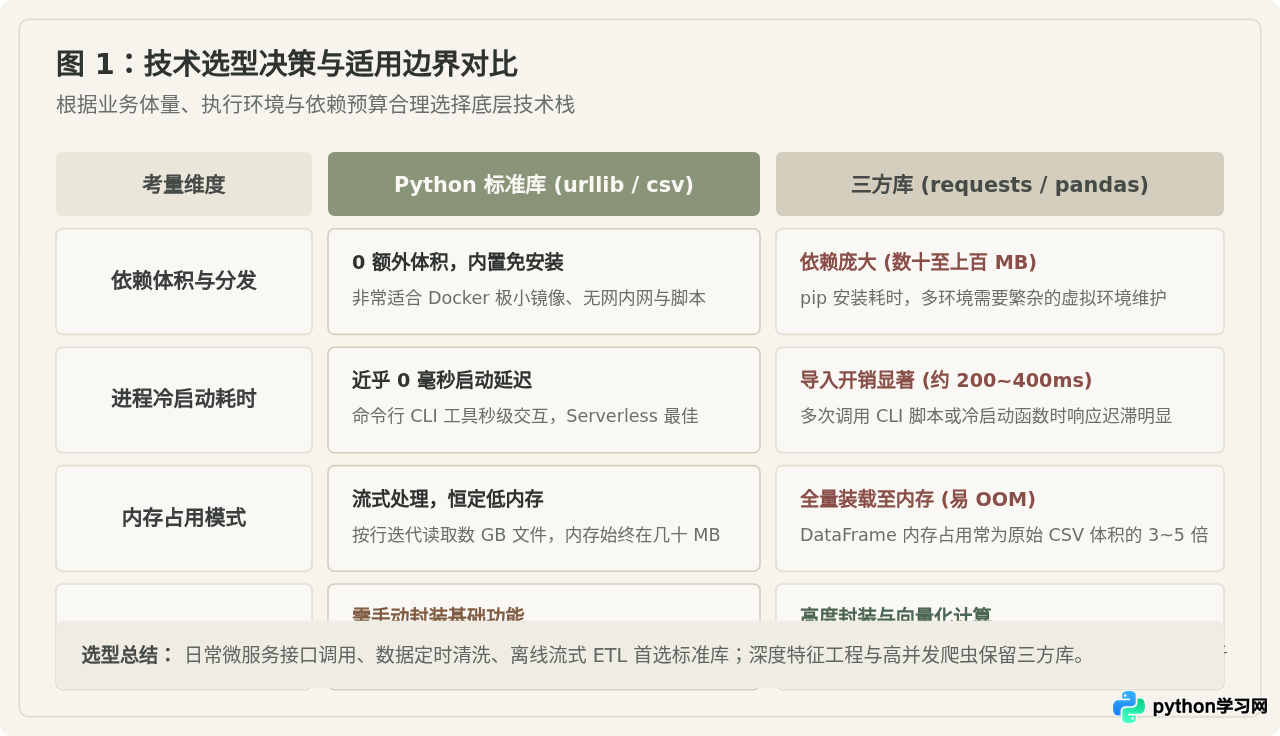
轻量级开发讲求物尽其用,而非教条主义。如果项目核心是高并发下的 HTTP/2 长连接保活与复杂 OAuth 流程,或者需要进行千万级多表关联、时间序列滑动窗口运算与线性代数矩阵运算,requests/httpx 与 pandas/polars 依然是工业界最成熟的选择。标准库替代方案的真正舞台是:运维 CLI 工具、定时监控脚本、微服务数据同步、单表 ETL 与中小规模离线报表生成。
二、替代 requests:用 urllib 与 json 打造 30 行网络请求客户端
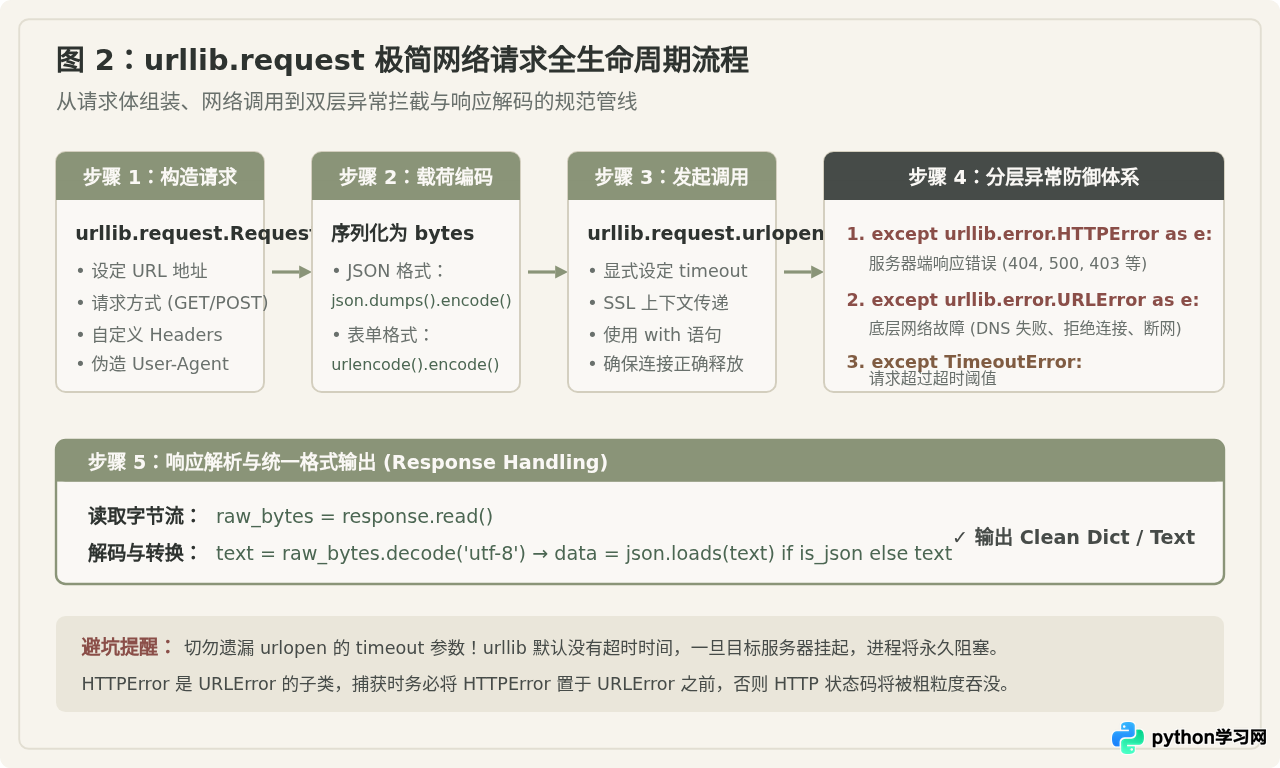
开发者之所以抗拒 Python 原生的 urllib.request,主要是因为它的默认 API 过于底层:没有默认超时时间、不会自动做 JSON 编解码、POST 请求必须手动转为 bytes,而且抛出的 HTTP 错误属于异常而不是挂在响应对象上的状态码。
但只要理解其核心生命周期,用 30 行代码对其进行一层极薄的封装,就能完全复刻 requests 最常用的请求体验。
1. 核心封装实现:http_request()
以下是一个即拷即用的轻量网络请求函数,原生支持 GET/POST、Query 参数追加、JSON 载荷自动序列化、自定义 Headers、超时控制以及分层错误捕获:
import json
from urllib.request import Request, urlopen
from urllib.parse import urlencode
from urllib.error import HTTPError, URLError

def http_request(
    url,
    method="GET",
    params=None,
    data=None,
    headers=None,
    timeout=10
):
    """
    轻量级网络请求封装函数(完全依赖标准库)

    :param url: 请求目标 URL
    :param method: GET、POST、PUT、DELETE 等
    :param params: URL 查询参数字典
    :param data: 发送的数据(dict 将自动识别为 JSON)
    :param headers: 自定义 HTTP 请求头
    :param timeout: 超时时间(秒)
    :return: (status_code, response_data, headers_dict)
    """
    req_headers = {"User-Agent": "LightweightPythonClient/1.0"}
    if headers:
        req_headers.update(headers)

    # 1. 拼接 URL 查询参数
    if params:
        query_string = urlencode(params)
        delimiter = "&" if "?" in url else "?"
        url = f"{url}{delimiter}{query_string}"

    # 2. 编码请求载荷 (payload)
    encoded_data = None
    if data is not None:
        if isinstance(data, dict):
            req_headers.setdefault("Content-Type", "application/json; charset=utf-8")
            encoded_data = json.dumps(data).encode("utf-8")
        elif isinstance(data, str):
            encoded_data = data.encode("utf-8")
        elif isinstance(data, bytes):
            encoded_data = data

    # 3. 构造 Request 对象
    req = Request(url=url, data=encoded_data, headers=req_headers, method=method.upper())

    # 4. 执行请求与错误拦截
    try:
        with urlopen(req, timeout=timeout) as resp:
            status = resp.status
            raw_body = resp.read()
            resp_headers = dict(resp.headers)

            # 自动解码并按 Content-Type 解析 JSON
            text = raw_body.decode("utf-8", errors="replace")
            content_type = resp_headers.get("Content-Type", "")
            if "application/json" in content_type:
                try:
                    return status, json.loads(text), resp_headers
                except json.JSONDecodeError:
                    return status, text, resp_headers
            return status, text, resp_headers

    except HTTPError as e:
        # HTTP 错误(如 400, 404, 500)由 HTTPError 捕获
        err_body = e.read().decode("utf-8", errors="replace")
        return e.code, {"error": "HTTPError", "detail": err_body}, dict(e.headers)

    except URLError as e:
        # 底层网络错误(如 DNS 解析失败、目标主机拒绝连接)
        return 0, {"error": "URLError", "detail": str(e.reason)}, {}

    except TimeoutError:
        return 0, {"error": "TimeoutError", "detail": f"Request exceeded {timeout}s"}, {}
2. 实战对比:调用 REST API
有了这个封装,日常调用 API 的代码与 requests 几乎没有认知门槛差异。我们分别来看 GET 查询与 POST 提交:
# 示例 1:发送带参数的 GET 请求
status, result, _ = http_request(
    url="https://api.example.com/v1/metrics",
    method="GET",
    params={"region": "cn-north", "limit": 20},
    timeout=5
)
if status == 200:
    print("获取成功:", result)
else:
    print(f"请求失败 [{status}]:", result.get("error"))

# 示例 2:提交 JSON 数据(自动配置 Content-Type 并编码 bytes)
payload = {"task_id": 1024, "status": "completed"}
status, result, _ = http_request(
    url="https://api.example.com/v1/tasks",
    method="POST",
    data=payload
)
print("响应结果:", status, result)
1. 异常捕获顺序:在标准库中,HTTPError 是 URLError 的子类。因此在代码中必须先捕获 HTTPError,后捕获 URLError,否则所有带 HTTP 状态码的错误都会被宽泛的 URLError 截胡。
2. 超时参数不可省略:urllib.request.urlopen 若不传入 timeout,其默认值是全局系统套接字超时(经常表现为无限挂起)。轻量脚本必须强制显式指定超时阈值。
三、替代 pandas:csv 与 collections 驱动的流式数据处理
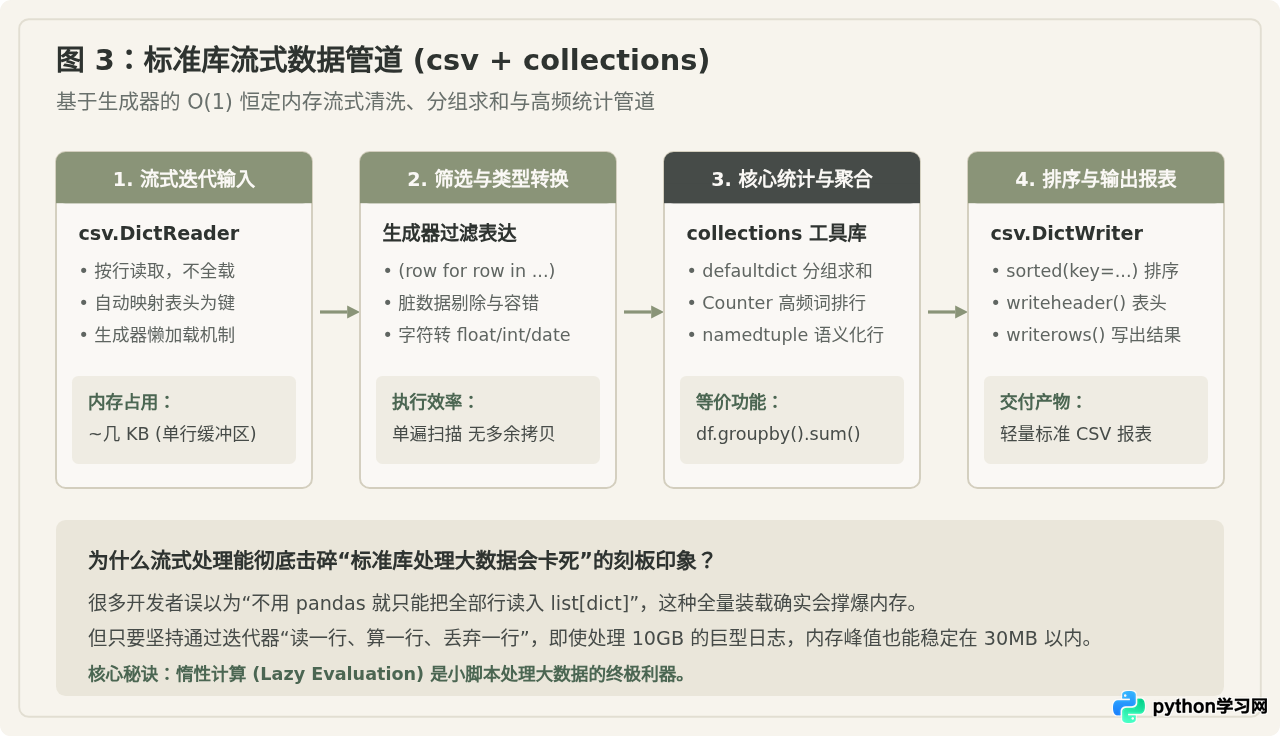
在绝大多数日常脚本中,我们对 pandas 的使用其实局限在三个动作:读取 CSV 文件、按某个字段过滤并做 GroupBy 分组求和、最后写出新表格。
为了这三个基础操作而引入庞大的 pandas,就如同“为了搬两块砖而开来一辆重型起重机”。Python 标准库中的 csv 模块、collections 模块(特别是 defaultdict 和 Counter)配合 itertools,不仅代码行数适中,执行效率极高,而且由于采用迭代器模式,其内存开销是恒定的。
1. 常用高频操作对标与代码模式
我们通过一组对照表直观对比 pandas 操作与对应的标准库最佳实践:
| 业务操作 | pandas 写法 | 标准库对应最佳方案 |
|---|---|---|
| 读取 CSV 表格 | df = pd.read_csv("file.csv") |
csv.DictReader(open_file)(按行迭代,不占内存) |
| 字段条件过滤 | df[df["status"] == "SUCCESS"] |
生成器推导:(r for r in reader if r["status"] == "SUCCESS") |
| 单列频次统计 (Top N) | df["city"].value_counts().head(5) |
collections.Counter(r["city"] for r in reader).most_common(5) |
| 分组汇总求和 (GroupBy) | df.groupby("dept")["salary"].sum() |
collections.defaultdict(float) 遍历累加 |
| 写出处理结果 | df.to_csv("out.csv", index=False) |
csv.DictWriter(open_file, fieldnames=...).writerows(...) |
2. 完整实战示例:流式计算销售总额与区域排行
假设我们有一个名为 sales_data.csv 的文件,记录了订单数据(包含 order_id、region、category、amount、status)。我们需要过滤出 COMPLETED 的订单,按区域汇总总销售额,并找出购买频次最高的前 3 种商品类别。
以下是纯标准库实现:
import csv
from collections import defaultdict, Counter

def analyze_sales_stream(input_csv_path, output_report_path):
    region_sales = defaultdict(float)
    category_counter = Counter()
    total_valid_orders = 0

    # 1. 以流式方式逐行读取,逐行处理
    with open(input_csv_path, mode="r", encoding="utf-8") as f:
        reader = csv.DictReader(f)

        for row in reader:
            # 过滤未完成订单
            if row.get("status") != "COMPLETED":
                continue

            try:
                amount = float(row["amount"])
            except (ValueError, KeyError):
                continue  # 跳过金额异常的坏数据

            region = row.get("region", "未知区域")
            category = row.get("category", "未分类")

            # 聚合运算:累加区域金额,统计类别频次
            region_sales[region] += amount
            category_counter[category] += 1
            total_valid_orders += 1

    # 2. 排序结果:按销售额降序排列
    sorted_regions = sorted(
        region_sales.items(),
        key=lambda item: item[1],
        reverse=True
    )

    # 3. 将汇总报表写出到新的 CSV
    with open(output_report_path, mode="w", encoding="utf-8", newline="") as f:
        fieldnames = ["region", "total_sales", "average_per_order"]
        writer = csv.DictWriter(f, fieldnames=fieldnames)

        writer.writeheader()
        for region, total in sorted_regions:
            writer.writerow({
                "region": region,
                "total_sales": f"{total:.2f}",
                "average_per_order": f"{(total / total_valid_orders):.2f}" if total_valid_orders else "0.00"
            })

    # 4. 终端摘要输出
    top_categories = category_counter.most_common(3)
    return total_valid_orders, top_categories
在这段代码中:
defaultdict(float)免去了繁琐的if key not in dict: dict[key] = 0判定,语义直接明确。Counter.most_common(3)在内部基于堆排序(heapq)实现,耗时与内存远胜于全量排序。- 整个过程没有把所有行存进任何列表。即使
sales_data.csv包含 5000 万行记录,Python 占用的内存峰值也不会超过 30MB。
四、标准库轻量组合实战:零依赖数据同步与报表自动化
将上述两部分技巧串联起来,就是现代后端开发中最常见的任务:通过 REST API 获取增量数据,并在本地清洗后输出统计报表。
下面是一个完整的自动化脚本实例,模拟从远程用户服务接口拉取活跃用户日志,并用纯标准库生成活跃度分析报告:
import csv
import json
from collections import defaultdict
from urllib.request import Request, urlopen
from urllib.error import URLError

def sync_and_generate_report(api_url, output_csv):
    # 步骤一:拉取远程数据
    req = Request(
        url=api_url,
        headers={"User-Agent": "SyncWorker/1.0", "Accept": "application/json"}
    )

    try:
        with urlopen(req, timeout=8) as resp:
            if resp.status != 200:
                print(f"远程接口返回非 200 状态: {resp.status}")
                return False
            payload = json.loads(resp.read().decode("utf-8"))
    except URLError as err:
        print(f"数据同步网络中断: {err}")
        return False

    records = payload.get("data", [])
    if not records:
        print("未获取到有效数据记录")
        return False

    # 步骤二:内存统计(按用户分组统计操作次数与最近活跃时间)
    user_stats = defaultdict(lambda: {"action_count": 0, "last_active": ""})

    for item in records:
        uid = item.get("user_id")
        timestamp = item.get("timestamp", "")
        if not uid:
            continue

        stat = user_stats[uid]
        stat["action_count"] += 1
        if timestamp > stat["last_active"]:
            stat["last_active"] = timestamp

    # 步骤三:写出本地报表
    with open(output_csv, mode="w", encoding="utf-8", newline="") as csvfile:
        writer = csv.DictWriter(
            csvfile,
            fieldnames=["user_id", "action_count", "last_active"]
        )
        writer.writeheader()
        for uid, info in sorted(user_stats.items(), key=lambda x: x[1]["action_count"], reverse=True):
            writer.writerow({
                "user_id": uid,
                "action_count": info["action_count"],
                "last_active": info["last_active"]
            })

    print(f"报表已生成: {output_csv},累计统计用户数: {len(user_stats)}")
    return True
整个脚本仅包含单个文件,可以在任何预装了 Python 3.6+ 的纯净操作系统上直接运行,完全无需 pip install -r requirements.txt。
五、轻量级开发总结与最佳实践指南
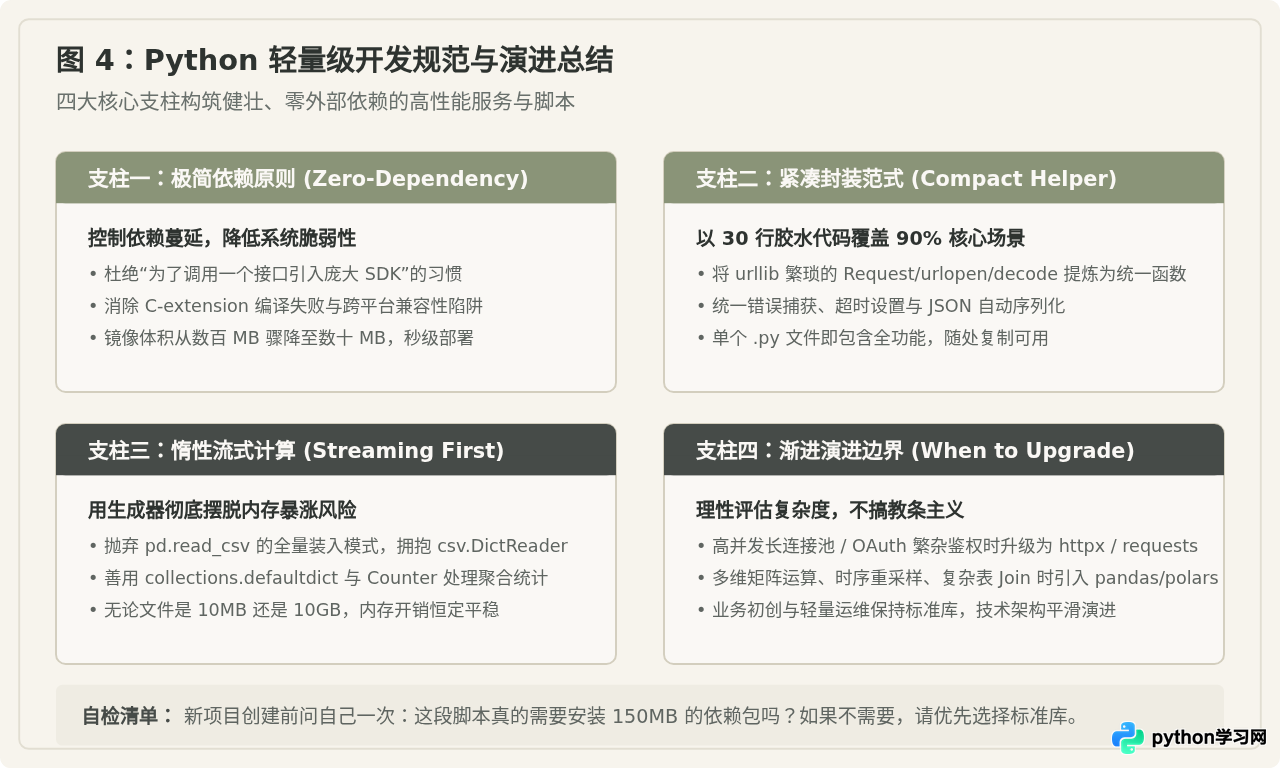
摒弃对外部库的盲目依赖,是衡量一名 Python 工程师工程素养的重要标志。通过标准库实现业务,不仅带来了极致的打包分发优势,更迫使我们深入理解流式处理与数据结构底层。
核心实践准则梳理:
- 防御性编码优先:使用
urllib时务必显式传入timeout,并在捕获中明确分清HTTPError与URLError。 - 善用标准库高阶数据结构:
collections.defaultdict代替字典多层嵌套判定,collections.Counter代替手工循环累加计次,itertools.chain与islice用于高效切片。 - 牢记流式原则:读取文件使用
csv.DictReader,配合生成器推导式过滤。严禁一次性将数百万行数据塞入list(reader),杜绝内存击穿。 - 平滑演进策略:优先以标准库起步。当真正遇到连接池高复用瓶颈或复杂科学计算时,再定向引入
requests或pandas。轻装上阵,让脚本保持干净、健壮与极速。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









