

NumPy读取CSV文件:genfromtxt与loadtxt基础用法

全面解析NumPy读取CSV文件的两大核心函数loadtxt与genfromtxt的基础语法、参数配置、缺失值填充策略与常见报错排查。
在Python数值计算与数据分析任务中,NumPy是整个科学计算生态的底层基石。处理保存在逗号分隔值(CSV)文件中的矩阵与表格时,NumPy原生提供了两个核心函数:numpy.loadtxt 与 numpy.genfromtxt。理解这两个函数的适用边界与关键参数,不仅能避免在轻量任务中引入庞大第三方库的依赖,还能在处理规整数值矩阵或包含空缺值的实际观测数据时游刃有余。
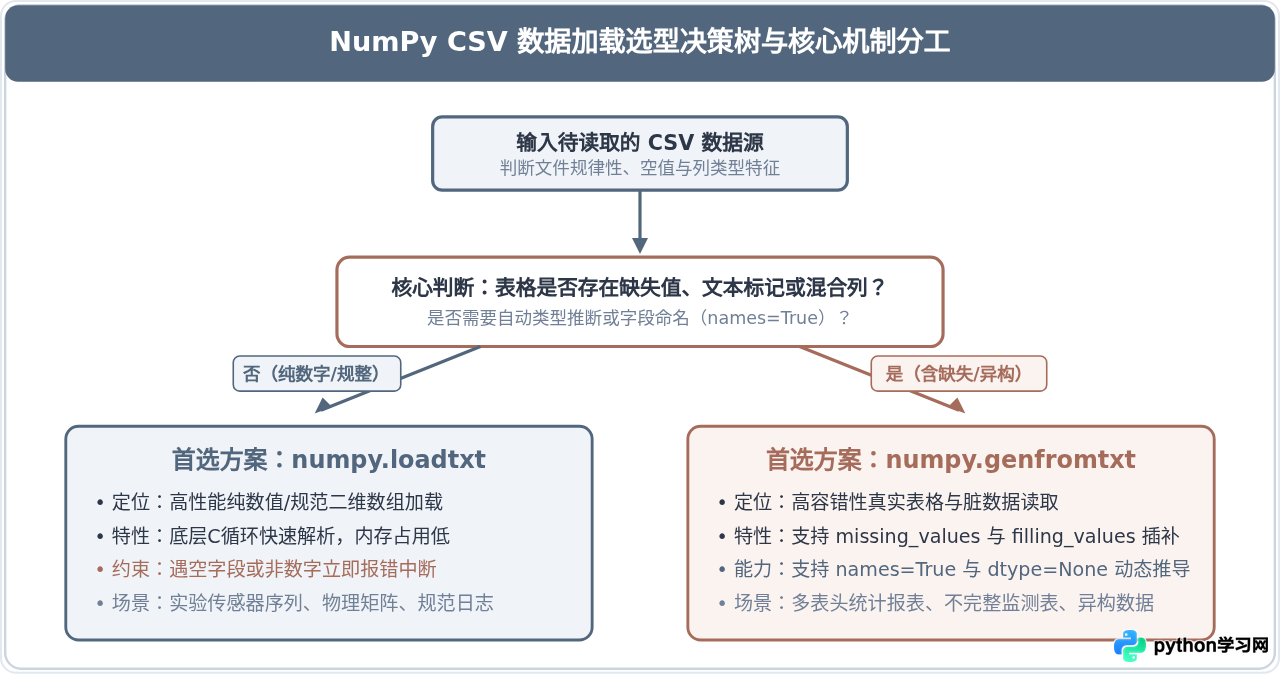
一、快速选型:两个函数的核心差异与分工
初学者常常困惑于为何NumPy会同时保留两个名字相近的文件读取函数。简单来说,它们的设计初衷分别指向了两种不同的数据现实:
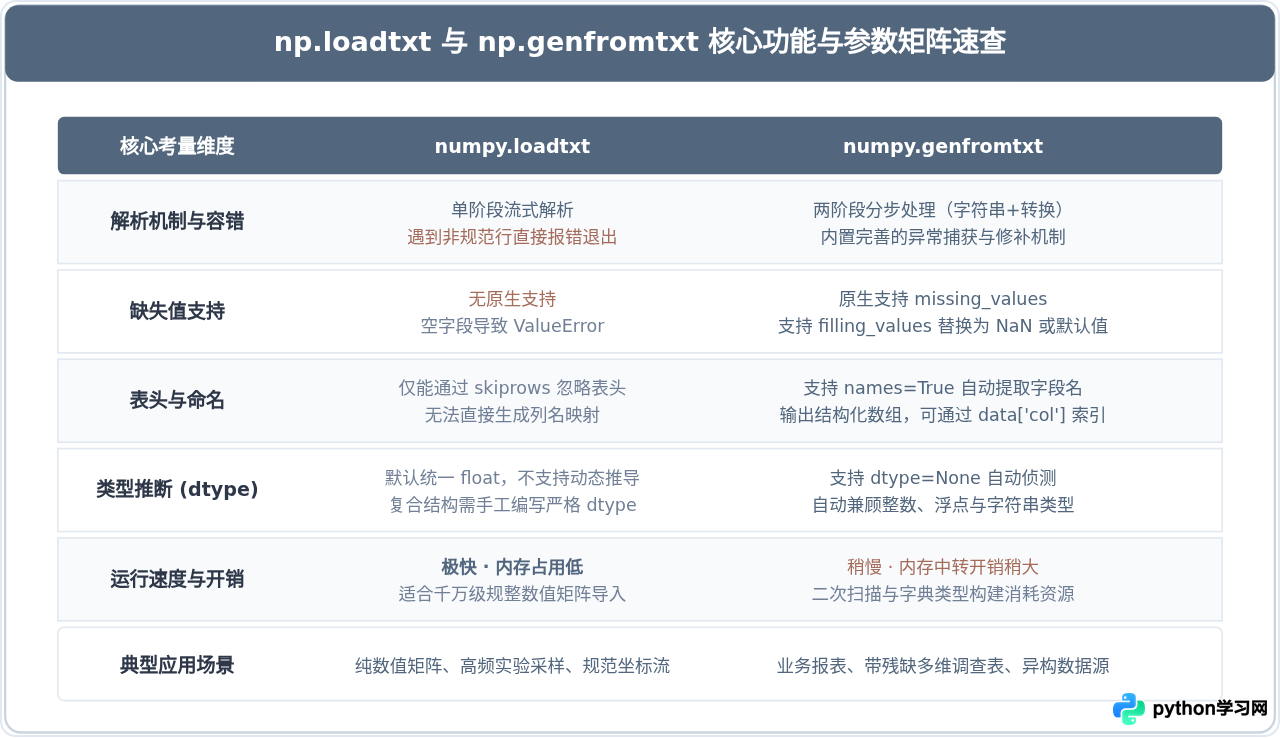
numpy.loadtxt:面向格式严格、无缺失值、类型单一的结构化数值文件。它的底层解析路径轻量精简,读取速度快、内存开销极低。但如果文件中存在空缺项、非预期字符串或格式破损,loadtxt会直接抛出异常中断执行。numpy.genfromtxt:面向真实业务导出、包含缺失值或多类型混合的复杂表格。它采用两阶段解析机制,允许用户指定缺失值的标记符与填充规则,并能自动推导混合数据类型或生成结构化数组(Structured Array),容错能力极高。
二、基础操作:使用 np.loadtxt 快速加载规整 CSV
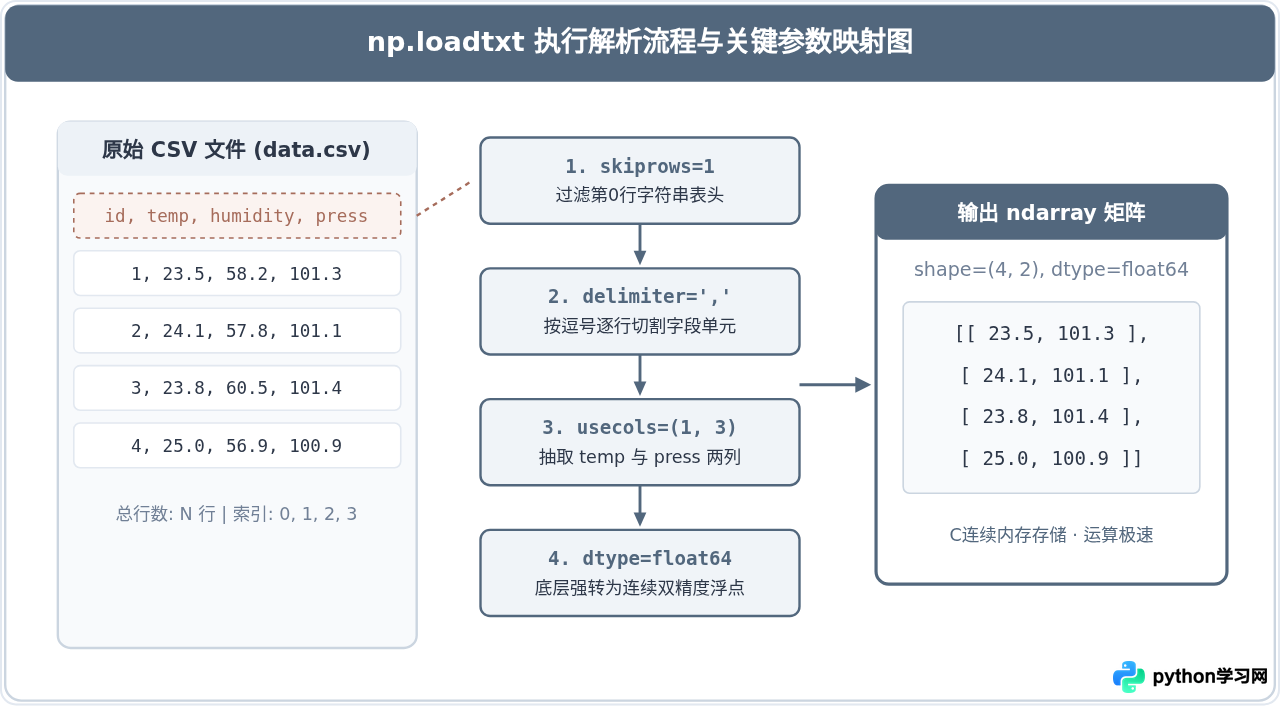
当面对格式整齐、纯数字或结构清晰的CSV时,np.loadtxt 是最高效的选择。它的函数签名紧凑,核心控制参数非常直观:
import numpy as np

# 基础调用形式
data = np.loadtxt(
    fname='sensor_data.csv',  # 文件名或文件路径对象
    delimiter=',',            # 分隔符,CSV默认为逗号
    skiprows=1,               # 跳过文件开头的表头行数
    usecols=(1, 2, 3),        # 仅读取指定列索引(元组或列表)
    dtype=np.float64          # 目标数据类型,默认为 float
)
核心参数解析
delimiter:字符串类型。标准CSV以半角逗号,分隔;若是制表符分隔文件(TSV),则设为\t;空格分隔则无需指定。skiprows:整数。CSV首行通常是字段名称(如time,temp,voltage),数值转换引擎无法将英文字符直接转为浮点数,必须使用skiprows=1避开表头。usecols:整数序列。如果原文件有数十列,但我们仅需要时间戳与温度列,指定usecols=(0, 2)可以避免多余列进入内存。unpack:布尔值。默认False返回二维数组;若设为unpack=True,可以直接解包为各个一维列向量,例如x, y = np.loadtxt(..., unpack=True)。
完整实操示例:加载实验数据
假设我们有一个记录传感器数据的本地文件 sensors.csv:
# 创建示例 CSV 文本文件
csv_content = """# 实验记录批次: 2026-A
step,voltage,current
1,4.98,0.21
2,5.01,0.22
3,5.00,0.20
4,4.99,0.21
"""
with open('sensors.csv', 'w', encoding='utf-8') as f:
    f.write(csv_content)

# 使用 loadtxt 读取数值列,跳过前两行说明与表头
data = np.loadtxt(
    'sensors.csv',
    delimiter=',',
    skiprows=2,          # 跳过批次注释行与字段名行
    usecols=(1, 2),       # 仅读取 voltage 与 current
    dtype=np.float32
)

print("数据形状:", data.shape)
print("前两行数据:\n", data[:2])若 sensors.csv 中某一行的电流值遗漏(例如 3,5.00,),或者包含形如 N/A、null 的非数字占位符,np.loadtxt 会瞬间崩溃并抛出:
ValueError: could not convert string to float: ''
在自动化数据处理脚本中,这种异常会直接中断流程。当数据源无法绝对保证整洁时,必须换用 np.genfromtxt。
三、进阶应对:使用 np.genfromtxt 处理缺失值与异构数据
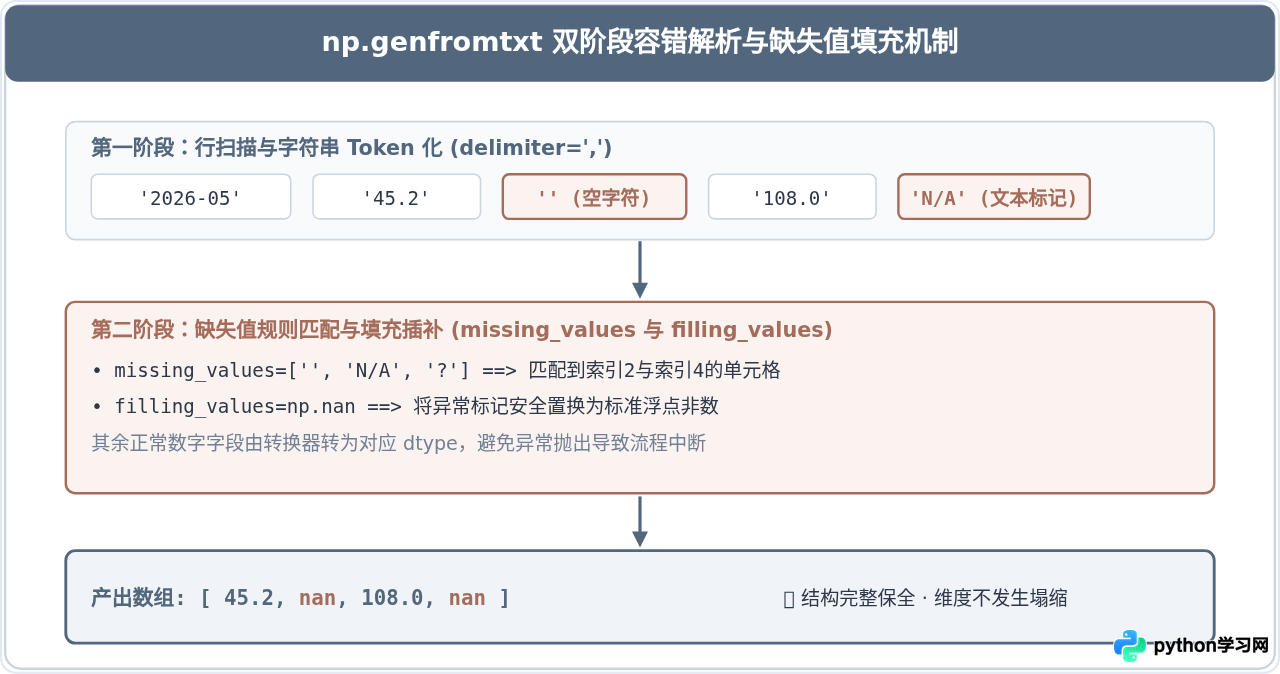
在现实工程与科学实验中,网络波动导致数据丢包、传感器暂时无响应或业务导出报表带空单元格是常态。numpy.genfromtxt 专门为此类“带伤”数据设计。它引入了强大的占位识别与填充替换机制。
核心高级参数配置
missing_values:用于指示哪些字符应该被视为空值。默认情况下,空字符串""会被视作缺失;如果你遇到形如"NA"、"NaN"、"?"或"null"的占位符,可以传入字符串列表或元组。filling_values:指定在发现缺失值时填入的数值。对于浮点型数组,通常填入np.nan以保留数学运算的追溯能力;也可以填入特定默认值(例如-1、0)。names=True:当首行是字段名时,设置此项会将第一行自动解析为字段名称,并将数据加载为 结构化数组(Structured Array),后续可通过类似字典的列名访问:data['temp']。dtype=None:智能类型推导。当不确定各列具体类型(有的列是整型,有的是浮点,有的是字符串)时,传入None,NumPy 会在初次扫描后自动为每一列分配最合适的数据类型。
完整实操示例:读取包含破损与缺失的 CSV
# 模拟真实世界中存在缺失与异常标记的数据源
dirty_csv = """date,station,temp,humidity
2026-05-01,ST01,22.4,65
2026-05-02,ST01,?,63
2026-05-03,ST02,24.1,
2026-05-04,ST02,N/A,59
"""
with open('dirty_weather.csv', 'w', encoding='utf-8') as f:
    f.write(dirty_csv)

# 使用 genfromtxt 进行高容错性解析
parsed_data = np.genfromtxt(
    'dirty_weather.csv',
    delimiter=',',
    names=True,                       # 自动将首行识别为列名
    dtype=None,                       # 各列类型自动推导
    encoding='utf-8',                 # 显式指定编码,支持字符串解析
    missing_values=['', '?', 'N/A'],   # 将空值、问号及N/A均判定为缺失
    filling_values=np.nan             # 统一用 NaN 填充
)

print("字段名称:", parsed_data.dtype.names)
print("温度列数据 (temp):", parsed_data['temp'])
print("温度是否包含缺失值:", np.isnan(parsed_data['temp']))当设置 names=True 且推导出结构化数组后,返回值是一个一维的元组序列,每个单元是一个带有字段名的 record。此时直接切片 parsed_data[0] 得到的是第一行记录;而通过字段名访问 parsed_data['humidity'] 才能提取对应列的一维数组。这为简单的按列统计提供了极大便利。
四、常见问题排查与避坑速查
排查 1:ValueError: could not convert string to float
这是使用 np.loadtxt 最容易碰到的报错。根本原因通常有三类:
- 未跳过表头:文件第一行是
"id,x,y"等字母,NumPy 尝试将其转为数字失败。对策:加入skiprows=1。 - 分隔符不匹配:数据实际上是以制表符(Tab)或分号(
;)分隔,但代码中仍保留delimiter=','。NumPy 会把整行当成一个巨大的字符串处理。对策:打开原文件确认实际分隔符,并准确赋值给delimiter。 - 数字中含有千分位逗号:例如
"1,250.50"。在标准CSV中这会导致字段被额外切分。对策:必须预先做文本清洗,或使用支持转换器的converters参数自定义解析函数。
排查 2:中文乱码与 UnicodeDecodeError
在中文操作系统环境下,Excel 导出的 CSV 文件常常默认采用 GBK 或 GB2312 编码,而 Python 3 与现代代码环境普遍默认 UTF-8。在调用两个函数时,请务必养成显式指定编码的习惯:
# 遇到包含中文列名或中文标记的文件
data = np.genfromtxt('data_gbk.csv', delimiter=',', encoding='gbk', names=True)
排查 3:注释字符误过滤
两个函数默认都将井号 # 视作注释开始符号。如果您的数据本身包含 #(例如颜色十六进制值 #FF5733 或流水号 #99201),整行或行末内容会被意外吞并导致列数不齐。此时应修改或关闭注释符:comments=None。
五、总结
NumPy读取CSV文件的核心方法可以总结为一句经验法则:“纯净规则矩阵用 loadtxt,容错复杂报表用 genfromtxt”。在不需要额外引入 Pandas 的轻量级脚本、算法开发或嵌入式计算场景中,充分利用这两个函数的参数组合,不仅能保持工程依赖的精简纯粹,更能构建出高效而稳健的数据加载通道。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









