

10个经典Python入门算法代码:冒泡排序与斐波那契数列
精选10个经典Python入门算法,深入讲解冒泡排序、斐波那契数列、二分查找等算法的执行机制、代码实现与复杂度分析。
1. 冒泡排序(Bubble Sort)
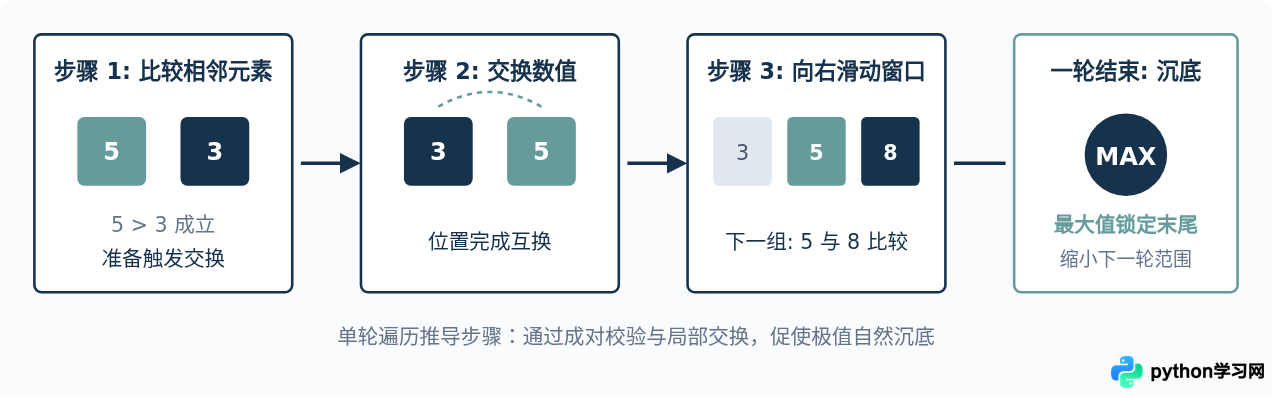
冒泡排序是所有排序算法的起点。它的基本逻辑是:重复遍历待排序数组,每次比较两个相邻元素,如果它们的顺序错误就交换位置。每一轮遍历结束后,当前序列中最大的元素都会“浮”到未排序部分的末端。
def bubble_sort(arr):
    n = len(arr)
    # 外层循环控制需要遍历的轮数
    for i in range(n):
        # 优化标记:若某一轮没有发生任何交换,说明已有序,直接退出
        swapped = False
        for j in range(0, n - i - 1):
            if arr[j] > arr[j + 1]:
                # Python特有的解包交换
                arr[j], arr[j + 1] = arr[j + 1], arr[j]
                swapped = True
        if not swapped:
            break
    return arr

# 测试用例
data = [64, 34, 25, 12, 22, 11, 90]
print("排序结果:", bubble_sort(data))注意:内层循环边界必须写为 n - i - 1,因为末尾的 i 个元素已经排定,无需重复比较,减 1 则防止索引越界。
2. 斐波那契数列(Fibonacci Sequence)
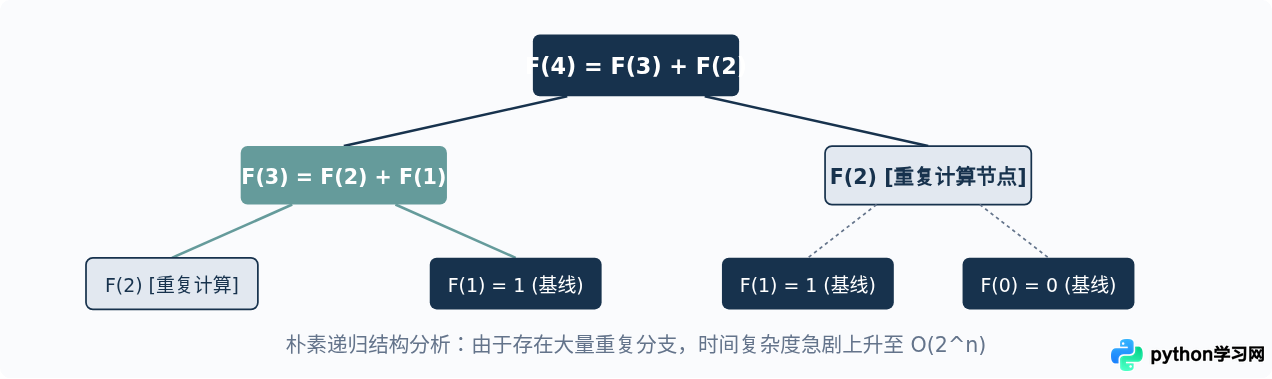
斐波那契数列定义为:从第3项开始,每一项都等于前两项之和(0, 1, 1, 2, 3, 5, 8...)。很多初学者直接写递归,导致大量的重复运算;在实际编程中,使用线性迭代或记忆化是效率更高的方案。
def fibonacci_iterative(n):
    if n <= 0:
        return 0
    elif n == 1:
        return 1

    # 状态转移:只需维护前两个数字
    prev, curr = 0, 1
    for _ in range(2, n + 1):
        prev, curr = curr, prev + curr
    return curr

# 测试用例
print("第 10 项斐波那契数:", fibonacci_iterative(10))3. 二分查找(Binary Search)
二分查找专门用于在已排序列表中查找目标。它每次取中间元素与目标值对比,若不匹配,则根据大小关系舍弃一半搜索区间。这体现了经典的“分治”思想。
def binary_search(arr, target):
    left = 0
    right = len(arr) - 1

    while left <= right:
        mid = (left + right) // 2
        if arr[mid] == target:
            return mid  # 找到目标,返回下标
        elif arr[mid] < target:
            left = mid + 1  # 目标在右半区
        else:
            right = mid - 1 # 目标在左半区
    return -1  # 未找到

# 测试用例 (列表必须有序)
sorted_list = [3, 9, 14, 19, 27, 33, 45, 52]
print("查找 27 的索引:", binary_search(sorted_list, 27))4. 选择排序(Selection Sort)
选择排序的工作机制非常直观:在未排序序列中找到最小元素,存放到排序序列的起始位置;然后再从剩余未排序元素中继续寻找最小元素,放到已排序序列的末尾。以此类推,直到所有元素均排序完毕。
def selection_sort(arr):
    n = len(arr)
    for i in range(n):
        min_idx = i
        for j in range(i + 1, n):
            if arr[j] < arr[min_idx]:
                min_idx = j
        # 将找到的最小值换到位置 i
        arr[i], arr[min_idx] = arr[min_idx], arr[i]
    return arr

# 测试用例
print("选择排序结果:", selection_sort([29, 10, 14, 37, 13]))5. 插入排序(Insertion Sort)
插入排序的逻辑就像整理手中的扑克牌。我们从左到右遍历列表,假设左侧部分始终有序,然后把当前取到的元素依次与左侧元素比较,为它找到合适的位置并插入进去。
def insertion_sort(arr):
    for i in range(1, len(arr)):
        key = arr[i]
        j = i - 1
        # 将大于 key 的元素向后移一位
        while j >= 0 and arr[j] > key:
            arr[j + 1] = arr[j]
            j -= 1
        arr[j + 1] = key
    return arr

# 测试用例
print("插入排序结果:", insertion_sort([12, 11, 13, 5, 6]))6. 线性查找(Linear Search)
线性查找是最原始也是最鲁棒的查找策略。在列表无序或者数据量极小的情况下,逐一比对元素是无需额外准备工作的标准方案。
def linear_search(arr, target):
    for index, value in enumerate(arr):
        if value == target:
            return index
    return -1

# 测试用例
raw_list = [4, 2, 9, 7, 1, 8]
print("查找 7 的索引:", linear_search(raw_list, 7))7. 欧几里得最大公约数算法(GCD)
辗转相除法(欧几里得算法)是数学与计算机结合的经典之作。它基于一条定理:两个正整数 a 和 b(a > b),它们的最大公约数等于 a 除以 b 的余数 r 和 b 之间的最大公约数。
def gcd(a, b):
    while b != 0:
        a, b = b, a % b
    return a

# 测试用例
print("48 和 18 的最大公约数:", gcd(48, 18))8. 双指针回文字符串检测(Palindrome Check)
回文字符串是指正读和反读都相同的文本。使用首尾双指针向中间靠拢检测,能够在常数额外空间下完成判定,是学习“双指针技巧”的极佳入口。
def is_palindrome(s):
    # 过滤非字母数字字符并转为小写
    cleaned = ''.join(ch.lower() for ch in s if ch.isalnum())
    left, right = 0, len(cleaned) - 1

    while left < right:
        if cleaned[left] != cleaned[right]:
            return False
        left += 1
        right -= 1
    return True

# 测试用例
print("是否为回文串:", is_palindrome("A man, a plan, a canal: Panama"))9. 阶乘计算(Factorial: 迭代与递归)
阶乘(n!)即 1 到 n 之间所有正整数的乘积。它是理解递归基线条件(Base Case)与递推展开的基础模型。在生产中优先选择迭代方式以避免栈溢出。
def factorial(n):
    if n < 0:
        raise ValueError("负数没有阶乘")
    result = 1
    for i in range(1, n + 1):
        result *= i
    return result

# 测试用例
print("5 的阶乘:", factorial(5))10. 两数之和(Two Sum 哈希查找)
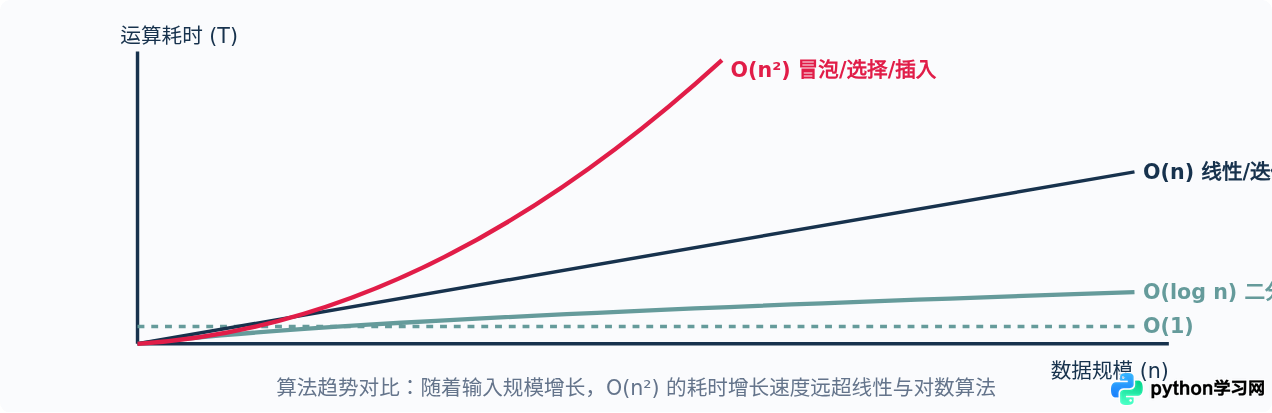
两数之和通常作为各类数据结构面试的第一题。暴力的双层循环时间复杂度为 O(n²),而通过 Python 的字典(哈希表)记录访问过的数字与索引,可以将查找优化至线性时间复杂度 O(n)。
def two_sum(nums, target):
    lookup = {}
    for index, num in enumerate(nums):
        diff = target - num
        if diff in lookup:
            return [lookup[diff], index]
        lookup[num] = index
    return []

# 测试用例
print("目标和索引匹配结果:", two_sum([2, 7, 11, 15], 9))算法复杂度与核心逻辑对比
在工程实践中,评判一段算法的好坏主要依赖时间复杂度(耗时长短)和空间复杂度(消耗内存)。下表汇总了本文介绍的 10 个入门算法在平均情况下的资源消耗特征:
| 算法名称 | 平均时间复杂度 | 额外空间复杂度 | 核心设计思想 |
|---|---|---|---|
| 冒泡排序 | O(n²) | O(1) | 相邻比较、极值沉底 |
| 斐波那契(迭代) | O(n) | O(1) | 滚动变量、状态转移 |
| 二分查找 | O(log n) | O(1) | 折半搜索、分治裁剪 |
| 选择排序 | O(n²) | O(1) | 线性遍历找极小值 |
| 插入排序 | O(n²) | O(1) | 局部有序维护、移位插入 |
| 线性查找 | O(n) | O(1) | 逐项扫描、无序遍历 |
| 欧几里得 GCD | O(log(min(a, b))) | O(1) | 辗转相除、模运算 |
| 回文检测 | O(n) | O(1) | 首尾对齐、双指针逼近 |
| 阶乘计算(迭代) | O(n) | O(1) | 乘法累积、边界终止 |
| 两数之和(哈希) | O(n) | O(n) | 空间换时间、哈希寻址 |
初学者的算法避坑指南与进阶路径
在动手敲这10个经典算法代码时,初学者经常会在索引边界、变量作用域和退出条件上踩坑。以下三项是最常见的注意点:
arr[j + 1] 或者 right = len(arr) - 1 中的加减操作最容易导致索引超出数组长度。在下笔写循环前,先手工带入 n=0 和 n=1 验证边缘条件。
arr.sort() 是直接在原列表上修改(空间消耗小),而 sorted(arr) 会生成新列表。本文中的冒泡、选择与插入排序均属于原地算法(In-place Algorithm),不会创建额外列表。
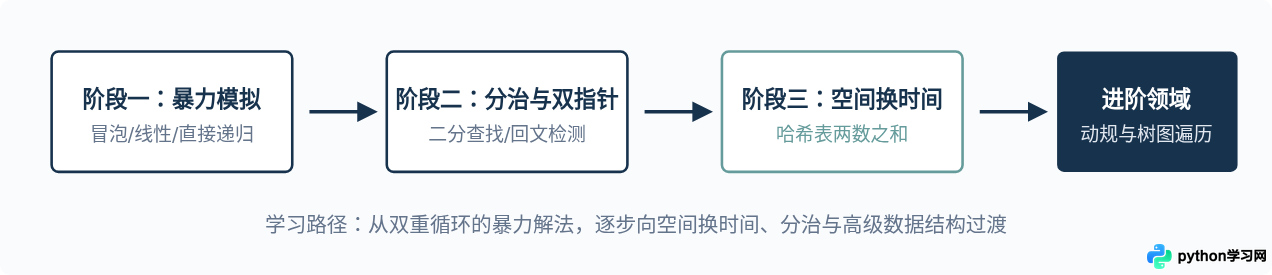
掌握这10个基础代码后,建议脱离教程,尝试用白纸或空编辑器独立重写一遍“冒泡排序”与“斐波那契数列迭代版”。当你能不假思索地写出边界条件与状态更新语句时,算法底层的逻辑链条就已经在你的思维中建立完成了。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









