

python必背源代码map/filter/reduce函数式代码
深入解析 Python 中 map、filter 与 functools.reduce 函数的核心语法、执行机制、高频必背源代码示例与工程避坑指南,对比列表推导式给出最佳选型实践。
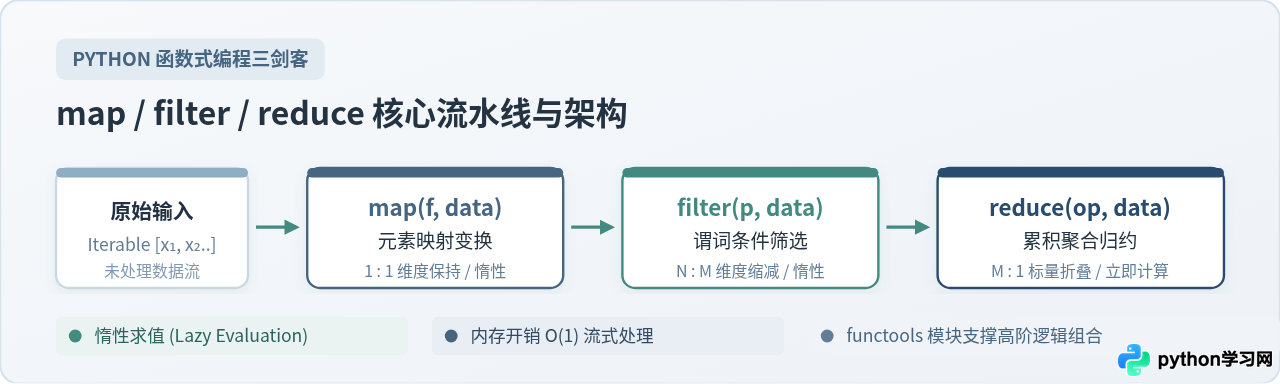
map()、filter() 与 functools.reduce() 是函数式编程的三大基石。它们分别对应数据清洗与运算中出现频次最高的三种操作:逐项映射转换、谓词条件筛选与累积状态归约。通过解耦数据遍历与逻辑运算,这三者不仅天然支持惰性求值与恒定 O(1) 内存开销,也是编写简洁流式处理管线的必背核心技能。本文梳理三者的语法机制、高频通用源代码模板、实战组合流水线,以及工程实践中的避坑法则。
一、map() 函数:序列元素的批量映射转换
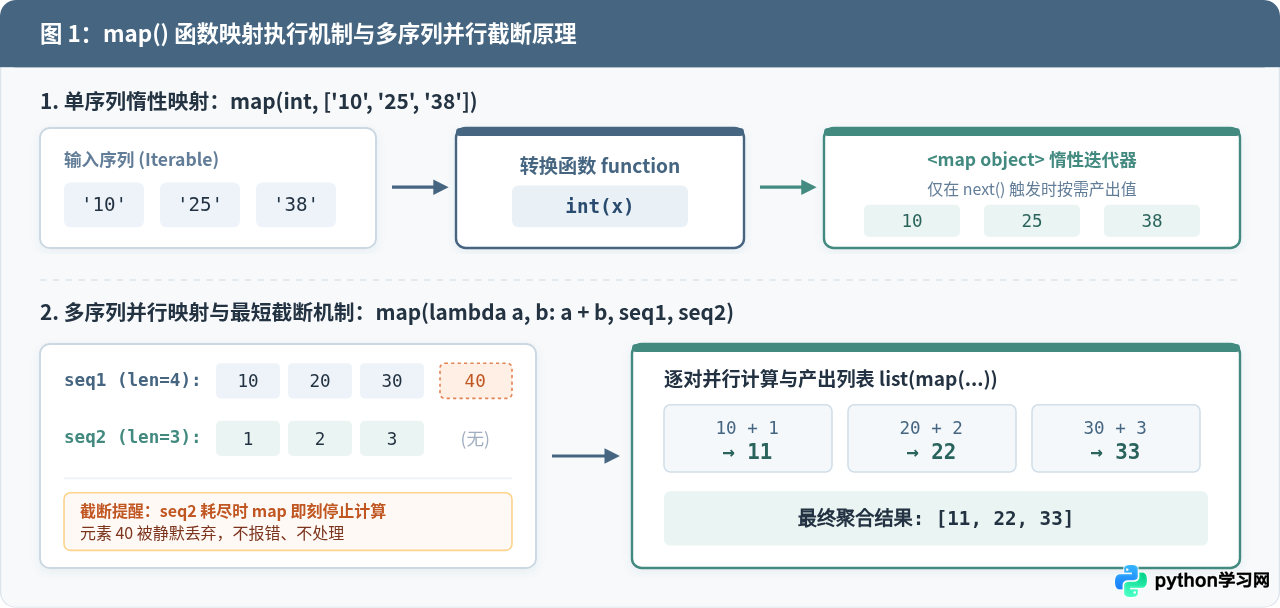
map() 函数用于将指定的转换逻辑无差别地施加于一个或多个输入序列的每一个元素上。其标准语法形式为 map(function, iterable, ...)。
在 Python 3 中,map() 具有至关重要的惰性求值(Lazy Evaluation)特性:它不会在调用时立即生成完整的底层列表,而是返回一个 map object 迭代器对象。只有当程序通过 for 循环、list() 构造器或 next() 主动取值时,才会逐项计算对应的结果。这一机制使得它在处理超大规模数据流或文件日志时,瞬时内存占用始终保持在 O(1)。
1. 必背源码场景一:单序列类型转换与文本格式化清洗
当需要将一组格式不规范的文本数据清洗并转为数值时,直接将已有的内置函数或类(如 int、float、str.strip)作为参数传入 map(),代码表达极度紧凑。
# 场景:清洗外部接口返回的脏数据并转为标准整数
raw_records = ["  102 ", "250\n", "\t388", " 419 "]

# 将 str.strip 映射到每一项清除空白,再转为 int
cleaned_numbers = list(map(int, map(str.strip, raw_records)))

print("清洗后的整数序列:", cleaned_numbers)
print("均值计算结果:", sum(cleaned_numbers) / len(cleaned_numbers))清洗后的整数序列: [102, 250, 388, 419] 均值计算结果: 289.75
2. 必背源码场景二:多序列并行映射与最短序列自动截断
map() 支持传入多个可迭代对象。此时传入的函数必须接受相同数量的形参。map() 会并行从各个序列中同步取出索引对应的项传给函数。若传入的序列长度不同,map() 会在最短的序列耗尽时立刻停止计算,超出长度的多余元素会被完全忽略。
# 场景:批量核算单价与销量的总金额(序列长度不一致)
unit_prices = [12.5, 45.0, 99.9, 150.0]  # 4 项
quantities  = [10, 2, 5]                  # 3 项(最短序列)

# 多序列并行处理:lambda 接收两个参数分别对应两组序列
total_revenues = list(map(lambda price, qty: round(price * qty, 2), unit_prices, quantities))

print("并行核算结算结果:", total_revenues)并行核算结算结果: [125.0, 90.0, 499.5]
二、filter() 函数:基于谓词的条件筛选与清洗
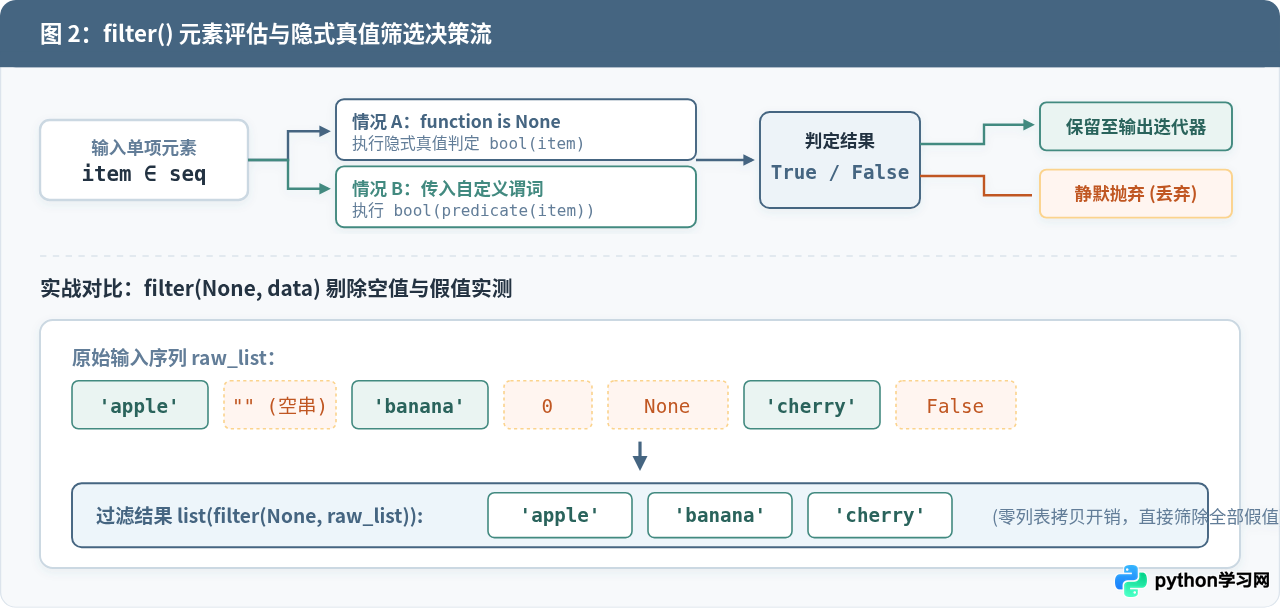
filter() 函数用于根据布尔判定规则(谓词函数 Predicate)从序列中提取符合条件的元素,过滤掉不合格项。其语法为 filter(function_or_none, iterable)。与 map() 一致,它同样返回惰性求值的 filter object 迭代器。
1. 必背源码场景一:业务实体谓词筛选
在业务数据过滤中,我们通常结合 lambda 表达式或命名谓词函数,筛选满足多个复合条件的记录。
# 场景:从服务节点健康指标中筛选出高负载异常节点
servers = [
    {"ip": "192.168.1.10", "cpu": 45, "healthy": True},
    {"ip": "192.168.1.11", "cpu": 88, "healthy": True},
    {"ip": "192.168.1.12", "cpu": 92, "healthy": False},
    {"ip": "192.168.1.13", "cpu": 76, "healthy": True},
]

# 谓词:节点健康且 CPU 占用率大于等于 75%
high_load_servers = list(filter(lambda s: s["healthy"] and s["cpu"] >= 75, servers))

print("高负载活跃节点列表:")
for s in high_load_servers:
print(f" -> IP: {s['ip']}, CPU: {s['cpu']}%")高负载活跃节点列表: -> IP: 192.168.1.11, CPU: 88% -> IP: 192.168.1.13, CPU: 76%
2. 必背源码场景二:filter(None, iterable) 极速剔除假值
当把 None 作为第一个参数传给 filter() 时,Python 会对序列中每一项执行隐式布尔值评估(等价于 bool(item))。所有等价于布尔假的值(如空字符串 ""、数字 0、None、False、空列表 [])都将被自动过滤。这是处理脏数据时最经典的单行代码之一。
# 场景:清洗用户输入的表单字段列表,剔除无效及空项
user_inputs = ["admin@example.com", "", "sales@test.com", None, "0", 0, False, "support@svc.cn"]

# 传入 None 作为判定函数
valid_entries = list(filter(None, user_inputs))

print("过滤后的有效真值项:", valid_entries)过滤后的有效真值项: ['admin@example.com', 'sales@test.com', '0', 'support@svc.cn']
三、functools.reduce() 函数:二元累积与状态折叠
reduce() 不再是 Python 3 的内置全局函数,而是收敛至标准库模块 functools 中,使用前必须通过 from functools import reduce 显式导入。
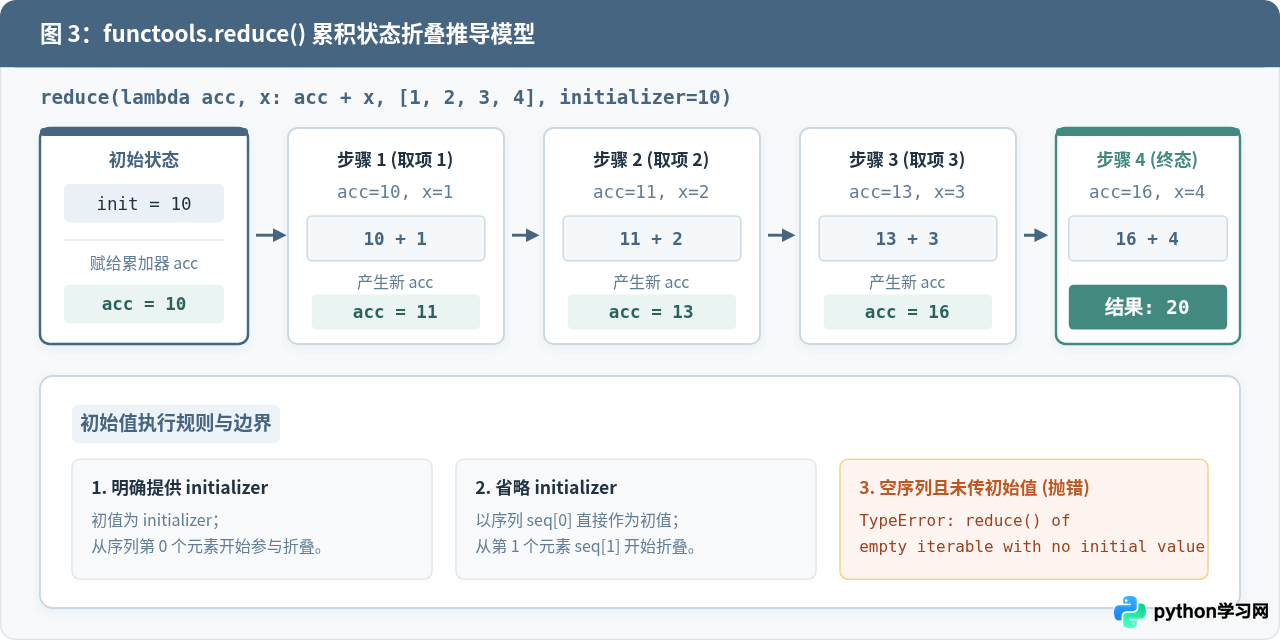
其完整语法为 reduce(function, iterable[, initializer])。function 必须是一个接收两个参数的二元函数 f(acc, item)。与 map 和 filter 的惰性机制截然不同,reduce() 会立即执行折叠计算(Eager Evaluation),遍历全部项后返回一个单一的折叠结果。
1. 必背源码场景一:阶乘与连乘积计算
在标准库 math.prod 普及前,reduce 搭配 operator.mul 是实现连乘计算的标准函数式范式。
from functools import reduce
import operator

# 场景:计算连续因子的阶乘折叠积 1 * 2 * 3 * 4 * 5
factors = [1, 2, 3, 4, 5]

# 使用 operator.mul 规避 lambda 匿名函数开销
factorial_5 = reduce(operator.mul, factors, 1)

print("5 的阶乘折叠计算结果:", factorial_5)5 的阶乘折叠计算结果: 120
2. 必背源码场景二:字典列表的高维状态归并与分组统计
reduce 最强大的工程应用在于将平面列表聚合为高维结构(如字典或集合)。通过明确设置 initializer={},累加器变量 acc 在首轮即可作为字典使用。
from functools import reduce

# 场景:将多条带有分类标签的销售流水聚合为分类销售额汇总字典
transactions = [
    {"category": "硬件", "amount": 3200},
    {"category": "配件", "amount": 150},
    {"category": "硬件", "amount": 1800},
    {"category": "服务", "amount": 600},
    {"category": "配件", "amount": 280},
]

def merge_sales(acc, item):
    cat = item["category"]
    acc[cat] = acc.get(cat, 0) + item["amount"]
    return acc

# 传入空字典 {} 作为 initializer 初始累加器
category_totals = reduce(merge_sales, transactions, {})

print("按类目聚合汇总结果:", category_totals)按类目聚合汇总结果: {'硬件': 5000, '配件': 430, '服务': 600}
四、综合实战:构建函数式数据处理流水线(Pipeline)
在实际生产环境中,filter、map、reduce 通常级联组成单向数据流管道:首先通过 filter 剔除脏数据或非目标数据,接着使用 map 完成数据结构清洗与币种转换,最后利用 reduce 完成最终财务汇总。
from functools import reduce

# 原始跨境支付流水记录
raw_orders = [
    {"order_id": "A101", "status": "COMPLETED", "currency": "USD", "amount": 100.0},
    {"order_id": "A102", "status": "PENDING",   "currency": "USD", "amount": 250.0},
    {"order_id": "A103", "status": "COMPLETED", "currency": "EUR", "amount": 80.0},
    {"order_id": "A104", "status": "CANCELLED", "currency": "USD", "amount": 40.0},
    {"order_id": "A105", "status": "COMPLETED", "currency": "USD", "amount": 150.0},
]

# 汇率映射表
FX_RATES = {"USD": 7.25, "EUR": 7.80}

# 流水线阶段 1:过滤有效已完成订单 (filter)
valid_orders = filter(lambda o: o["status"] == "COMPLETED", raw_orders)

# 流水线阶段 2:换算为人民币标准金额 (map)
cny_amounts = map(lambda o: round(o["amount"] * FX_RATES[o["currency"]], 2), valid_orders)

# 流水线阶段 3:汇总为总销售额与单据计数复合状态 (reduce)
def aggregate_metrics(acc, amount):
    acc["total_revenue"] += amount
    acc["order_count"] += 1
    return acc

summary = reduce(aggregate_metrics, cny_amounts, {"total_revenue": 0.0, "order_count": 0})

print("====== 财务结算统计报告 ======")
print(f"有效订单笔数: {summary['order_count']} 笔")
print(f"折合人民币总计: ¥{summary['total_revenue']:.2f}")====== 财务结算统计报告 ====== 有效订单笔数: 3 笔 折合人民币总计: ¥2436.50
五、函数式三剑客与列表推导式的工程选型对比
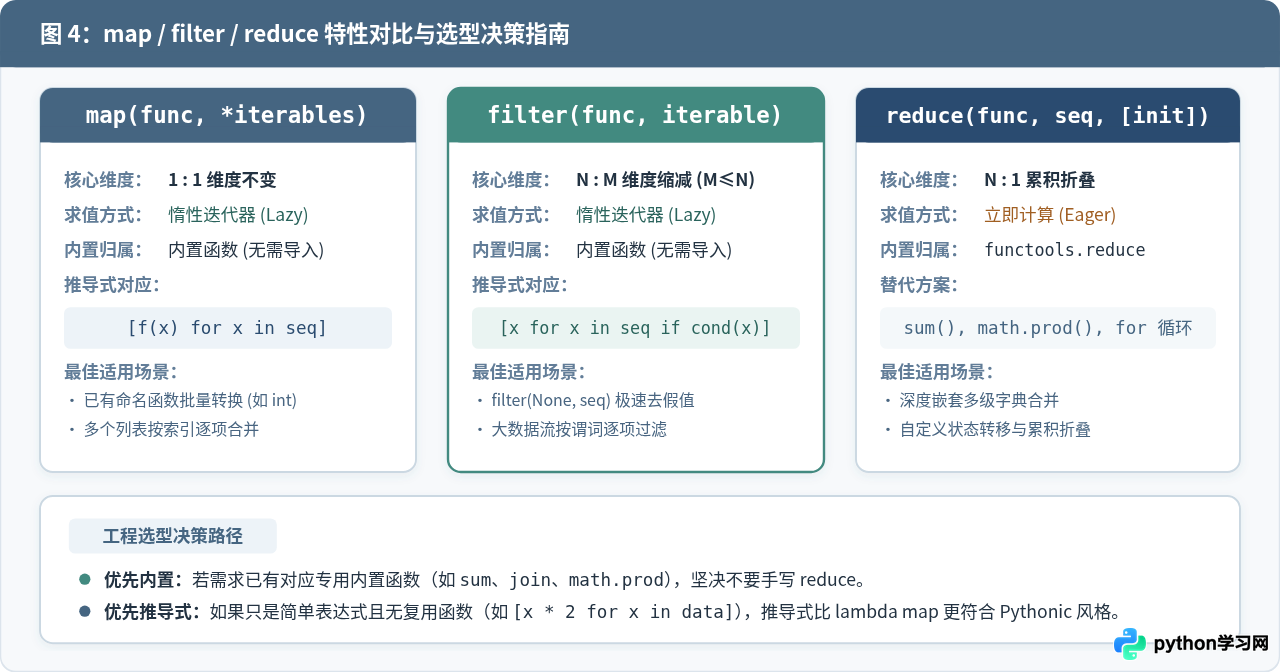
很多初学者常困惑:既然 Python 提供了强大的列表推导式(List Comprehension)和生成器表达式,为什么还要学习 map/filter/reduce?工程实践中两者的取舍依据如下:
| 对比维度 | map() / filter() | 列表推导式 [x for x in seq] | functools.reduce() |
|---|---|---|---|
| 求值时机 | 惰性求值(按需产出) | 立即求值(生成器为惰性) | 立即求值(标量折叠) |
| 已有函数调用 | 极简高效:map(int, seq) |
语法冗余:[int(x) for x in seq] |
依赖二元算子 |
| 复杂内联逻辑 | 需写 lambda,可读性较低 |
清晰直观,语义自然 | 逻辑复杂时推荐常规 for 循环 |
| 专用内置替代 | - | - | 求和用 sum(),连乘用 math.prod() |
六、必避开的三个运行期常见陷阱
map 和 filter 生成的是迭代器对象。一旦经过一次遍历(例如被 list()、sum() 或 for 循环消费),迭代器游标便抵达末尾。若再次尝试遍历该对象,将得到空结果而不会报错。如果需要多次使用计算结果,应在首轮显式转换为 list 或 tuple 固化存储。
如果在未传入
initializer 的情况下对空序列调用 reduce(),Python 会直接抛出:TypeError: reduce() of empty iterable with no initial value。防坑规范:在编写健壮业务代码时,务必显式指定
initializer(例如数值累加设为 0,字典合并设为 {})。
当对多个不等长的序列使用
map() 时,一旦最短序列耗尽,后续元素将被无警告地忽略。如果业务要求“长度不匹配时必须严格报错”或“缺失项补默认值”,应当优先使用标准库 itertools.zip_longest(),避免非预期的静默丢弃。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









