

Python怎么导入包:import与from...import用法详解

深入详解Python中导入模块与包的核心语法,对比import与from...import的机制差异、命名空间隔离、导入规范与常见避坑指南。
在 Python 开发中,组织和复用代码的核心方式是模块(Module)与包(Package)。无论是调用 Python 自带的标准库、通过 pip 安装的第三方扩展,还是在项目内部拆分多个业务文件,都必须依赖导入语法。Python 提供了两种最主要的导入语句:import 与 from ... import ...。本文将系统梳理两者的核心语法、底层命名空间差异、模块搜索路径机制,以及实际项目中的组织规范与典型避坑要点。
一、Python 中的模块、包与查找机制
在深入具体语法前,需要先明确 Python 中“模块”和“包”的定义。单份 .py 文件就是一个独立的模块;而包含多个模块的文件夹在配置了初始化结构后便构成了包。在 Python 3.3 之后,普通目录也可作为命名空间包被识别,但推荐在包目录下保留 __init__.py 文件以明确标识包范围并承载初始化逻辑。
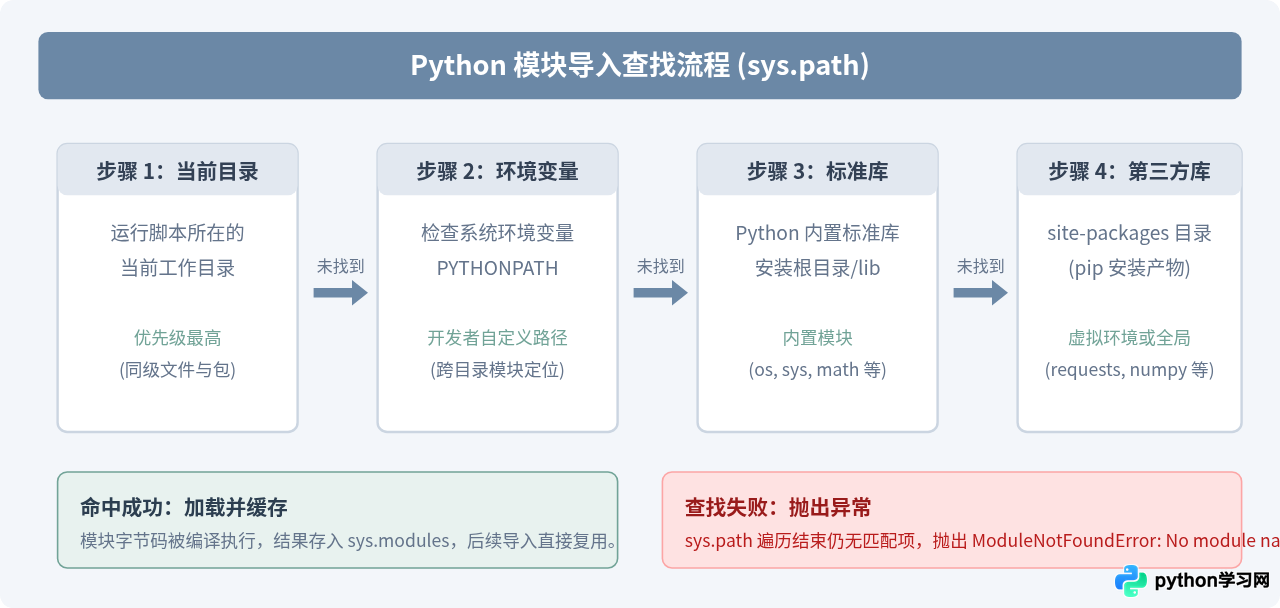
当执行导入语句时,Python 并不会随意遍历整个硬盘,而是依据 sys.path 列表按序查找对应名称的目标。如果所有路径均未命中,程序便会抛出 ModuleNotFoundError 异常。
二、import 语句的完整用法
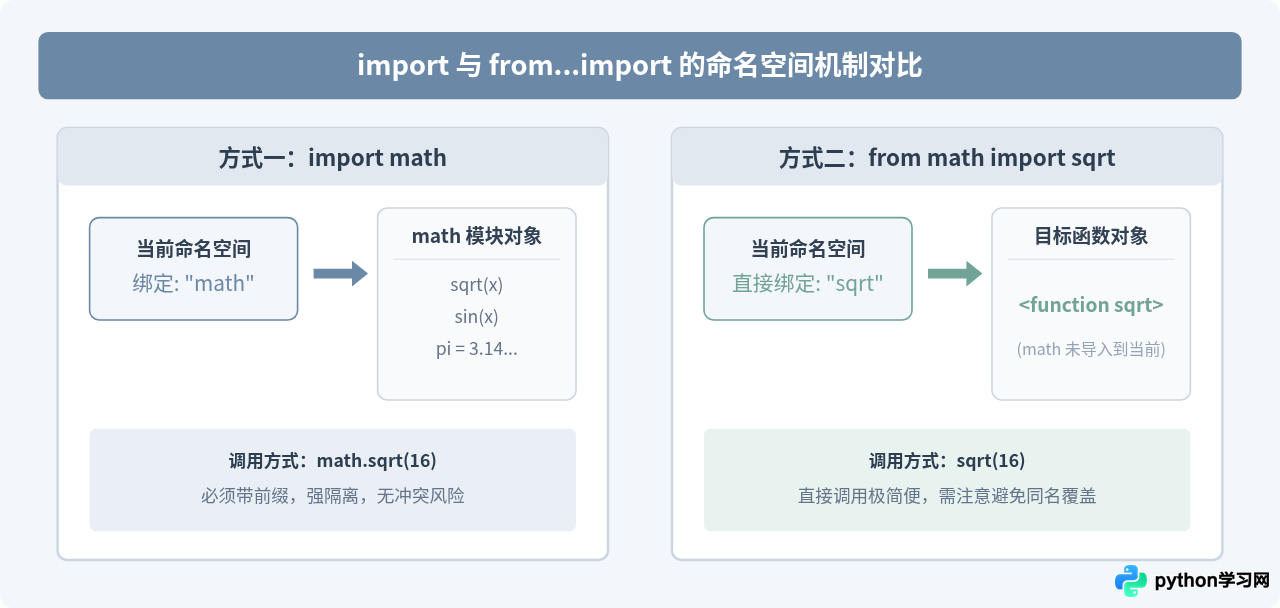
import 是最基础的导入形式,其核心思想是引入模块本身作为对象,随后通过“模块名.属性/函数”的点号语法访问其内部成员。
1. 基础导入
import math

result = math.sqrt(16)
print(result) # 示例输出:4.0这种写法的最大优势在于命名空间清晰。代码阅读者能立即知道 sqrt 来自 math 模块,避免与当前文件中可能定义的同名函数产生混淆。
2. 使用 as 进行重命名(别名)
当模块名称较长,或者在数据科学与工程中有约定俗成的简写时,可以使用 as 关键字为导入对象建立本地别名:
import numpy as np
import pandas as pd

arr = np.array([1, 2, 3])
在起别名后,原始模块名在当前作用域中不再可用,必须使用别名访问。
3. 导入多层级子模块
若要使用某个复杂包深层次下的子模块,可以直接使用点号语法连续导入:
import urllib.parse

parsed = urllib.parse.urlparse("https://example.com/api?id=1")
print(parsed.query)  # 示例输出:id=1
此时当前命名空间中仅绑定了顶层名称 urllib,通过点号级联查找到 parse。
三、from ... import ... 的具体用法与适用场景
from ... import ... 允许开发者从指定的模块或包中挑选特定的函数、类、变量或子模块,直接放置到当前命名空间中。调用时无需再携带模块名前缀。
1. 直接导入特定成员
from math import sqrt, pi

print(sqrt(25))  # 直接调用,无需 math.
print(pi)        # 示例输出:3.141592653589793
2. 结合 as 解决名称冲突
如果导入的成员与本地已有变量或函数冲突,或者两个不同包中存在同名工具(例如标准库的 datetime 与其它日历库),可以使用 as 赋予别名:
from datetime import datetime as dt

now = dt.now()
3. 谨慎使用通配符导入(from module import *)
Python 允许使用星号通配符将目标模块中定义的所有公共属性一次性导入当前命名空间:
from math import *

# 不推荐在正式生产代码中使用1. 命名空间污染:导入模块中成百上千个变量与函数会无差别涌入当前作用域,容易在无意间覆盖已有函数或变量。
2. 代码可读性骤降:后续维护人员无法通过文本搜索快速判定某个函数的定义来源。
3. 静态检查失效:许多 IDE 和 linter(如 flake8、pylint)无法精确追踪变量引用,增加调试成本。
四、项目中导入包的标准操作步骤
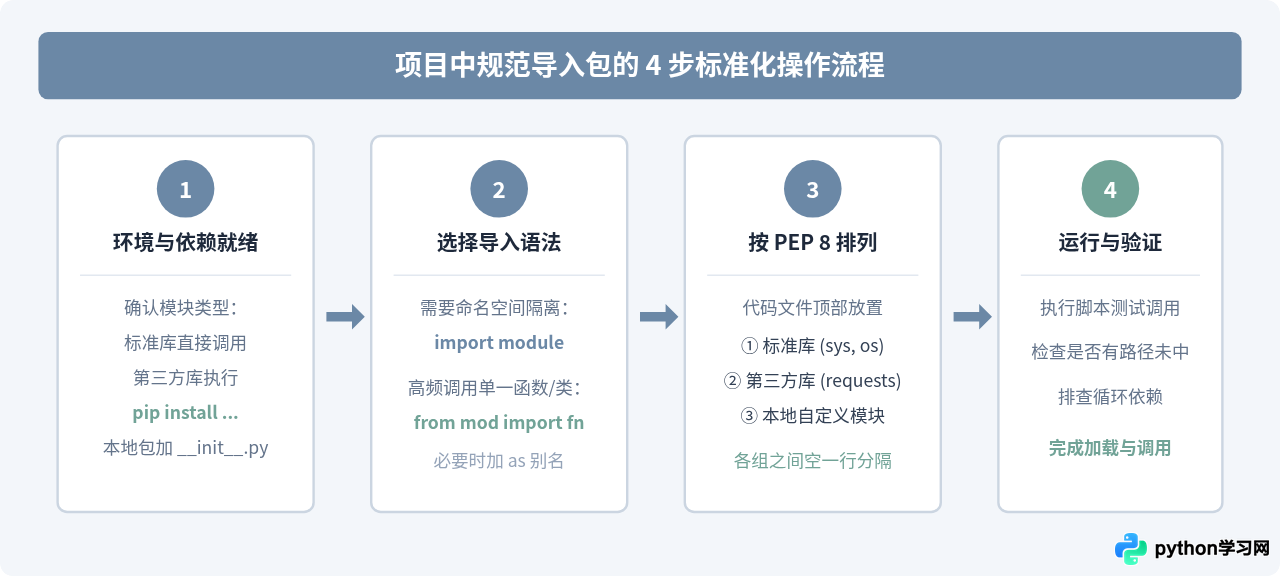
在多目录、多层级的实际开发工程中,正确组织导入语句能确保代码稳定运行、依赖关系清晰。推荐遵循以下四个标准操作步骤:
步骤细节详解
1. 确认模块安装环境:如果你要导入的是第三方扩展(如 requests),请确保当前 Python 运行环境或虚拟环境中已经安装。可在终端输入 python -m pip list 验证,或者在代码中尝试简单引入。
2. 本地项目结构组织:建议按照清晰的模块树搭建目录结构。例如:
my_project/
│── main.py
└── services/
    ├── __init__.py
    ├── auth.py
    └── payment.py
在 main.py 中导入 services 下的模块,推荐使用绝对导入:
# main.py 中:
from services.auth import verify_user
from services.payment import process_order
3. 相对导入(Relative Imports):在包内部的模块互相引用时,可以使用点号相对路径。单个点 . 代表当前目录,两个点 .. 代表上一级目录:
# 在 services/payment.py 内部引用同级 auth.py:
from .auth import get_current_user
注意:包含相对导入的文件不能作为主程序直接通过 python payment.py 运行,而应从包根目录作为模块加载(如 python -m services.payment)。
五、常见导入错误与避坑指南
在导入包和模块的过程中,开发者最常遇到以下三类典型问题:
1. 命名冲突:本地文件名与内置/第三方库重名
这是初学者最容易踩的陷阱。例如你新建了一个名为 math.py、test.py 或 requests.py 的练习文件,随后在该文件或同级文件中编写 import math 或 import requests。
原因:回顾图 1 的查找机制,当前脚本所在目录拥有最高优先级。解释器会直接加载你创建的本地文件,导致内置方法根本无法读取,报错提示 AttributeError: module 'math' has no attribute 'sqrt'。
解决方法:切勿使用 Python 标准库、核心内置函数或常用第三方库的名字为自己的脚本和目录命名。
2. 循环导入(Circular Import)
当模块 A 在顶部 import B,而模块 B 同时在顶部 import A 时,就会发生循环导入。因为当 A 正在执行、尚未完成初始化时,B 试图从 A 中读取尚未建立的符号,导致报错 ImportError: cannot import name ...。
解决方法:
- 解耦公共逻辑:将 A 与 B 共同依赖的数据结构或基类剥离到一个独立的第三模块(如
models.py或common.py)中。 - 延迟导入(函数内导入):将导入语句移入具体执行的函数体内,仅在函数被调用时再进行局部导入,打破模块加载时的死锁。
3. ModuleNotFoundError 路径丢失
在子目录或脚本嵌套调用时,常出现上层模块找不到的问题。这是因为当前脚本运行时的 sys.path[0] 默认是该脚本所在子文件夹,而不是项目根目录。
解决方法:统一在项目根目录下通过模块模式运行程序:python -m package.submodule;或者在启动入口处规范管理 PYTHONPATH。
六、选型决策总结
在实际编码中,选择 import 还是 from ... import ... 并非个人喜好问题,而是关于代码可读性、命名空间安全性与重构便利度的权衡。
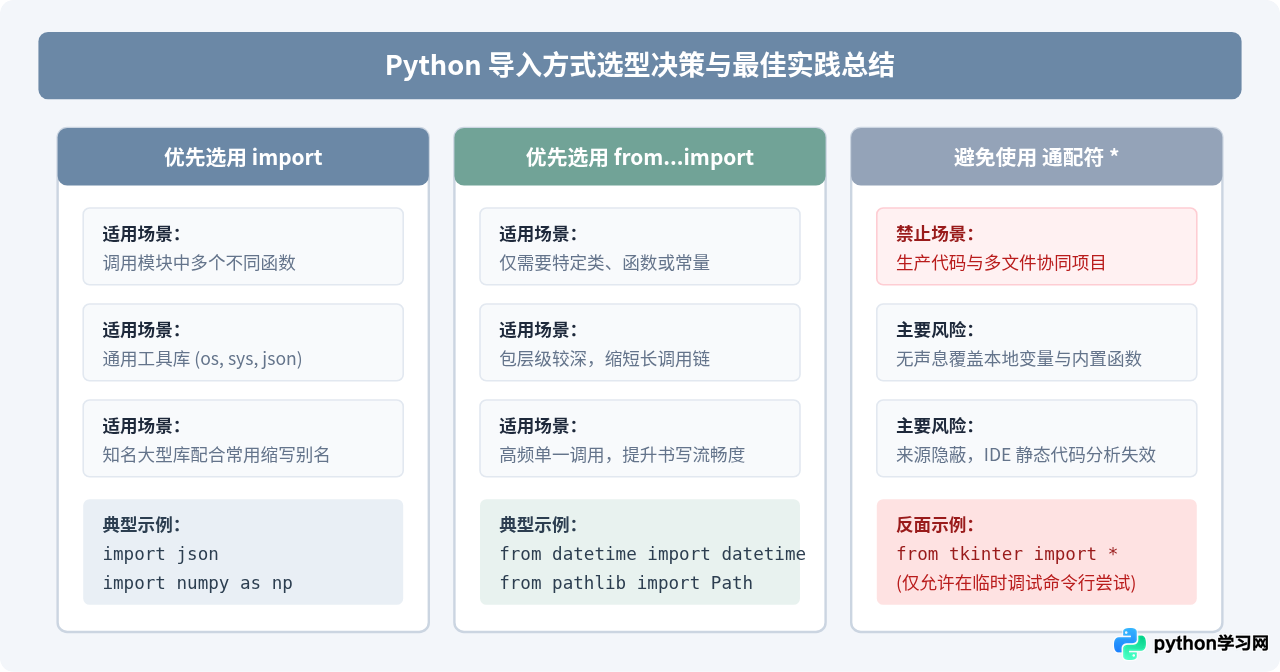
下表简明总结了两种方式的核心特性对比:
| 对比维度 | import 模块名 | from 模块名 import 成员 |
|---|---|---|
| 命名空间影响 | 仅引入模块名,不污染当前作用域 | 直接将具体符号引入当前作用域 |
| 代码调用书写 | 模块名.成员()(较严谨、长) |
成员()(直接、简练) |
| 同名覆盖风险 | 极低,仅模块名本身可能重名 | 中等,若本地有同名变量易被覆盖 |
| 重命名支持 | 支持 import A as B |
支持 from A import B as C |
| 推荐使用场景 | 调用多个函数、核心工具库、数学科学计算库 | 调用特定高频类/函数、包深度大且名称明确的场景 |
掌握了 import 与 from ... import ... 的语法机制与底层搜索逻辑后,在面对不同规模的项目时,便能自如选择最规范的导入策略,让代码既保持清晰的边界,又具备良好的可读性与健壮性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









