

Python爬虫常见报错排查:编码错误、连接超时与解析失败

针对Python爬虫开发中最高频的编码乱码、网络连接超时以及数据解析为空三大类报错,提供系统化的排查路径、根因分析、防御代码与完整解决方案。
在编写 Python 网络爬虫的过程中,绝大部分程序中断或数据缺失都可以归结为三类核心问题:字符编码识别错误导致的乱码或解码中断、网络链路波动导致的连接或读取超时,以及页面结构变更或反爬拦截导致的 DOM 解析失败。本文针对这三类高频报错,梳理其背后的技术成因,提供标准化排查顺序、可直接复用的修复代码,以及防御性编程策略。
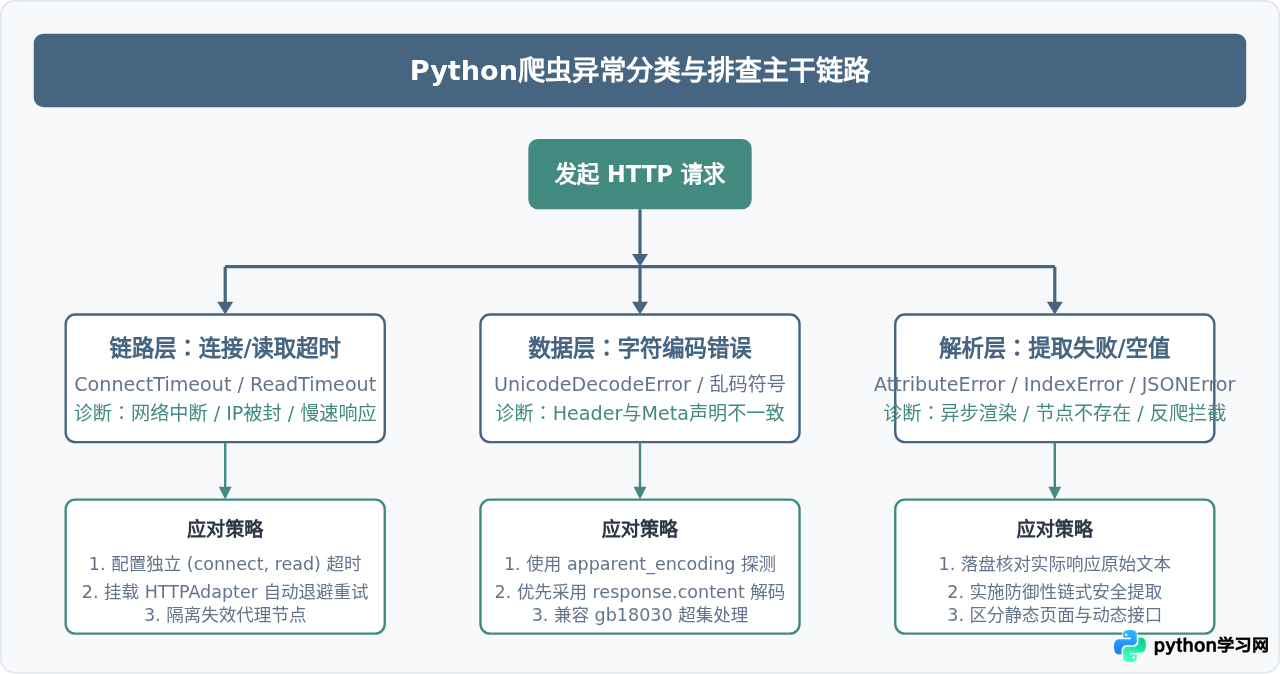
一、编码错误(UnicodeDecodeError 与页面乱码)排查与修复
编码问题在爬取中文网站时极为常见,通常表现为两种形式:一是在调用 response.text 或执行手动解码时直接抛出 UnicodeDecodeError: 'utf-8' codec can't decode byte... 异常;二是程序不报错,但打印或写入文件的中文全部变成形如 Ã¥...、开 或问号等乱码符号。
1. 报错根因分析
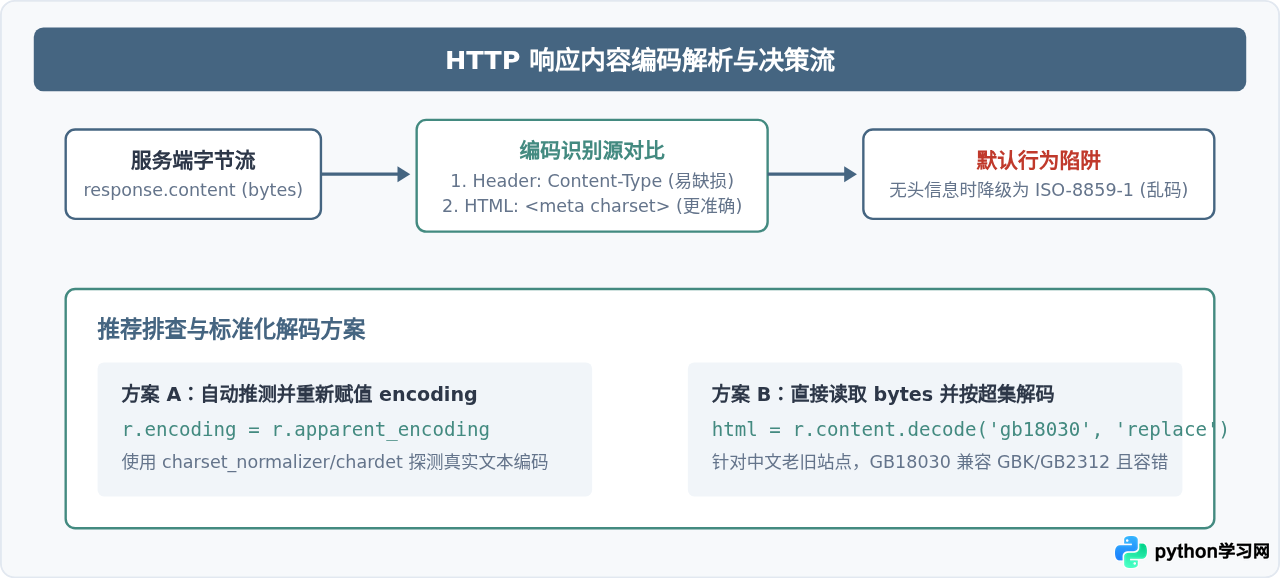
网络传输本质上始终是二进制字节流(bytes)。Python 的 requests 库在访问 response.text 属性时,会自动将字节流解码为 Unicode 字符串。其推断逻辑如下:
- 优先读取 HTTP 响应头中的
Content-Type字段(例如text/html; charset=UTF-8)。 - 如果 HTTP 响应头中完全没有标明
charset,根据 HTTP/1.1 标准规范(RFC 2616),requests会将编码降级默认为ISO-8859-1(西欧字符集)。此时,包含中文的 UTF-8 或 GBK 字节流被当成单字节的拉丁字符解码,直接产生类似å¼å的乱码。 - 部分老旧中文系统或政府、教育类网站,网页源码采用
GB2312或GBK编码,但服务端在 HTTP 响应头中错误声明为UTF-8,此时按 UTF-8 规则解码必然触发UnicodeDecodeError。
2. 具体排查与解决步骤
- 打印响应编码信息:先不要盲目调用
response.text,打印当前推断值与自动推测值:import requests r = requests.get("https://example.com/data") print("当前默认推断编码:", r.encoding) print("自动算法推测编码:", r.apparent_encoding) - 应用自动纠偏:若
r.encoding值为ISO-8859-1,直接执行r.encoding = r.apparent_encoding,然后再获取r.text。 - 处理疑难生僻字与繁简混排:对于明确是中文 GB 系列编码的页面,推荐优先使用
GB18030替代GB2312或GBK,因为GB18030包含了前两者的全部字符集以及生僻汉字与少数民族文字。 - 防御性解码:在无法确定远端编码且必须提取主体文本时,通过
response.content明确指定解码参数:# 优先尝试 UTF-8,遇错时降级至 GB18030 try: html_text = r.content.decode('utf-8') except UnicodeDecodeError: html_text = r.content.decode('gb18030', errors='replace')
二、网络连接超时(ConnectTimeout 与 ReadTimeout)排查与加固
网络请求超时是爬虫运行过程中最容易受外界环境影响的异常。未合理配置超时的爬虫进程,极易因为服务端假死或防火墙静默丢包而在单一请求上无休止挂起,导致整个任务卡死。
1. 报错根因分析
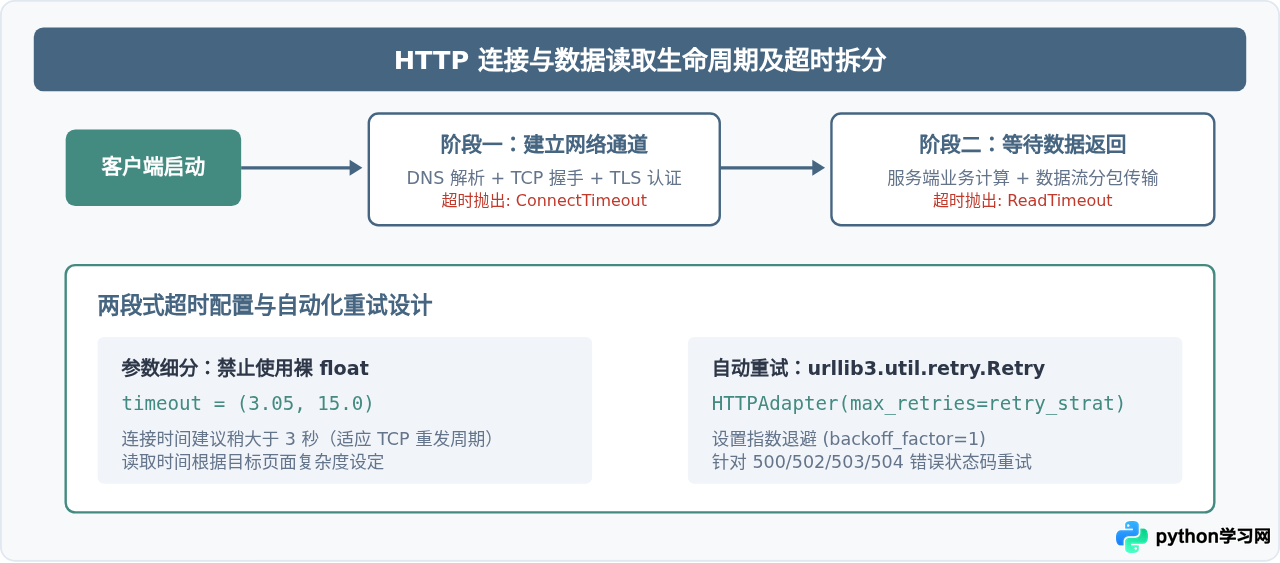
在网络 I/O 层面,超时分为两个截然不同的阶段:
- 连接超时(Connect Timeout):客户端尝试与目标服务器建立 TCP 三次握手或进行 TLS/SSL 握手的时间。若超出设定阈值,抛出
requests.exceptions.ConnectTimeout。通常由目标服务器关机、目标 IP 无法路由、网络防火墙拦截或代理服务器宕机引起。 - 读取超时(Read Timeout):客户端与服务端已经成功建立 TCP 连接,客户端发出了 HTTP 请求报文,但在等待服务器回传数据的过程中等待过久。若超出设定阈值,抛出
requests.exceptions.ReadTimeout。通常由服务器后端计算负载过高、数据库慢查询、响应数据体积巨大,或者服务器识别出爬虫后故意挂起长连接(Slowloris/防爬减速策略)引起。
2. 具体排查与解决步骤
- 明确细分超时时间:绝不在生产代码中使用无参的
requests.get(url),也不建议仅传递单个数字timeout=10。应使用元组明确拆分连接与读取阈值:# (连接超时秒数, 读取超时秒数) # 连接超时设为略大于 3 的数值(例如 3.05),匹配 TCP 数据包重传周期 response = requests.get(url, timeout=(3.05, 10)) - 配置 Session 级自动退避重试:遇到短暂抖动时直接抛错会导致任务中断,通过
HTTPAdapter配合Retry实现自动重发:import requests from requests.adapters import HTTPAdapter from urllib3.util.retry import Retry session = requests.Session() # 配置重试规则:重试3次,退避系数为1(等待1s, 2s, 4s),对特定状态码重试 retry_strategy = Retry( total=3, backoff_factor=1, status_forcelist=[429, 500, 502, 503, 504], allowed_methods=["HEAD", "GET", "OPTIONS"] ) adapter = HTTPAdapter(max_retries=retry_strategy) session.mount("https://", adapter) session.mount("http://", adapter) - 排查代理与 DNS 瓶颈:若在配置了代理 IP 池后频繁出现
ConnectTimeout,应在捕获异常后将当前代理标记为异常并立即剔除,切换下一个节点重新请求。
三、数据解析失败(AttributeError、IndexError 与 JSON 错误)
网络请求成功返回(HTTP 状态码为 200)并不代表数据就能顺利提取。开发者常遇到类似 'NoneType' object has no attribute 'get_text'、list index out of range 或 json.decoder.JSONDecodeError 等报错。
1. 报错根因分析
- 提取了反爬壳页面:服务端虽然返回 200 状态码,但由于请求头中缺少必要的
User-Agent、Referer或Cookie,返回的是人机验证滑块页、账号登录页或 521 防火墙拦截 JS 脚本。目标内容节点根本不存在于 DOM 中。 - 动态前端渲染(SPA/Ajax):现代网页大量使用 Vue、React 等前端框架,初始 HTML 源码中仅包含基础骨架与 JS 脚本,真实数据是通过后续的 Ajax/Fetch 请求异步拉取的。使用 requests 抓取的静态源码中没有目标标签。
- DOM 结构自动修正差异:在 Chrome 开发者工具的 Elements 面板中看到的 DOM 树是由浏览器解析修正后的结构(例如浏览器常会自动向
<table>下注入<tbody>)。如果直接在BeautifulSoup或XPath中照搬 DevTools 复制的//table/tbody/tr选择器,由于原始 HTML 源码中没有tbody标签,解析就会返回空列表。
2. 具体排查与解决步骤
- 打印或落盘原始响应源码:发生解析失败时,第一步不是反复改选择器,而是检查 requests 到底拿到了什么:
打开该文件搜索关键内容文本。如果文件中不存在目标文本,说明遇到动态渲染或拦截页面,需转去 Network 面板分析 XHR/Fetch 接口,或改用自动化浏览器。with open("debug_response.html", "w", encoding="utf-8") as f: f.write(response.text) - 防御性提取代码模式:禁止编写强依赖链路的脆弱代码(例如
soup.find('div', class_='box').find('p').text)。使用安全链式访问:# 脆弱写法(极易引发 AttributeError: 'NoneType' object has no attribute...) # title = soup.find('div', class_='article').find('h1').get_text() # 防御性写法 article_node = soup.find('div', class_='article') if article_node: h1_node = article_node.find('h1') title = h1_node.get_text(strip=True) if h1_node else "默认标题" else: title = "默认标题" - 安全解析 JSON 接口:针对 API 接口,先验证响应内容类型再调用
.json():if "application/json" in response.headers.get("Content-Type", ""): try: data = response.json() except ValueError: data = {} else: print("返回内容并非有效 JSON,可能被重定向拦截")
四、高健壮性爬虫请求模板
结合上述排查逻辑,在日常开发中应建立统一的基础请求封装模块,将编码自动探测、分段超时、重试与异常隔离整合为一个高健壮性的执行单元:
import logging
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

class RobustScraper:
    def __init__(self):
        self.session = requests.Session()
        self.session.headers.update({
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
            "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
            "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
        })

        # 挂载重试机制
        retries = Retry(
            total=3,
            backoff_factor=1,
            status_forcelist=[429, 500, 502, 503, 504],
            allowed_methods=["GET"]
        )
        adapter = HTTPAdapter(max_retries=retries)
        self.session.mount("https://", adapter)
        self.session.mount("http://", adapter)

    def fetch_page(self, url: str) -> str:
        try:
            # 连接超时 3.05 秒,读取超时 10 秒
            resp = self.session.get(url, timeout=(3.05, 10))
            resp.raise_for_status()

            # 编码纠正逻辑:当推断编码为默认拉丁字符集时,切换为自动算法识别值
            if resp.encoding.lower() == "iso-8859-1" or not resp.encoding:
                resp.encoding = resp.apparent_encoding

            return resp.text

        except requests.exceptions.ConnectTimeout:
            logging.error("连接超时: 目标服务器连接握手失败,检查网络连通性或代理配置")
        except requests.exceptions.ReadTimeout:
            logging.error("读取超时: 服务器响应延迟过长,尝试调大读取超时限制")
        except requests.exceptions.HTTPError as err:
            logging.error("HTTP状态异常: 状态码 %s", err.response.status_code)
        except requests.exceptions.RequestException as err:
            logging.error("网络请求基础异常: %s", err)

        return ""
五、常见报错排查速查矩阵
针对开发过程中出现的各类异常现象,下表提供了一目了然的排查路径对照:
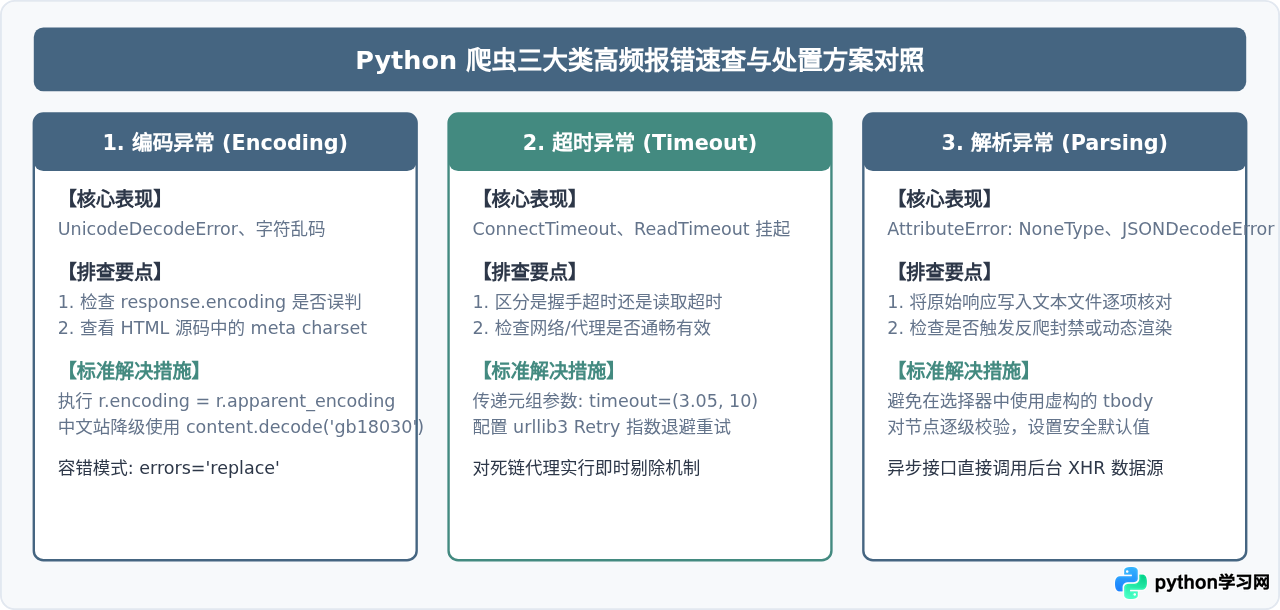
在面对爬虫故障时,最核心的原则是“隔离网络传输与数据提取”。当出现任何解析或内容异常时,先将 response.content 原始字节流与 response.status_code 保存下来。先确认拿到的内容确实是目标网页而非拦截验证码,再处理编码转换,最后执行 DOM 提取,即可快速切断绝大多数报错的产生路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









