

Python自定义模块怎么导入:同目录与子包的引用方法

在 Python 开发中,自定义模块与包的导入核心依托于解释器的模块检索路径列表 sys.path。同目录下的自定义模块由于当前运行脚本所在目录默认位于 sys.path[0],可以直接使用模块名进行引用;位于子目录中的模块则需要组织为包含 __init__.py 的标准包结构,并通过点号层级表示法使用绝对导入或包内相对导入。理解这两种场景的寻址差异,是构建规范工程结构与避免常见模块未找到报错的基础。
一、同目录自定义模块的引用方法与寻址机制
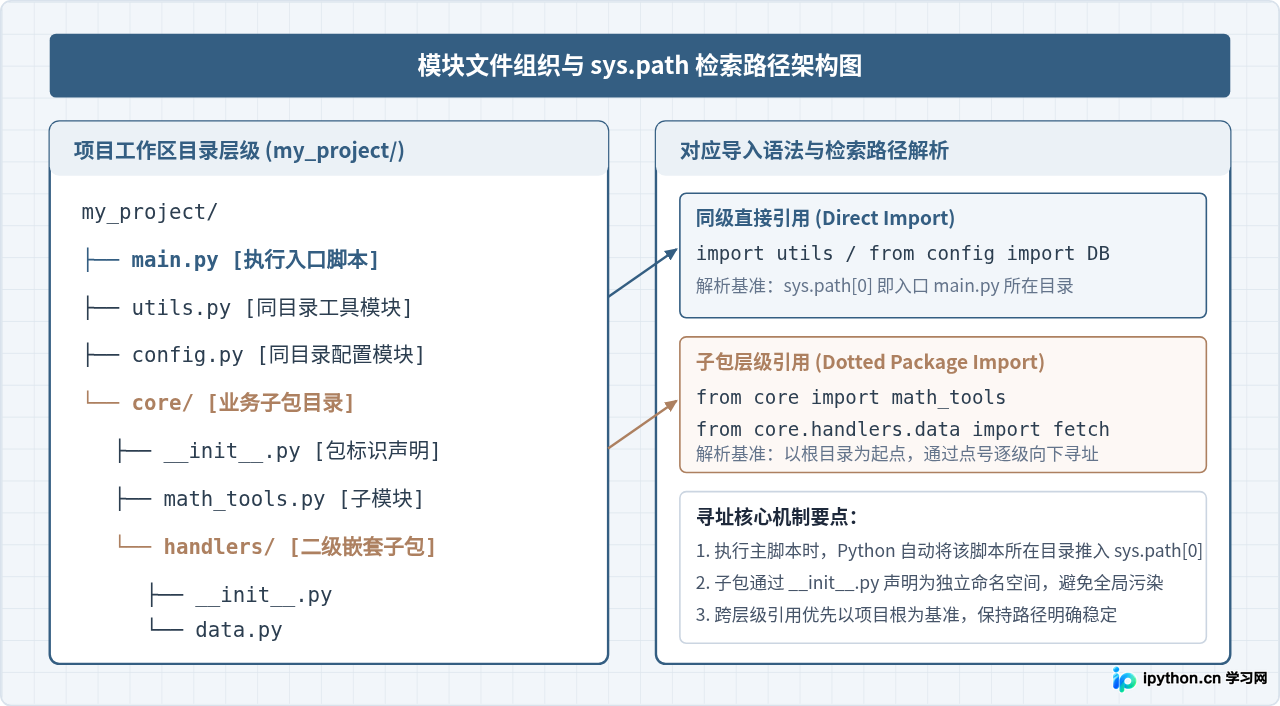
当多个 Python 脚本位于同一个项目文件夹时,模块之间的调用属于同级引用。Python 在导入模块时,会依次检索内置模块、当前工作目录以及第三方扩展库所在路径。
假设项目根目录下存在两个文件:作为执行入口的 main.py 与封装工具函数的 utils.py,其结构如下:
my_project/
├── main.py
└── utils.py
在 utils.py 中定义待调用的数据处理函数:
# utils.py
def format_user_name(name):
    return name.strip().title()

DATABASE_TIMEOUT = 30
在同目录的 main.py 中,存在两种规范的引用方式:
# main.py
# 方式一:导入整个模块,通过模块命名空间调用
import utils

# 方式二:精确导入模块内的指定函数或常量
from utils import format_user_name, DATABASE_TIMEOUT

if __name__ == "__main__":
    clean_name = utils.format_user_name("  alice  ")
    print("方式一调用结果:", clean_name)

    direct_name = format_user_name("  bob  ")
    print("方式二调用结果:", direct_name)
    print("超时配置:", DATABASE_TIMEOUT)
这两种方式均能正常解析,其底层原因是 Python 启动执行 python main.py 时,会自动将启动脚本所在的绝对路径插入至 sys.path 列表的首位(索引为 0)。解释器检索模块时会优先在该目录下扫描匹配的 .py 文件。
避坑提示:同目录模块命名绝不能与 Python 标准库同名。例如,若将本地自定义脚本命名为 math.py、random.py 或 json.py,同级脚本执行 import math 时将直接拦截系统标准库,导致原生方法不可用并抛出 AttributeError。
二、子包结构划分与绝对导入语法
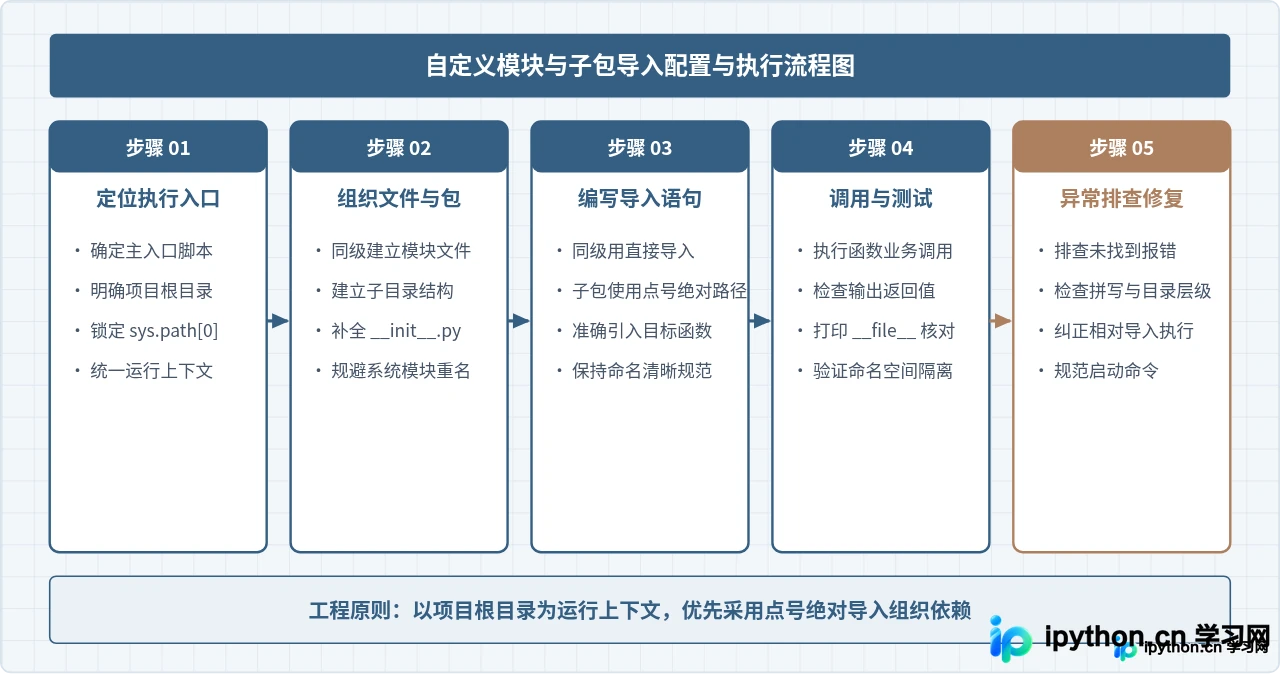
随着工程规模扩展,所有脚本平铺在根目录会导致结构混乱。此时需要将关联功能放入子文件夹中建立“包(Package)”。
1. 包与 __init__.py 的作用
在 Python 中,普通文件夹若要被视作可导入的包,通常需要在该文件夹下放置一个 __init__.py 文件。该文件具有以下工程意义:
- 标识作用:向解释器明确声明当前目录为一个 Python 包,允许使用点号(
.)进行层级导入。 - 初始化逻辑:包被初次导入时,其内部的
__init__.py会被自动执行,可在此处定义包级别的初始化变量。 - 对外导出封装:可在
__init__.py中定义__all__列表,或提前引入子模块对象,方便外部直接调用包名。
2. 多级子包的绝对导入示例
考虑以下具备二级子包的项目层级结构:
my_project/
├── main.py
└── core/
    ├── __init__.py
    ├── math_tools.py
    └── handlers/
        ├── __init__.py
        └── data.py
在子包模块 core/math_tools.py 中编写数学工具函数:
# core/math_tools.py
def add(a, b):
    return a + b
在深层子包模块 core/handlers/data.py 中编写数据提取逻辑:
# core/handlers/data.py
def fetch_records():
    return [{"id": 1, "score": 95}, {"id": 2, "score": 88}]
在入口脚本 main.py 中引用这些子包模块时,采用从项目根包向下的绝对导入(Absolute Import):
# main.py
# 导入一级子包内的模块
from core import math_tools

# 导入二级子包内的具体函数
from core.handlers.data import fetch_records

if __name__ == "__main__":
    total = math_tools.add(10, 20)
    print("求和计算:", total)

    records = fetch_records()
    print("记录数量:", len(records))
通过点号语法 from core.handlers.data import ...,Python 沿 sys.path[0] 下的 core 目录向下逐级定位,依次确认每级目录中的 __init__.py 并加载对应目标,完成命名空间绑定。
三、包内相对导入(Relative Import)的用法与运行约束
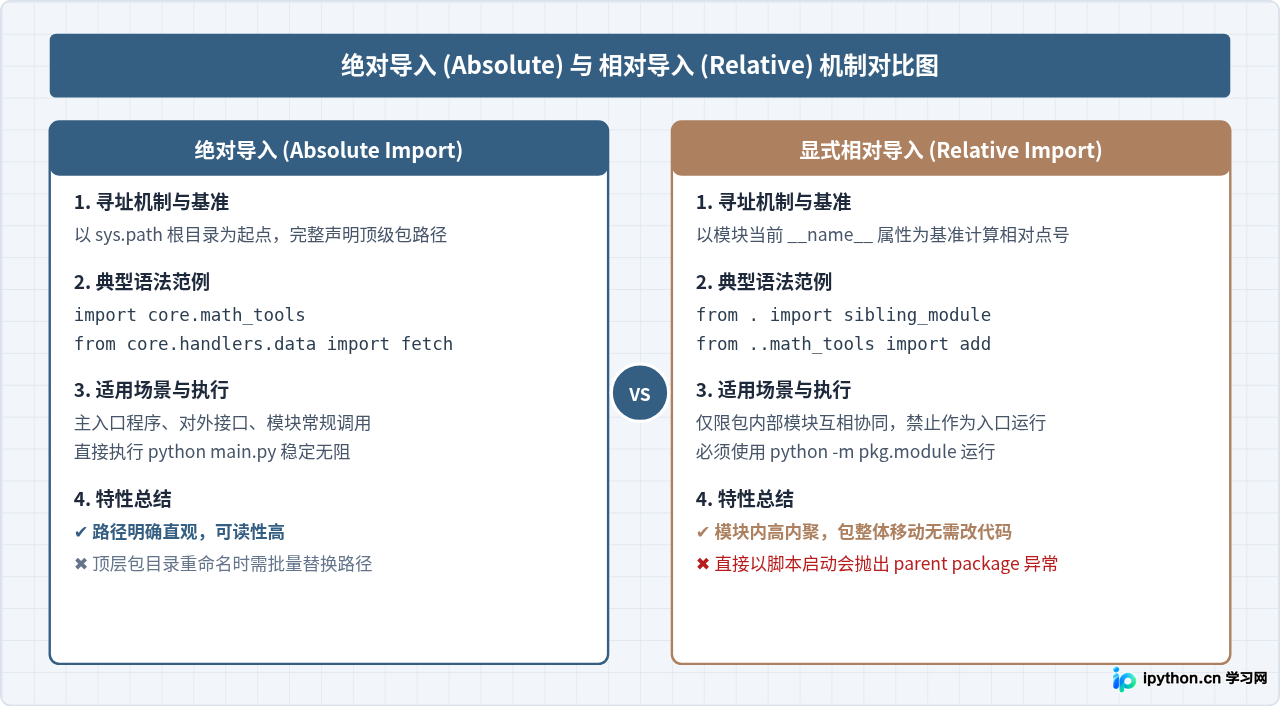
当包内部存在大量复杂的子模块,且这些模块之间需要互相调用时,使用完整的绝对路径可能导致顶层包名频繁硬编码。此时可以使用以点号开头的显式相对导入。
1. 相对导入的语法格式
相对导入使用前置点号表示层级距离:
.表示当前模块所在的包目录。..表示当前模块所在包的上一级父包。...表示上上级目录,依此类推。
在 core/handlers/data.py 中需要调用上级包 core/math_tools.py 中的计算函数:
# core/handlers/data.py
# 相对导入:.. 表示回到 core 包,进而导入同在 core 下的 math_tools
from ..math_tools import add

def summarize_scores(scores):
    total = 0
    for s in scores:
        total = add(total, s)
    return total
2. 相对导入的核心约束与常见异常
许多开发者在编写相对导入后,尝试直接在命令行运行该文件:
python core/handlers/data.py此时程序会立即崩溃,并抛出经典报错:
ImportError: attempted relative import with no known parent package报错原因:直接使用 python 路径/文件.py 运行脚本时,Python 解释器会将该运行脚本的 __name__ 变量强制设置为 '__main__'。相对导入依赖 __name__ 属性中的点号层级来计算父包位置(例如 core.handlers.data),一旦 __name__ 变为 '__main__',模块就失去了父包上下文信息,导致无法向上解析。
正确运行方式:必须在包含顶层包的项目根目录下,使用 -m 参数将模块作为模块执行:
# 在 my_project/ 根目录下执行
python -m core.handlers.data
使用 -m 标志执行时,解释器保留了完整的包层级命名空间,相对导入即可正常解析。
四、常见报错排查与工程实践规范
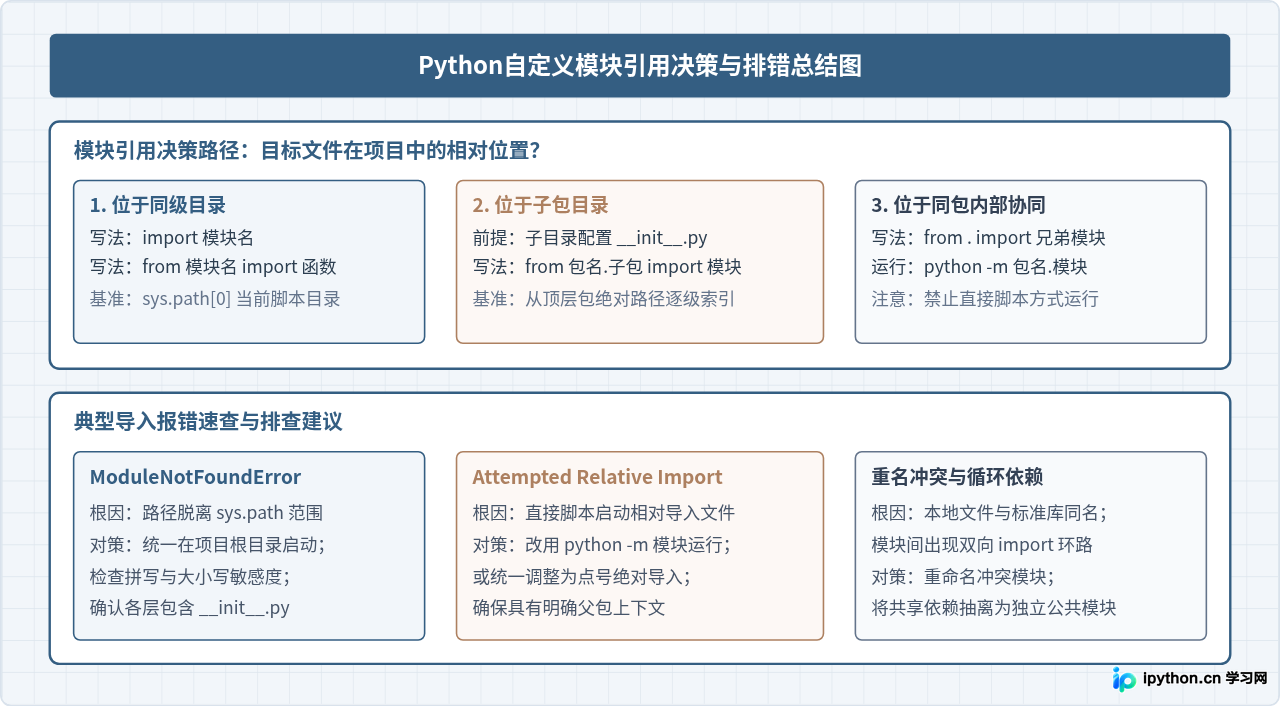
在实际开发与运维中,导入相关的故障多数由环境路径混乱、执行入口偏差或循环依赖引起。遇到问题时,可按以下指引排查。
1. ModuleNotFoundError: No module named '...'
这是最常见的报错,表明 Python 在检索完所有 sys.path 目录后依然未发现目标模块。
- 排查路径:在报错脚本的导入语句之前打印
sys.path进行观测:import sys print("当前检索路径:", sys.path) - 原因与对策:检查输出的第一项目录是否是项目根目录。如果开发者在终端中
cd core/进入了子目录并执行python main.py,工作目录改变会导致根目录脱离检索范围。规范做法是始终在项目根目录下执行指令。
2. 避免动态修改 sys.path.append('..')
有些脚本为了临时导入上级目录模块,采用以下写法:
# 不推荐的临时做法
import sys
sys.path.append("..")
import config这种做法依赖相对路径,若在不同的工作目录启动,".." 会解析为不可预测的物理路径,破坏代码的可移植性与单元测试环境。应当将根目录配置为标准的顶层包,并通过模块方式启动。
3. 循环导入(Circular Import)问题
当模块 a.py 中写了 import b,而 b.py 中同时写了 import a 时,极易抛出 ImportError: cannot import name ... 或 AttributeError。
- 修复方案:将两者的共有数据模型或通用函数抽离到独立的第三个基础模块
common.py中,由a和b单向引用common;或者将部分仅在局部方法中使用的导入语句放入函数内部进行延迟导入。
五、工程实践总结
掌握 Python 自定义模块与子包导入的核心原则可以概括为三点:
- 同目录模块简单直接:同级调用充分利用
sys.path[0]特性,但需严格避免命名与标准库冲突。 - 跨目录子包优先绝对导入:通过为子目录配置
__init__.py建立包边界,以项目根目录为基准使用点号绝对路径导入,能够提供最清晰的调用关系。 - 统一项目执行根环境:无论运行入口脚本还是测试子模块,始终以工程根目录作为工作区启动,必要时借助
python -m执行包内模块,避免使用不可预测的路径拼接。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









