

Python隐式命名空间包详解:3.3版本后为何不再强制需要__init__.py
深入解析Python 3.3通过PEP 420引入的隐式命名空间包(Implicit Namespace Packages)机制,探讨为何不再强制要求__init__.py,对比常规包与命名空间包的底层差异,并提供工程拆分与打包的完整实践指南。
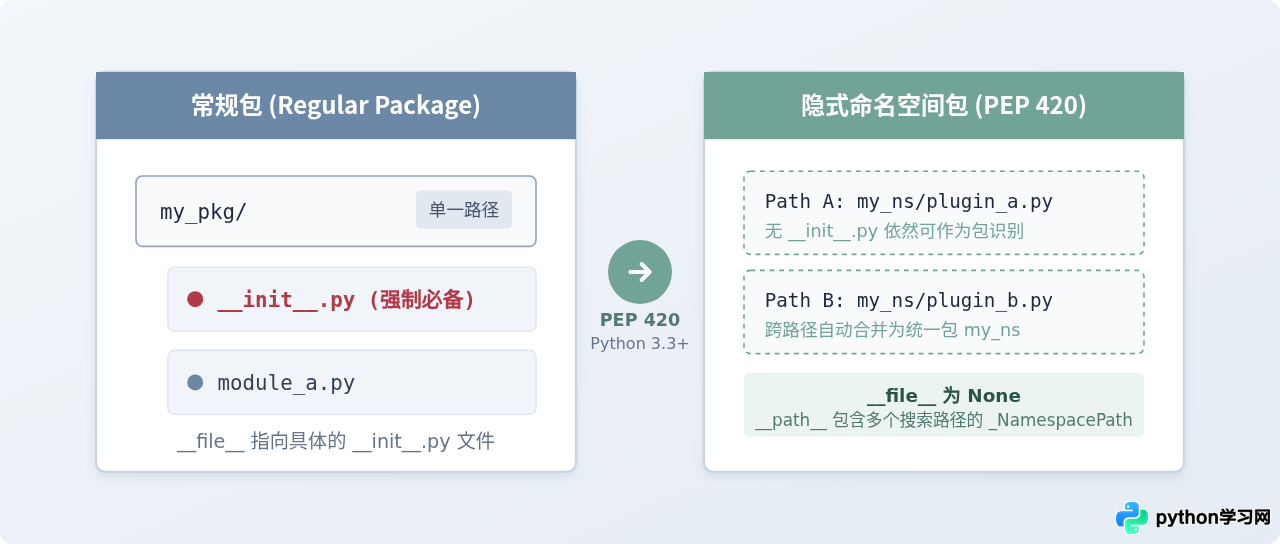
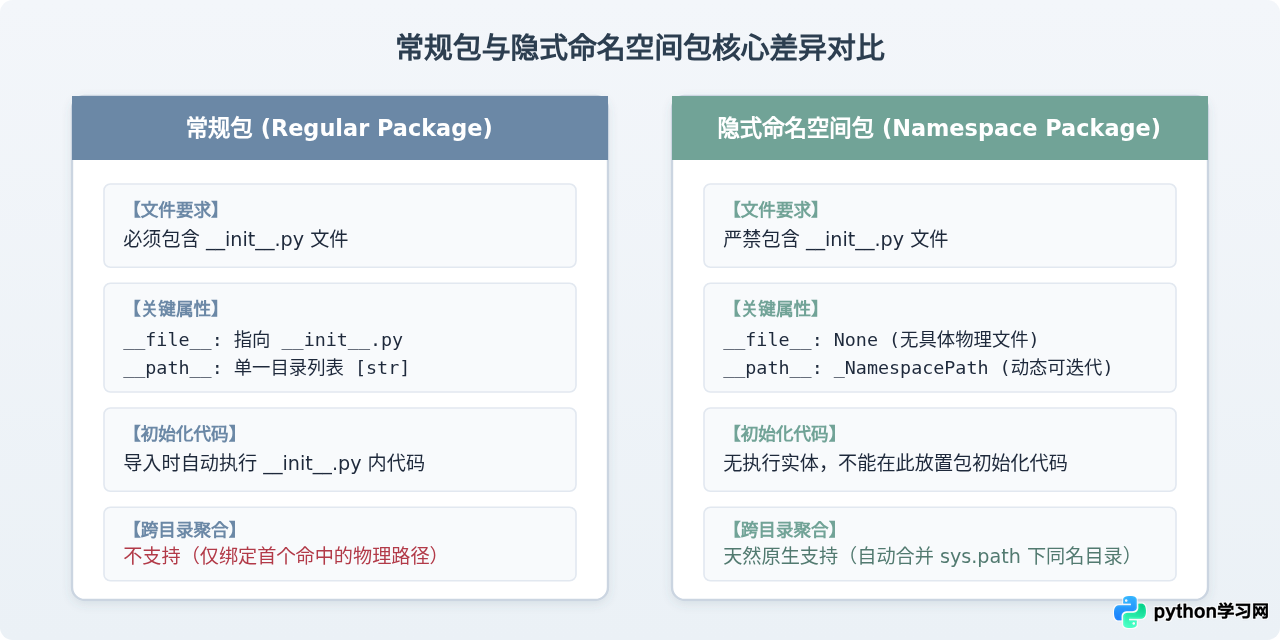
在 Python 3.3 之前,任何包含 Python 代码的文件夹若想被作为“包”(Package)导入,其根目录下必须存在一个 __init__.py 文件。从 Python 3.3 开始,官方通过 PEP 420 正式引入了“隐式命名空间包”(Implicit Namespace Packages)机制。这一改动的核心目的是支持将同一个顶级命名空间下的多个子模块分散存放在不同的物理目录、代码仓库或第三方分发包中,使得大型项目与插件生态无需借助黑魔法或共享单一初始化脚本即可实现模块汇聚与跨路径合并。
一、为什么过去必须要有 __init__.py?
在 Python 2.x 和早期的 Python 3.x 中,解释器为了明确区分“普通的操作系统文件夹”与“可导入的代码包”,制定了一条硬性规则:只有包含 __init__.py 的目录才会被识别为 Python 包。
这种设计的初衷主要基于以下三点实际考量:
- 避免意外导入同名文件夹:在大型开发环境中,项目根目录可能包含名为
tests/、build/、data/、docs/或string/的普通文件夹。如果不需要任何标记就将目录视为模块,一旦sys.path包含当前目录,就可能遮蔽标准库模块或发生意外的导入冲突。 - 提供包级初始化入口:当用户执行
import my_package时,Python 需要一个具体的代码载体来执行初始化逻辑、设置__all__导出列表,或在顶层导出核心类与函数。__init__.py正是这个模块代码的载体。 - 确定单一实体边界:在传统规则下,一个包对应文件系统中某个特定父路径下的单一文件夹,该包的
__file__属性直接指向该目录下的__init__.py文件。
二、传统规则带来的痛点与命名空间拆分需求
随着 Python 生态向大型单体仓库、微服务以及庞大插件系统演进,单一目录包的限制暴露出了严重的工程瓶颈。最典型的场景就是命名空间拆分(Namespace Splitting)。
以知名的云服务 SDK 或企业公共库为例,假设一个企业拥有多个业务组件,希望统一对外呈现为 company.* 命名空间:
- 团队 A 负责开发维护身份认证组件:
company.auth - 团队 B 负责开发维护数据库连接组件:
company.database - 团队 C 负责开发维护消息队列组件:
company.messaging
如果使用传统常规包,按照规定 company/ 目录下必须放一个 __init__.py。这就导致了冲突:每个团队发布独立的 Wheel 安装包时,都会包含一个 company/__init__.py。当用户同时通过 pip 安装这三个包时,不同安装包的 company/__init__.py 会发生相互覆盖;更严重的是,在分布式开发或非集中式部署场景中,如果这些库安装在不同的 site-packages 或 sys.path 路径下,Python 导入 company 时只会锁定它遇到的第一个目录,导致其他路径下的子包完全不可见。
在 PEP 420 出现前,社区通过 pkgutil.extend_path() 或 setuptools 的 pkg_resources.declare_namespace(__name__) 来手动拼接 __path__。这种方式要求每个分发包的 __init__.py 都必须写死特定样板代码,只要有一个第三方包少写或写错,整个命名空间查找链就会立即断裂,维护成本极高。
三、PEP 420 的运作机制:Python 解释器如何查找模块
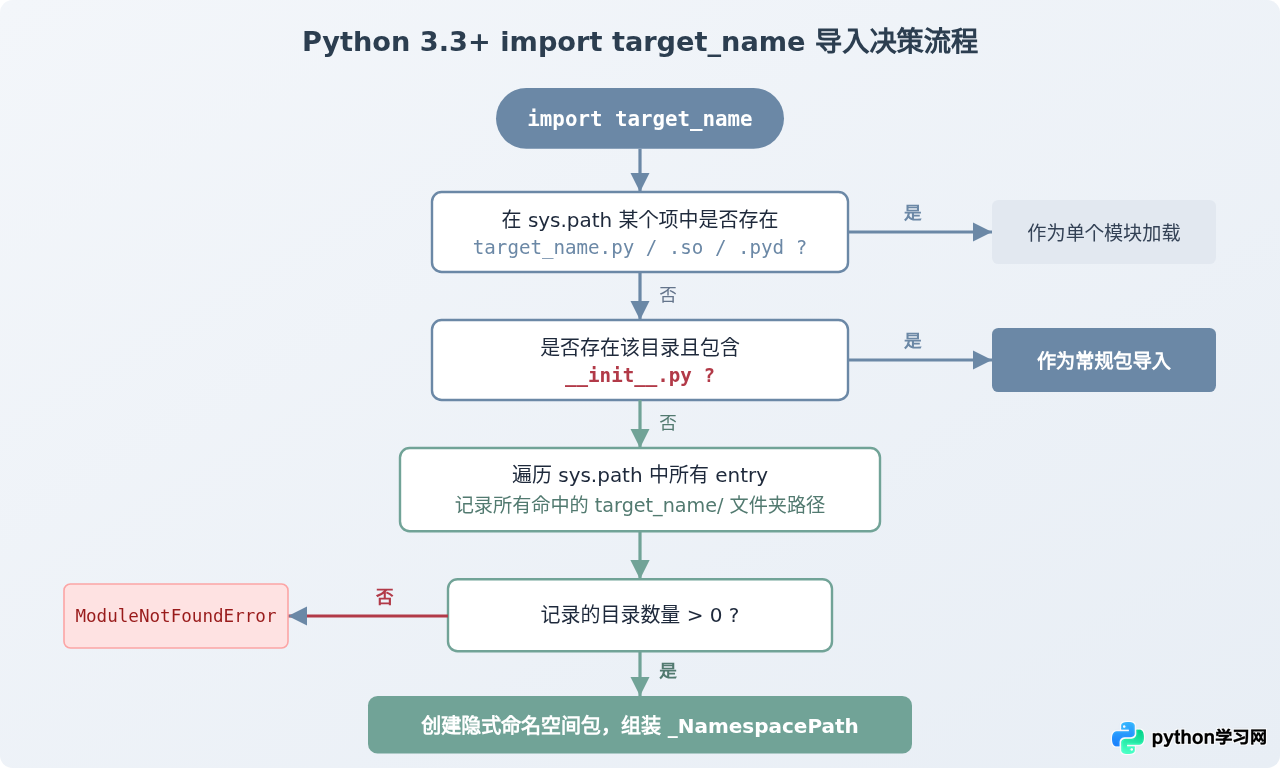
为了让目录在没有 __init__.py 的情况下依然能作为包被导入,Python 3.3 重构了 sys.meta_path 中的模块查找器(主要是 PathFinder)。
当执行 import foo 时,解释器按照严格的优先级在 sys.path 包含的各个目录中进行扫描:
- 步骤一(优先匹配单模块):检查是否存在编译模块或独立文件,如
foo.py、foo.pyc或 C 扩展模块foo.so/foo.pyd。一旦找到立即加载并终止后续查找。 - 步骤二(优先匹配常规包):检查目录
foo/下是否存在__init__.py(或编译后的__init__.pyc)。如果存在,判定为常规包,执行初始化脚本并绑定该单一目录,立即终止查找。 - 步骤三(回退构建命名空间包):如果遍历完
sys.path的某个目录时,没有发现foo.py也没有发现带有__init__.py的foo/文件夹,但确实存在一个普通的foo/文件夹,查找器不会立刻终止,而是将这个文件夹的路径记录下来,并继续遍历sys.path的剩余项。 - 步骤四(聚合
_NamespacePath):当sys.path全部遍历完成后,若记录到一个或多个名为foo/的文件夹,解释器便会合成一个虚拟模块对象。该模块的__file__为None,其__path__是一个包含所有被记录文件夹路径的只读_NamespacePath实例。
四、代码实测:命名空间包在 Python 交互环境下的具体行为
为了直观观察隐式命名空间包的运行机制,我们可以构造一个包含两个物理路径但共享同一顶级名称的实验目录:
# 示例物理目录结构
/workspace/
├── repo_auth/
│   └── acme/
│       └── auth.py        # 内容:def get_user(): return "alice"
└── repo_billing/
    └── acme/
        └── billing.py     # 内容:def get_balance(): return 100.0
注意上述目录中的 acme/ 文件夹下均没有 __init__.py 文件。进入 Python 交互式命令行,通过 sys.path 模拟多个包安装路径共存的环境:
# 示例交互式命令与执行输出
>>> import sys
>>> sys.path.extend(['/workspace/repo_auth', '/workspace/repo_billing'])

>>> import acme
>>> acme
<module 'acme' (namespace)>

>>> # 检查 __file__ 属性:隐式命名空间包没有实体文件
>>> print(acme.__file__)
None

>>> # 检查 __path__ 属性:动态包含所有扫描到的物理路径
>>> acme.__path__
_NamespacePath(['/workspace/repo_auth/acme', '/workspace/repo_billing/acme'])

>>> # 正常访问不同路径下的子模块
>>> from acme import auth, billing
>>> auth.get_user()
'alice'
>>> billing.get_balance()
100.0从控制台输出可以明确验证:acme 的模块表现形式为 (namespace),__file__ 为 None,而 __path__ 成功将两处不相连的物理目录动态合并进同一个命名空间中。
五、工程实践:多仓库拆分与独立打包发布
在微服务架构或多插件系统开发中,团队通常将不同的业务模块放在独立的 Git 仓库中维护,并单独构建发布为 Wheel 包。隐式命名空间包正是实现该架构的基础设施。
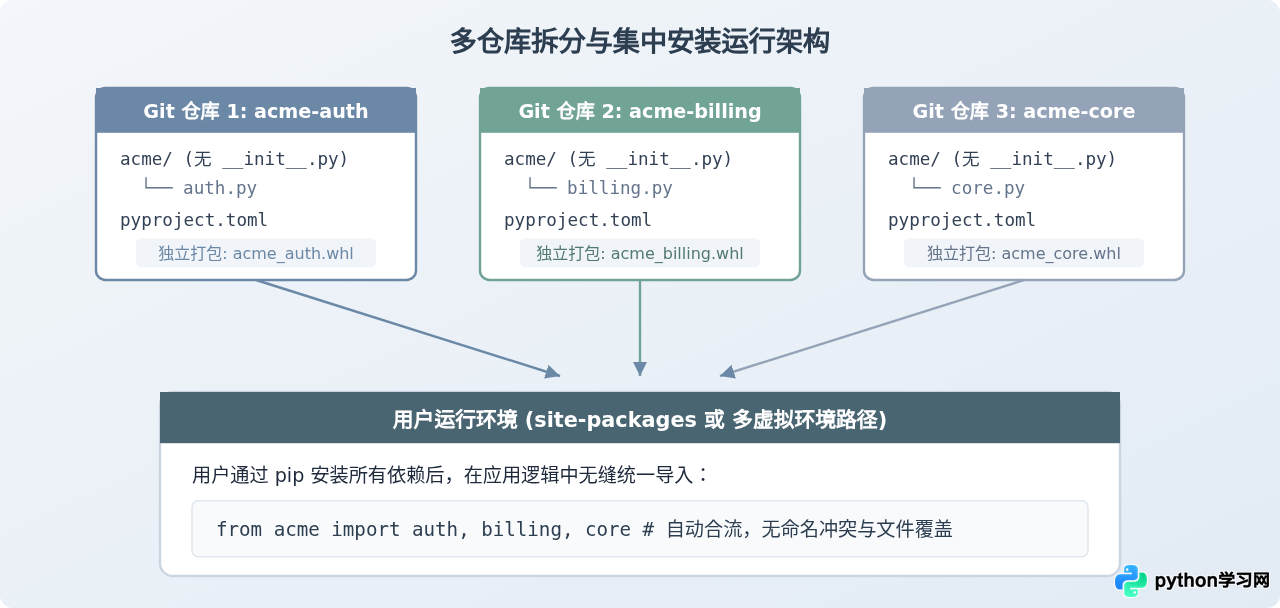
1. 打包工具的配置要求
当使用现代化打包工具(如 setuptools 或 flit)发布隐式命名空间包时,必须注意包扫描工具的选择:
- 使用现代 setuptools(
pyproject.toml):必须启用find_namespace:,因为默认的find:仅仅寻找带有__init__.py的目录。示例如下:
# pyproject.toml 示例配置
[build-system]
requires = ["setuptools>=61.0"]
build-backend = "setuptools.build_meta"

[project]
name = "acme-auth"
version = "1.0.0"
description = "Acme 身份认证子包"
dependencies = []

[tool.setuptools.packages.find]
where = ["."]
include = ["acme.auth*"]
namespaces = true  # 关键选项:允许包含命名空间包
六、注意事项与常见踩坑点
虽然隐式命名空间包带来了极大的灵活性,但在日常开发中仍需注意以下限制与边界条件:
- 误删
__init__.py导致相对导入失效:在同一个常规包内部,开发者经常使用from . import utils进行同级相对导入。若误将顶层目录或当前目录的__init__.py删除,该目录将退化为命名空间包,相对导入可能会报ImportError: attempted relative import with no known parent package错误。 - 无法在包顶层执行初始化:命名空间包没有实体文件,因此不能在顶层目录放置任何初始化逻辑(如设置日志等级、预先加载环境变量等)。如果业务需要初始化,应将其明确封装在具体子模块中(例如
from acme.auth import init_auth)。 - 测试发现与目录扫描工具遗漏:部分早期的自动化测试发现工具(或配置未更新的
pytest)、静态代码检查工具在递归查找测试用例时,仍依赖__init__.py来定位测试包。如果在测试目录下遗漏了__init__.py,可能导致某些测试用例无法被自动收集。 - 避免常规包与命名空间包命名混杂:如果同一个环境下的某一个路径包含了带有
__init__.py的acme/文件夹,Python 解释器在命中该路径后会将其判定为常规包,从而完全忽略后续其他路径下的acme/目录,导致其他仓库提供的子模块“离奇失踪”。
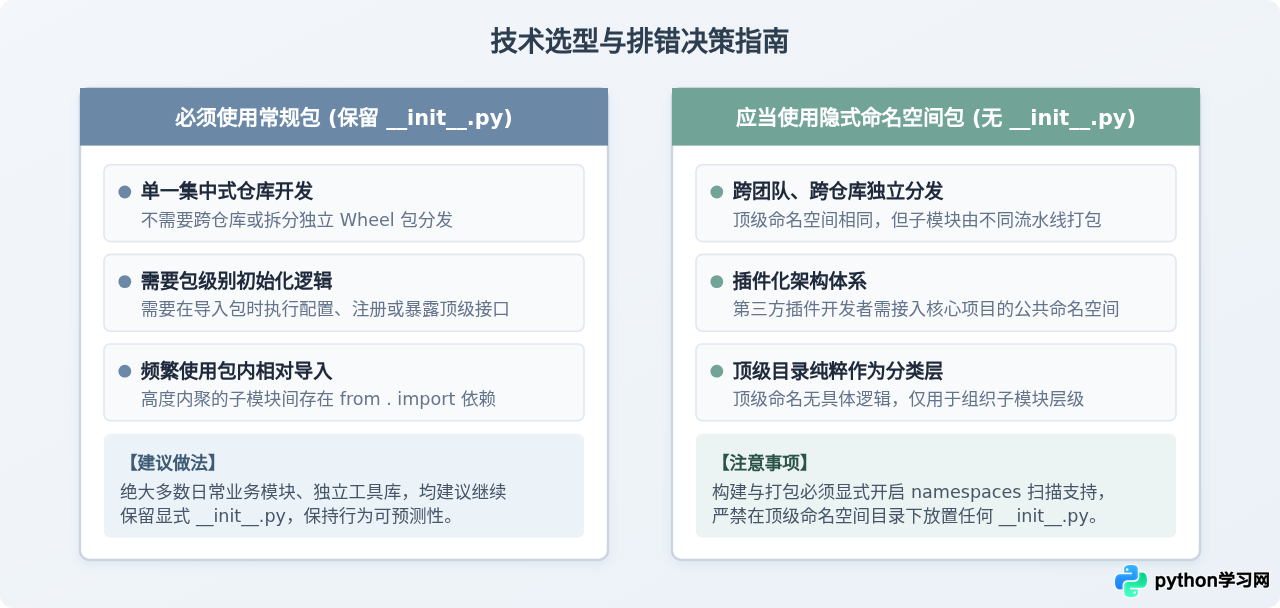
七、总结
Python 3.3 移除对 __init__.py 的强制依赖,并不是为了让开发者彻底抛弃 __init__.py,而是为了解决多仓库、多路径模块在同一顶级命名空间下无法平滑共存的历史难题。通过 PEP 420 规范,解释器在没有发现常规包与单一模块时,会自动收集所有路径下的对应目录并合成只读的 _NamespacePath,从而实现了原生、透明的命名空间多路径聚合。
在日常开发中,对于常规的业务项目与独立封装库,依然推荐保留 __init__.py 以明确包边界并方便执行包级初始化;而在涉及大型基础架构分拆、插件体系以及多包跨路径共用命名空间的场景中,隐式命名空间包则提供了干净、标准且免维护的官方解决方案。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









