

编写Python爬虫需遵守的法律规范与robots协议
深入讲解编写Python爬虫时必须遵守的法律红线与robots.txt协议规范。涵盖民事、行政、刑事三层法律责任,robots协议语法机制,Python标准库urllib.robotparser解析实战及安全合规工程建议。
一、爬虫技术的法律边界:三层风险红线解析
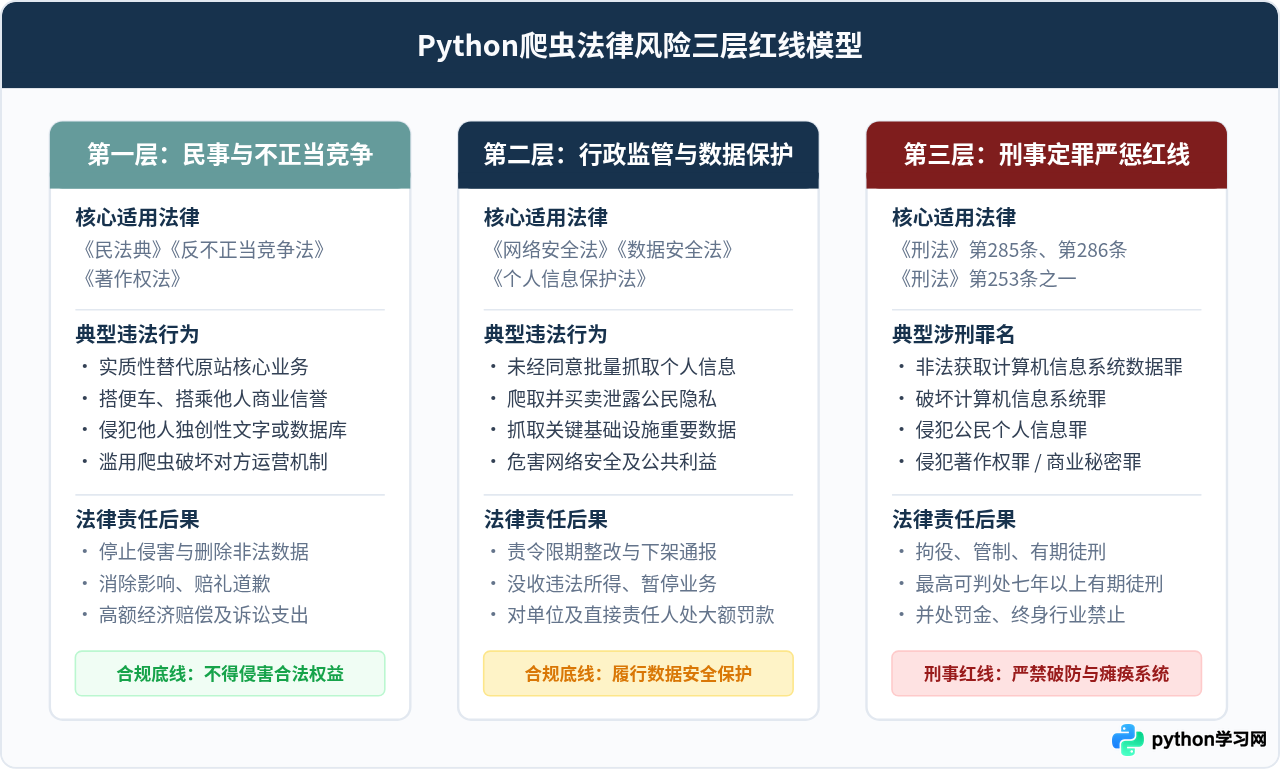
在我国当前的司法实践中,因网络爬虫引发的纠纷和案件已屡见不鲜。从法律层面审视,网络爬虫的不当开发和使用可能触发民事责任、行政违法甚至刑事严惩三重风险。理解这三层责任边界,是每一个爬虫开发者构筑合规防线的第一步。
1. 民事侵权与不正当竞争红线
民事维度的核心考量在于爬虫抓取是否违背商业道德、是否实质性替代原平台服务。《中华人民共和国反不正当竞争法》第二条规定了经营者在市场交易中应当遵循自愿、平等、公平、诚信的原则。如果爬虫运营者抓取他人网站的核心商业数据并直接打包用于商业营利,导致目标网站用户流失、流量下降,即便抓取的数据在前端完全公开,仍可能被司法机关认定为构成不正当竞争。
2. 行政监管与个人信息保护红线
《中华人民共和国个人信息保护法》(PIPL)与《网络安全法》对个人信息的处理设立了严格规则。个人信息包括以电子或者其他方式记录的能够单独或者与其他信息结合识别特定自然人的各种信息。网络爬虫在抓取过程中,如果大量批量抓取包含真实姓名、联系方式、住址、财务信息、社交关系等未脱敏数据,且未取得个人知情同意,即违反数据合规要求。主管部门可责令限期整改,并对企业及责任人处以高额罚款。
3. 刑事定罪严惩底线
爬虫技术一旦突破合法边界,极易触犯《中华人民共和国刑法》:
- 刑法第285条(非法获取计算机信息系统数据罪):针对目标网站设置的身份验证(如 Token、Cookie、验证码、接口加密算法等),开发者若使用暴力破解、撞库、脱壳逆向、打码平台绕过等技术手段强行获取后台数据,即被认定为侵入计算机信息系统。
- 刑法第286条(破坏计算机信息系统罪):若爬虫并发量过大,导致目标网站服务器 CPU 占满、带宽耗尽甚至系统崩溃服务中断,达到“后果严重”标准,即可能构成破坏计算机信息系统罪。
- 刑法第253条之一(侵犯公民个人信息罪):通过爬虫非法抓取、汇总并向他人出售或者提供公民个人信息,情节严重的将直接面临有期徒刑。
二、Robots 协议的核心规范与语法机制
Robots 协议全称为“网络爬虫排除标准”(Robots Exclusion Protocol),简称 robots.txt。它是网站管理者与网络爬虫之间进行沟通的标准约定。虽然 robots.txt 在国际法律层面常被视作行业惯例与“君子协定”,但在国内司法判定不正当竞争及刑事责任时,网站在 robots.txt 中明确声明的拒绝规则是判定爬虫运营者是否具有主观恶意的重要证据。
1. 存放位置与基本格式要求
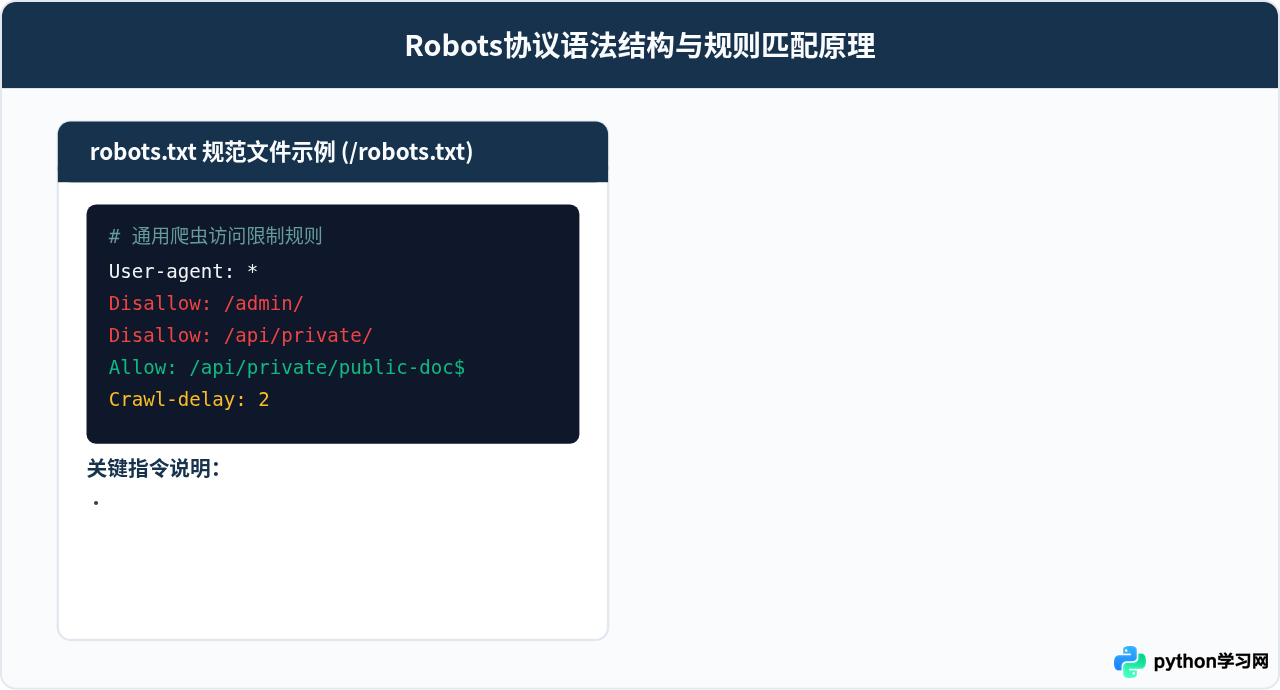
robots.txt 必须放置在网站的根目录下,并且文件名必须全部小写。例如网站地址为 https://example.com/,其对应的协议地址必须为 https://example.com/robots.txt。放置在子目录(如 https://example.com/blog/robots.txt)中的文件在标准协议中是不生效的。
2. 规则优先级与最长匹配原则
当一个 URL 同时满足 Allow 和 Disallow 指令时,现代爬虫(包括 Googlebot 及 Python 标准库)遵循最长前缀匹配优先原则。例如对于以下规则:
Disallow: /api/
Allow: /api/public-data
当请求 /api/public-data/list 时,Allow 规则匹配了 16 个字符,而 Disallow 仅匹配了 5 个字符,因此系统判定允许访问。如果两条规则匹配长度完全一致,则以更严格的 Disallow 为准。
三、在 Python 中规范解析与遵守 robots 协议
许多开发者在编写 Python 爬虫时直接使用 requests 或 httpx 获取目标网页,完全忽略了预先对 robots.txt 的读取与校验。实际上,Python 标准库中自带了轻量且强大的 urllib.robotparser 模块,无需安装任何第三方库即可轻松完成合规校验。
完整合规爬虫实现代码示例
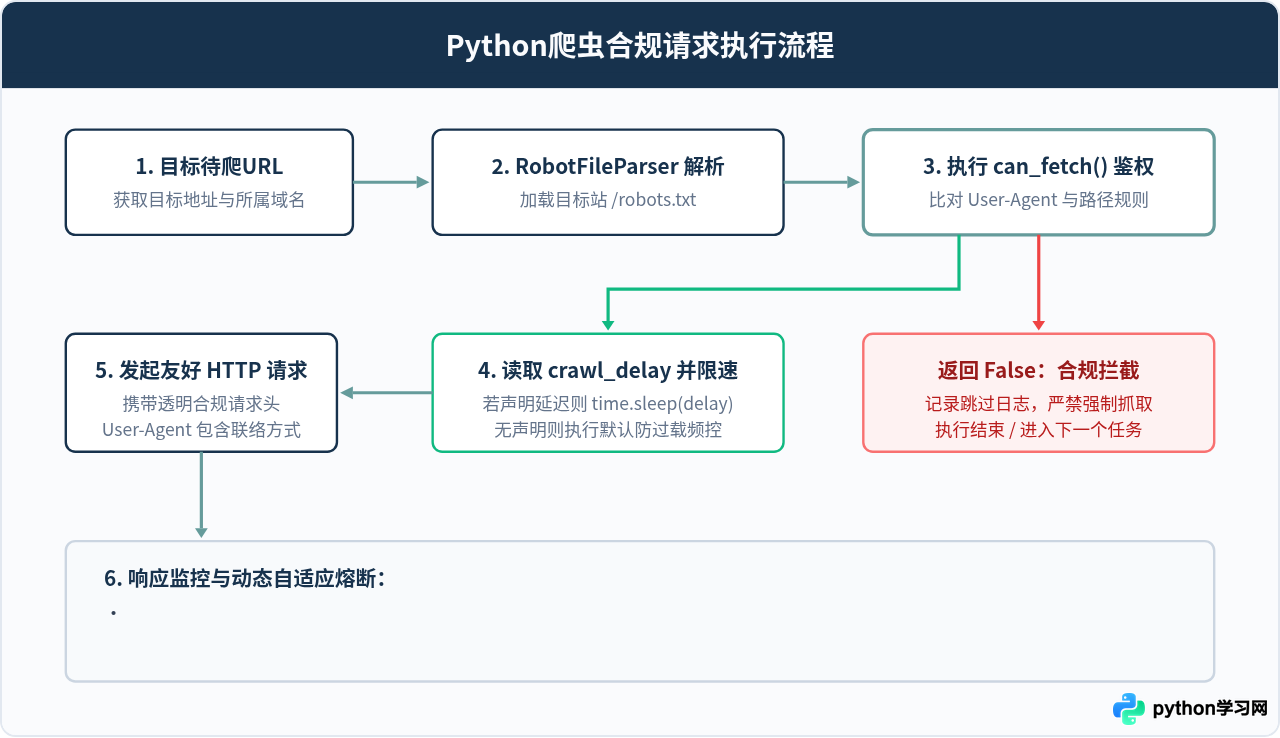
下面的 Python 代码演示了如何使用 urllib.robotparser.RobotFileParser 封装一个合规检查器,在发送任何网络请求前自动校验目标 URL 的抓取权限,并主动遵守对方指定的抓取延迟:
import time
import urllib.robotparser
from urllib.parse import urlparse
import requests

class CompliantCrawler:
    def __init__(self, bot_name: str, contact_email: str):
        self.bot_name = bot_name
        self.contact_email = contact_email
        # 声明透明规范的 User-Agent
        self.user_agent = f"{bot_name}/1.0 (+http://yourdomain.com/bot; {contact_email})"
        self.parsers = {}
        self.session = requests.Session()
        self.session.headers.update({"User-Agent": self.user_agent})

    def get_robot_parser(self, target_url: str):
        """解析并缓存目标站点的 robots.txt"""
        parsed = urlparse(target_url)
        base_url = f"{parsed.scheme}://{parsed.netloc}"
        robots_url = f"{base_url}/robots.txt"

        if base_url in self.parsers:
            return self.parsers[base_url]

        rp = urllib.robotparser.RobotFileParser()
        rp.set_url(robots_url)
        try:
            # 读取并解析远端 robots.txt
            rp.read()
        except Exception as e:
            # 若连接超时或发生网络异常,视情况处理;若服务器明确返回 404,标准库会视为允许
            print(f"[提示] 读取 {robots_url} 异常: {e},将采用默认防护策略")

        self.parsers[base_url] = rp
        return rp

    def can_fetch(self, target_url: str) -> bool:
        """检查目标 URL 是否被 robots.txt 允许抓取"""
        rp = self.get_robot_parser(target_url)
        return rp.can_fetch(self.bot_name, target_url)

    def fetch(self, target_url: str):
        """执行符合规范的安全抓取"""
        if not self.can_fetch(target_url):
            print(f"[拒绝] 根据 robots 协议,禁止爬取路径: {target_url}")
            return None

        rp = self.get_robot_parser(target_url)

        # 获取网站指定的爬取延迟(秒)
        delay = rp.crawl_delay(self.bot_name)
        if delay:
            print(f"[限速] 遵守 robots.txt 声明的延迟,等待 {delay} 秒...")
            time.sleep(delay)
        else:
            # 网站未声明延迟时,保持默认安全间隔(如 1 秒),避免高频冲击
            time.sleep(1.0)

        try:
            response = self.session.get(target_url, timeout=10)
            if response.status_code == 200:
                print(f"[成功] 成功获取内容,状态码: {response.status_code}")
                return response.text
            elif response.status_code in (403, 429):
                print(f"[警告] 收到 {response.status_code} 状态码,对方已限流或拒绝,暂停抓取。")
                return None
            else:
                print(f"[通知] 响应状态码: {response.status_code}")
                return None
        except requests.RequestException as err:
            print(f"[错误] 请求发生异常: {err}")
            return None

# 示例调用
if __name__ == "__main__":
    crawler = CompliantCrawler(bot_name="MyDataBot", contact_email="dev@example.com")

    # 示例待测网址
    test_url = "https://www.python.org/blogs/"
    crawler.fetch(test_url)
四、编写安全合规爬虫的五大工程准则
仅解析 robots.txt 并不能豁免所有的法律风险。在实际工程项目中,开发团队应当落实全生命周期的合规管理措施。
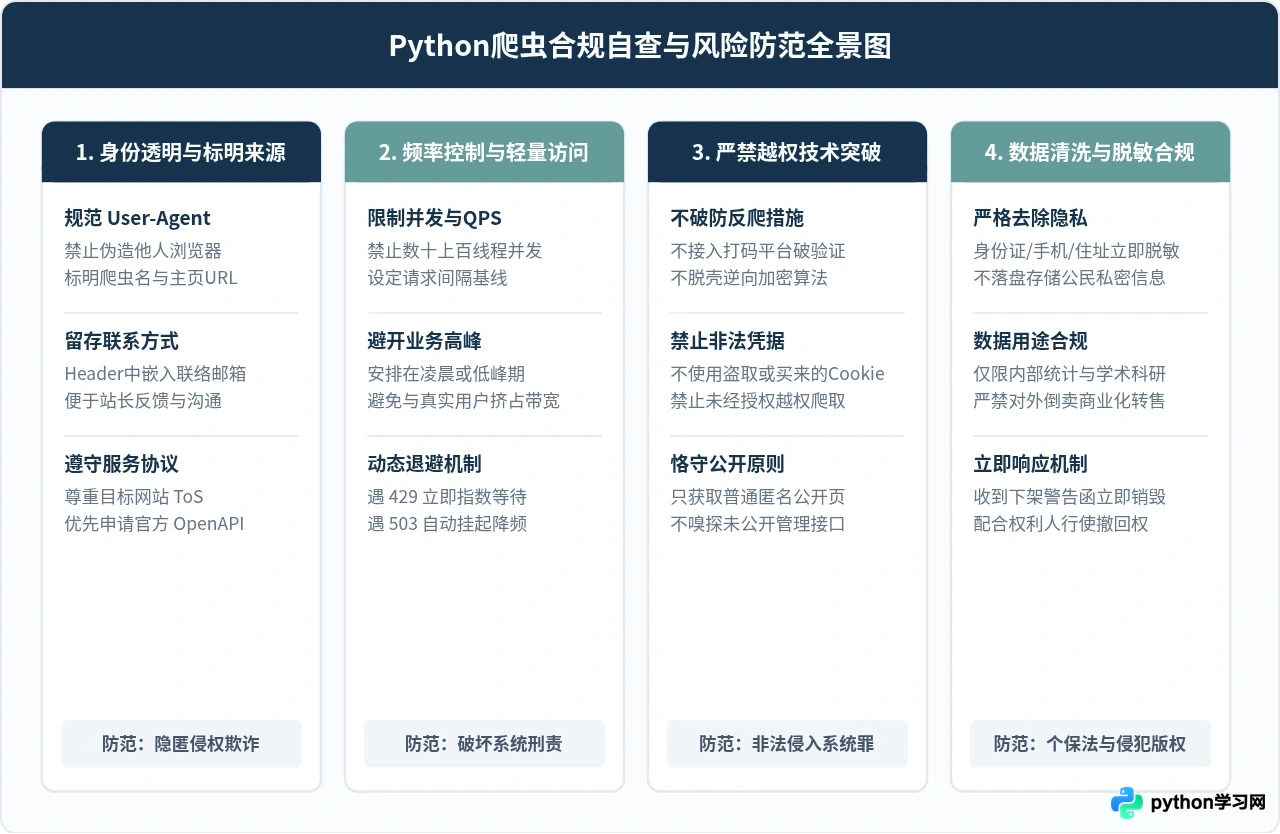
切忌随意伪装为普通的桌面浏览器 User-Agent(如假冒 Chrome 或 Safari)。合规的做法是在请求头中明确标明自身产品标识与负责人的联系方式或合规说明页面,让目标网站运维团队能够在发生资源异常时迅速联系到你,而不是直接将事件上报至网安执法部门。
如果目标网站引入了诸如滑动拼图验证码、短信二次验证、设备指纹等明确的技术防护手段,切勿在代码中接入第三方自动化打码平台进行破防。在最高人民法院与最高人民检察院的司法解释中,绕过或攻破这类防护措施直接等同于“侵入计算机信息系统”,这是技术人员涉刑的最常见雷区。
五、常见爬虫合规疑问与解答 (FAQ)
Q1: 网页上公开展示的数据,是不是就可以随意抓取并不受限制?
答:不是。“公开”不等于“公有领域自由使用”。公开数据依然受到著作权(文章、图片等)、反不正当竞争法(平台耗费大量人力财力沉淀的商业数据库)以及个人信息保护法(如公开的用户个人资料)的保护。如果抓取公开数据后用于直接竞争、批量贩卖或商业替代,依然会承担严重的法律责任。
Q2: 严格遵守了目标网站的 robots.txt,是不是就一定不违法?
答:不一定。robots.txt 只是网络通信层面的一个技术约定,是合规的“必要条件”,但非“充分条件”。即使 robots.txt 允许抓取,如果你的爬虫高频并发导致对方服务器瘫痪,依然构成破坏计算机信息系统罪;如果抓取的数据涉及公民个人敏感隐私,依然触犯个人信息保护法与刑法。
Q3: 企业或个人开发者在什么场景下可以较为安全地使用爬虫?
答:在满足以下条件时,法律风险通常处于可控范围内:1. 抓取目标为完全公开的非个人敏感信息(如宏观行业指标、无版权争议的公开公告);2. 遵守 robots.txt 且抓取频次极低,不影响对方服务器运行;3. 数据仅用于企业内部数据分析、学术科研或模型训练基准,不对外发布、不转售、不与原网站构成商业竞争。
六、总结
技术是一把双刃剑,Python 网络爬虫能够极大提升信息搜集与处理的效率,但其运行绝不能脱离法律制度与行业公约的轨道。在编写任何爬虫程序前,开发者应当把合规意识置于代码逻辑之前:查阅目标网站的 robots.txt 协议、评估数据是否涉及个人隐私与商业秘密、设定克制且友好的抓取频率、严格禁止任何破解对抗手段。唯有把爬虫技术约束在规则与阳光之下,才能保证技术成果的真正价值与长久生命力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









