

Python和Java怎么混合使用?JNI、JPype与REST API集成方案指南
全面解析Python与Java混合调用的三种主流方案:通过JNI的底层C胶水桥接、通过JPype在同进程内直接嵌入JVM调用Java类,以及通过REST API进行进程解耦与服务化集成。包含完整代码示例、架构拓扑、选型决策与避坑指南。
一、核心机制剖析:三种混合模式的本质区别
Python 与 Java 属于两套设计哲学完全不同的运行环境:CPython 依赖全局解释器锁(GIL)管理对象引用与内存,而 Java 运行在高度并发优化、拥有分代垃圾回收机制的 JVM(Java 虚拟机)之上。要让两者协同工作,本质上是在解决进程拓扑关系与数据交换契约的问题。
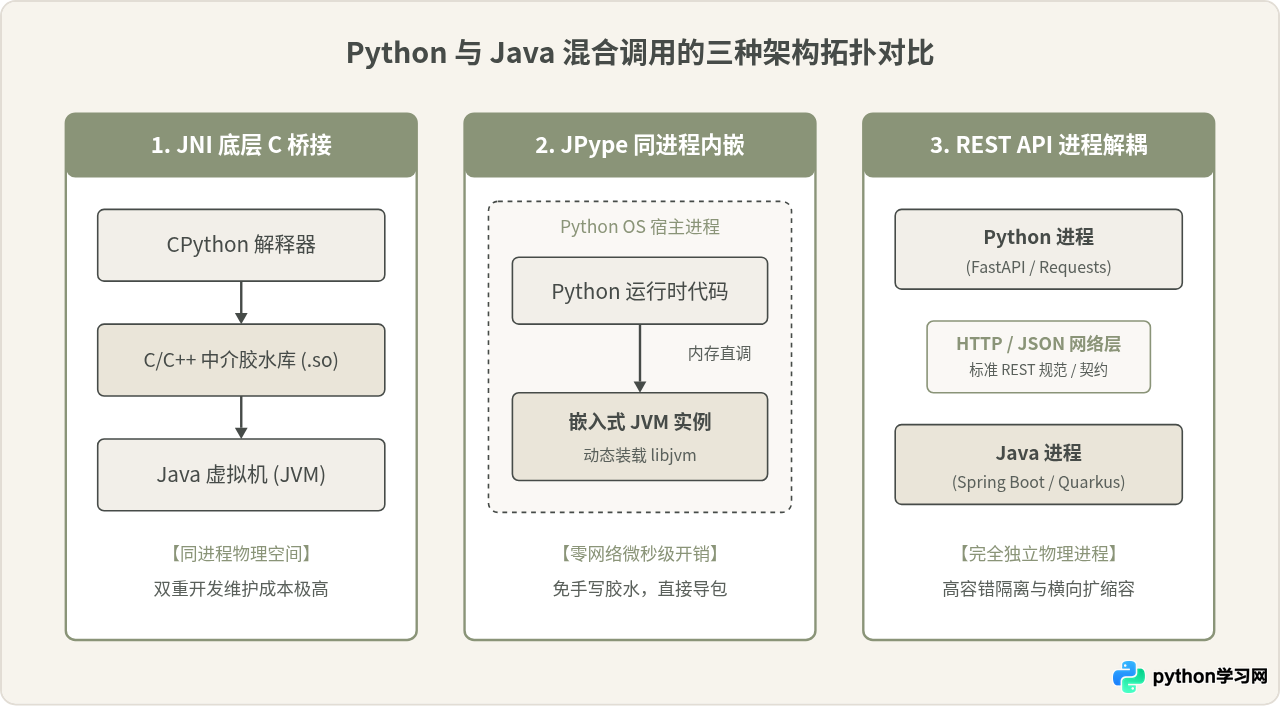
从物理拓扑与调用开销维度划分,主要存在以下三类方式:
- JNI 桥接(原生内存共享):通过 C/C++ 编写动态链接库,一头包装 Python C-API,另一头接入 Java Native Interface。两门语言运行在同一个 OS 进程内,直接通过原生指针对接数据。
- JPype 内嵌(进程级 JVM 托管):在 Python 进程启动时动态加载
libjvm.so(或jvm.dll),直接在 CPython 进程的地址空间中拉起一个完整的 JVM 实例,无需任何 C/C++ 胶水代码即可在 Python 中直接import并调用 Java 类。 - REST API(进程间网络解耦):Python 与 Java 分别作为独立操作系统进程(甚至运行在不同主机或容器内),通过 HTTP 协议传输 JSON/Protobuf 报文进行数据交换。
二、方案一:JPype——Python 进程内直调 Java 的轻量利器
当你需要在 Python 脚本中直接利用现有的 Java 业务 JAR 包(例如特定加密解密 SDK、大数据处理逻辑或专用解析引擎),且不想搭建繁杂的后端微服务时,JPype 是最高效的选择。
JPype 在 CPython 底层实现了对 Java 原生接口的自动映射。开发者无需手工编写任何 C/C++ 包装代码,即可像调用 Python 原生对象一样实例化 Java 类。
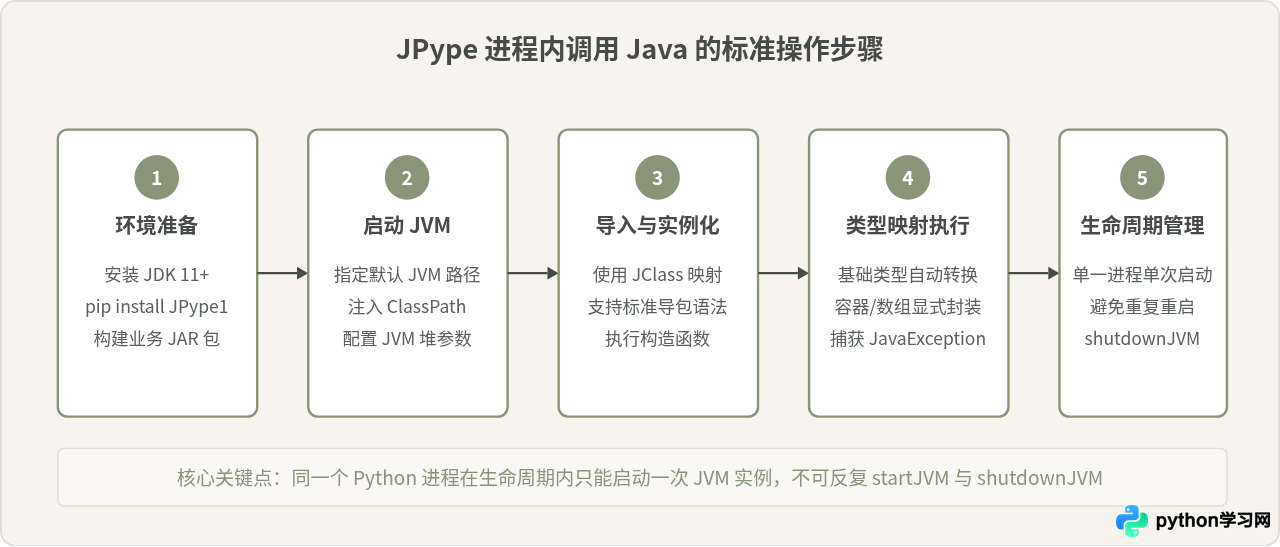
1. 标准落地操作流程
使用 JPype 调用 Java 类的过程具有清晰的阶段性,包括环境初始化、启动 JVM 注入依赖、类加载与实例化、数据交互以及进程退出清理。
2. JPype 完整代码实操示例
假设我们有一个现成的 Java 类,用于执行加解密与特征计算:
// DataProcessor.java
package com.example.engine;

public class DataProcessor {
    private String salt;

    public DataProcessor(String salt) {
        this.salt = salt;
    }

    public String computeDigest(String rawText, int rounds) {
        if (rawText == null) {
            throw new IllegalArgumentException("rawText cannot be null");
        }
        return "DIGEST[" + salt + ":" + rawText + ":" + rounds + "]";
    }
}
在将其编译并打包为 engine.jar 后,Python 代码可直接按如下方式进行调用:
import jpype
import jpype.imports
from jpype.types import *

def run_java_in_python():
    # 1. 获取系统默认 JVM 共享库路径
    jvm_path = jpype.getDefaultJVMPath()
    jar_path = "./libs/engine.jar"

    # 2. 启动内嵌 JVM
    if not jpype.isJVMStarted():
        jpype.startJVM(
            jvm_path,
            f"-Djava.class.path={jar_path}",
            "-Xmx512m"  # 设定 JVM 最大堆内存
        )

    try:
        # 3. 动态导入 Java 类 (亦可直接使用 jpype.JClass('com.example.engine.DataProcessor'))
        from com.example.engine import DataProcessor
        from java.lang import System

        # 4. 实例化与调用
        processor = DataProcessor("SecretKey_2026")
        result = processor.computeDigest("UserDataPayload", 3)

        print(f"[Java Output]: {result}")
        print(f"[JVM Vendor]: {System.getProperty('java.vendor')}")

    except jpype.JException as e:
        # 5. 精确捕获来自 JVM 内部抛出的异常
        print(f"Java Exception caught: {e}")
    finally:
        # 6. 关闭 JVM (通常在应用彻底退出时调用)
        if jpype.isJVMStarted():
            jpype.shutdownJVM()

if __name__ == "__main__":
run_java_in_python()str 映射为 java.lang.String,int 映射为 int/long)。但涉及泛型容器(如 List<String>、Map)或多维原生数组时,必须使用 jpype.JArray 或 java.util.ArrayList 显式转换,以避免重载方法签名无法匹配。
三、方案二:REST API——生产环境最稳健的跨语言解耦
在分布式微服务与现代 Web 架构中,REST API 是连接 Python 与 Java 系统的事实标准。
虽然同进程内嵌方案(如 JPype)拥有极致的性能,但在工业级生产环境中,盲目追求同进程往往会引入严重的运维黑洞:一旦 Java 发生 OutOfMemoryError、堆外内存溢出或 JNI 级崩溃,会导致包含 Python 的整个宿主进程瞬时闪退;此外,两者的内存监控、线程池调优与日志收集机制高度交织,极难排查。
1. 典型服务交互实践:FastAPI 与 Spring Boot
最普遍的业务场景是:Java Spring Boot 负责承载核心业务流、事务控制与高并发数据库访问;Python FastAPI 负责处理深度学习推理或复杂数据分析。
Python 端(FastAPI 暴露计算接口):
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
import uvicorn

app = FastAPI(title="Python Inference Service")

class PredictRequest(BaseModel):
    user_id: str
    feature_vector: list[float]

class PredictResponse(BaseModel):
    user_id: str
    prediction_score: float
    status: str

@app.post("/api/v1/predict", response_model=PredictResponse)
def handle_prediction(payload: PredictRequest):
    if len(payload.feature_vector) == 0:
        raise HTTPException(status_code=400, detail="Empty feature vector")

    # 模拟矩阵特征计算
    score = sum(payload.feature_vector) / len(payload.feature_vector)

    return PredictResponse(
        user_id=payload.user_id,
        prediction_score=round(score, 4),
        status="SUCCESS"
    )

if __name__ == "__main__":
    uvicorn.run(app, host="0.0.0.0", port=8000)
Java 端(Spring Boot 客户端发起调用):
package com.example.service;

import org.springframework.stereotype.Service;
import org.springframework.web.client.RestTemplate;
import org.springframework.http.ResponseEntity;
import org.springframework.http.HttpEntity;
import org.springframework.http.HttpHeaders;
import org.springframework.http.MediaType;
import java.util.List;
import java.util.Map;
import java.util.HashMap;

@Service
public class AiInferenceClient {

    private final RestTemplate restTemplate = new RestTemplate();
    private static final String PY_URL = "http://127.0.0.1:8000/api/v1/predict";

    public Double requestScore(String userId, List<Double> features) {
        HttpHeaders headers = new HttpHeaders();
        headers.setContentType(MediaType.APPLICATION_JSON);

        Map<String, Object> requestPayload = new HashMap<>();
        requestPayload.put("user_id", userId);
        requestPayload.put("feature_vector", features);

        HttpEntity<Map<String, Object>> entity = new HttpEntity<>(requestPayload, headers);

        // 发送跨进程 HTTP POST 请求
        ResponseEntity<Map> response = restTemplate.postForEntity(PY_URL, entity, Map.class);

        if (response.getStatusCode().is2xxSuccessful() && response.getBody() != null) {
            return (Double) response.getBody().get("prediction_score");
        }
        throw new RuntimeException("Python inference service error");
    }
}
四、方案三:JNI (Java Native Interface) 与 C 桥接——底层通道的得与失
JNI 是 Java 虚拟机官方提供的原生扩展规范,允许 Java 代码直接与 C/C++ 动态链接库进行双向调用。
在 Python 与 Java 混编的语境下,通过 JNI 交互需要经历双重胶水包装:
- 首先通过 Python C-API 解析 CPython 的
PyObject结构体; - 在 C/C++ 层获取数据后,通过 JNI 接口(如
JNIEnv->FindClass,CallObjectMethod)反射调用 Java 内部方法; - 最后手工处理 Java 局部引用表溢出(Local Reference Table Overflow)与 C 语言内存释放。
DeleteLocalRef,就会导致全进程静默内存泄漏或 Segmentation Fault 崩溃。除非是底层高性能计算库或驱动层开发,否则 JPype 或跨进程服务化是更理性的替代方案。
五、常见认知误区与深度辨析
围绕 Python 和 Java 的混合使用,开发者常常存在一些似是而非的观念。通过客观的条件限定,我们对以下三个典型误区进行辨析:
1. 误区一:“微服务/REST API 通信开销大,延迟无法用于生产”
辨析与修正:该说法在纯粹理论对比时看似成立(网络栈与 JSON 序列化确实增加 1~5 毫秒开销),但在绝大多数业务场景中并不成立。当调用的远端任务本身耗时在数十毫秒甚至数秒(例如大模型生成、复杂报表统计、批量数据库落库)时,几毫秒的网络与反序列化时间占比微不足道。只有在超高频调用(如每秒数十万次循环运算)且单次交互耗时要求在微秒级时,进程内直调才是唯一选择。
2. 误区二:“JPype 只是个脚本工具,无法承载多线程并发”
辨析与修正:JPype 完全支持多线程,但必须遵守 JVM 线程规则。Python 的多线程直接调用 Java 时,常常会抛出 java.lang.IllegalStateException 或无响应,原因在于 JVM 并不知晓当前操作系统原生线程的存在。在使用 Python threading 模块调用 Java 之前,必须先显式调用 jpype.attachThreadToJVM(),并在线程结束时执行 jpype.detachThreadFromJVM()。忽视线程挂载才是导致多线程调用失败的根源。
3. 误区三:“同进程混编性能最高,一定优于跨进程通信”
辨析与修正:性能不仅包括单次执行吞吐量,还包括系统的稳定性与扩展性。同进程混编意味着 Python 和 Java 必须打包在同一个容器中,无法针对 Python 的 GPU 资源与 Java 的内存资源进行独立水平扩容(Horizontal Pod Autoscaler)。此外,Java 的 GC 停顿或 Python 的 GIL 争用可能会相互放大,导致系统排查成本剧增。
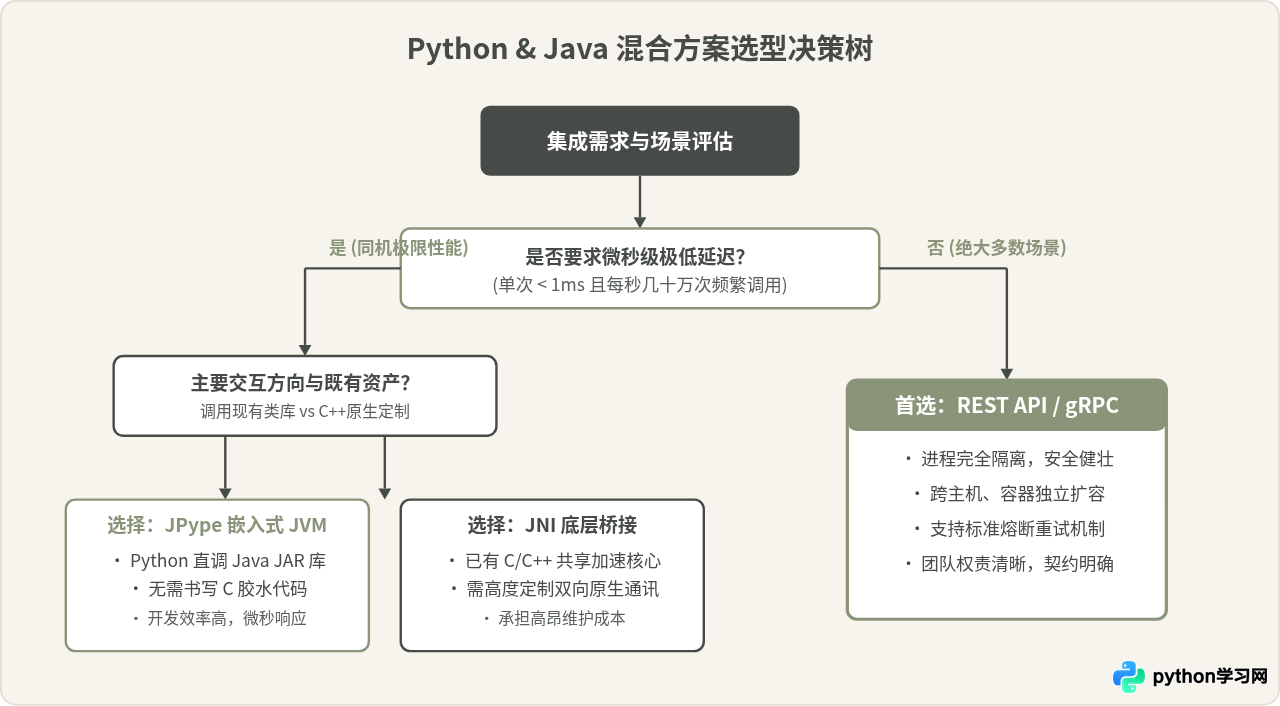
六、方案选型决策:如何针对实际业务选择架构?
选择合适的混合集成方案,应从吞吐延迟诉求、代码侵入性、运维隔离级别三个核心维度进行漏斗式推导:
七、全景对比与工程落地建议
为了帮助开发团队建立全局认识,下表从六个核心维度将三种方案进行了横向比对:
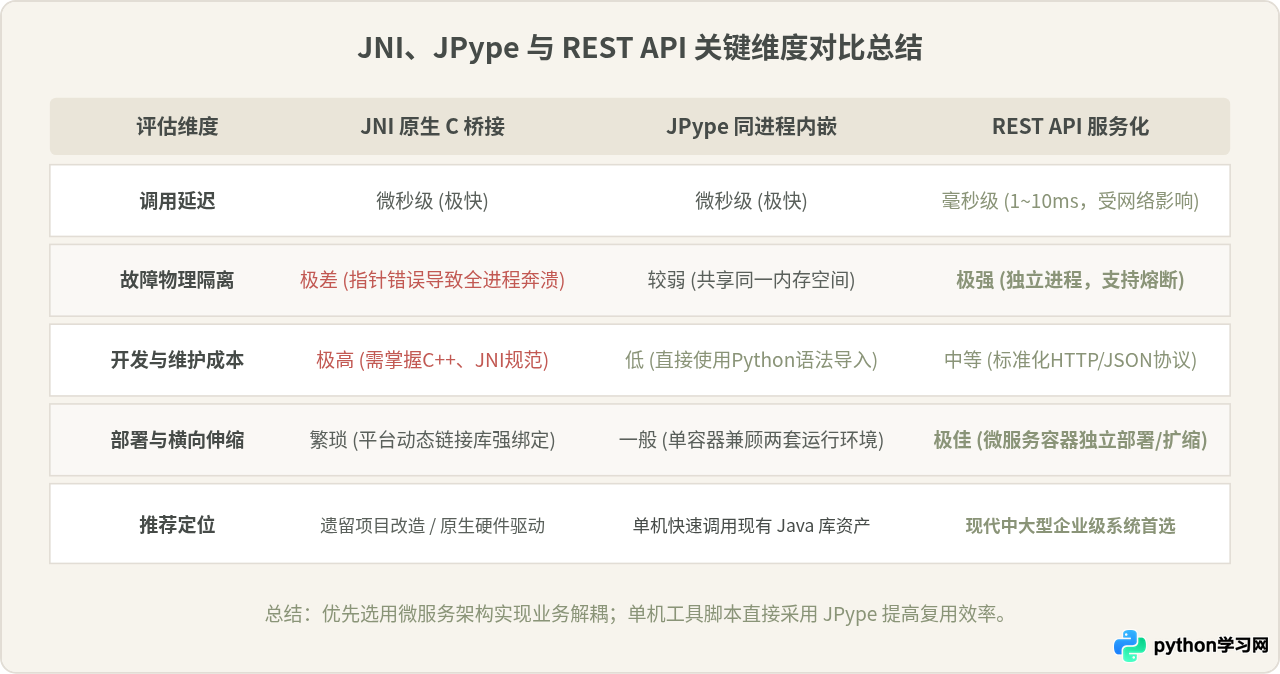
工程落地的关键建议:
- 优先采用“契约优先”的微服务解耦模式:现代团队开发中,语言隔离即是边界隔离。除非性能压测明确显示网络序列化是唯一瓶颈,否则永远首选 REST API(或性能更高的 gRPC)。这样 Python 算法工程师与 Java 业务工程师可以各自独立迭代发布,互不干扰。
- 单机本地工具脚本首选 JPype:在运维脚本、单机数据批处理或需要快速验证某个 Java SDK 功能时,JPype 是最省时省力的利器,能大幅减少环境搭建与接口定义的工作量。
- 谨慎对待 JNI 手工编写:避免因为对“极致性能”的执念而引入手写 JNI。绝大多数业务场景无法承担 C++ 胶水代码带来的内存泄漏风险与跨平台编译维护负担。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









