

大型Python项目中怎么规范组织models目录与多模型管理
针对大型Python项目在业务扩张中面临的模型膨胀与循环依赖难题,系统阐述models目录的领域分包架构、Base与Mixins拆分、跨模型解耦技巧、动态注册与自动化迁移管理规范。
大型 Python 项目管理数据模型的关键,在于将单一失控的 models.py 转化为按业务限界上下文拆分的 models/ 模块包,并确立“基类下沉、显式导出、依赖解耦、元数据统一收集”的工程体系。通过确立清晰的目录分层、消除跨模型循环引用,以及配置自动化数据库迁移注册链路,能够保证几十甚至数百个模型在协同开发中保持高内聚、低耦合与易维护。
一、单文件模型的困境与拆分动因
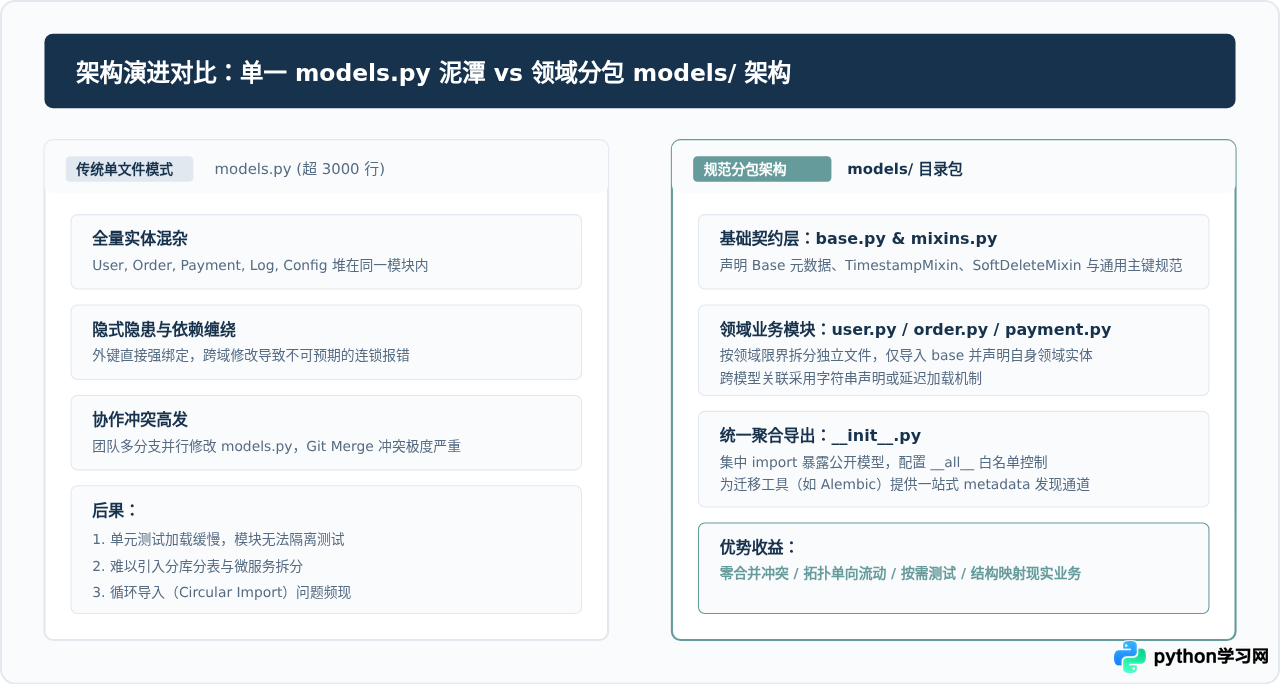
在项目初期,许多开发者习惯将所有实体全部写在同一个 models.py 文件中。随着系统功能演进,用户、商品、订单、履约、支付等模块不断涌入,单文件往往迅速膨胀至数千行。这种代码组织方式在多人协作时暴露出严重的工程缺陷:
- Git 合并冲突频繁: 多个开发人员在同一文件内添加字段、修改索引或添加外键,频繁引发难以自动解决的代码冲突。
- 职责划分混乱: 核心用户模型与边缘日志模型并列堆叠,缺乏业务领域边界,新成员难以理清数据从属关系。
- 冷启动与测试开销沉重: 任何轻量级单元测试只要导入某个辅助模型,就会被迫导入整个庞大文件内的所有依赖库与全局对象。
二、标准 models 目录层级设计
将 models.py 转化为包目录时,应避免盲目碎片化(例如一个模型建一个子包)。合理的目录结构应兼顾通用抽象与领域划分。推荐的大型工程目录骨架如下:
app/
└── models/
    ├── __init__.py           # 统一聚合导出与 __all__ 定义
    ├── base.py               # 声明式基类、公共 metadata 与类型引擎配置
    ├── mixins.py             # 通用审计字段、时间戳、软删除混合类
    ├── enums.py              # 数据模型专用的公共枚举类
    │
    ├── auth.py               # 用户、角色、权限与凭据模型
    ├── product.py            # 商品、品类、SKU 与库存模型
    ├── order.py              # 订单头、订单项、收件履约模型
    └── payment.py            # 支付记录、退款单与流水日志模型
1. 基类与元数据下沉(base.py)
数据库映射基类(如 SQLAlchemy 的 DeclarativeBase)必须独立置于底层文件,绝不能由某个业务模型兼任定义。若由业务模块定义基类,其他模块继承该基类时就会引入倒置依赖。
# app/models/base.py
from datetime import datetime
from sqlalchemy import MetaData
from sqlalchemy.orm import DeclarativeBase

# 显式定义命名约束,便于迁移脚本生成可预测的外键与索引名称
POSTGRES_INDEXES_NAMING_CONVENTION = {
    "ix": "%(column_0_label)s_idx",
    "uq": "%(table_name)s_%(column_0_name)s_key",
    "ck": "%(table_name)s_%(constraint_name)s_check",
    "fk": "%(table_name)s_%(column_0_name)s_fkey",
    "pk": "%(table_name)s_pkey",
}

class Base(DeclarativeBase):
    """所有持久化模型的统一抽象基类"""
    metadata = MetaData(naming_convention=POSTGRES_INDEXES_NAMING_CONVENTION)
2. 复用字段组件化(mixins.py)
创建时间、更新时间、逻辑删除状态、主键 ID 生成规则等通用属性,应当通过 Mixin 方式进行统一抽象,避免每个业务文件重复拷贝字段定义:
# app/models/mixins.py
from datetime import datetime
from sqlalchemy import DateTime, Integer, func
from sqlalchemy.orm import Mapped, mapped_column

class TimestampMixin:
    """自动维护创建与更新时间的时间戳组件"""
    created_at: Mapped[datetime] = mapped_column(
        DateTime(timezone=True),
        server_default=func.now(),
        nullable=False,
    )
    updated_at: Mapped[datetime] = mapped_column(
        DateTime(timezone=True),
        server_default=func.now(),
        onupdate=func.now(),
        nullable=False,
    )

class PrimaryKeyMixin:
    """统一的自增整型主键"""
    id: Mapped[int] = mapped_column(Integer, primary_key=True, autoincrement=True)
三、跨模型依赖与循环导入(Circular Import)解耦
在拆分后的多模型环境中,最容易导致应用启动崩溃的问题是循环导入。例如:Order 模型需要关联 User,而 User 又定义了 orders = relationship(...) 反向引用 Order。若在文件头部直接相互 import,Python 解释器在执行第二层导入时就会抛出 ImportError: cannot import name ...。
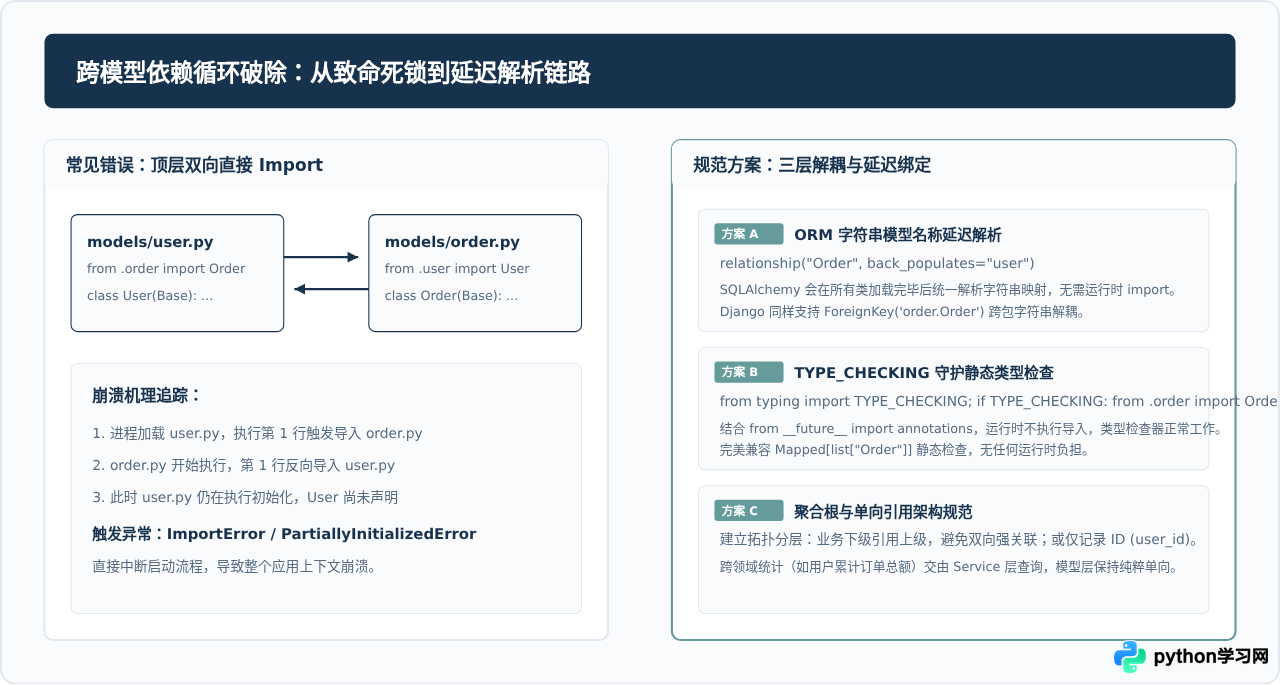
以下是使用现代 Python 类型注解与 ORM 字符串延迟绑定的标准解耦代码示例:
# app/models/user.py
from __future__ import annotations
from typing import TYPE_CHECKING, List
from sqlalchemy import String
from sqlalchemy.orm import Mapped, mapped_column, relationship
from .base import Base
from .mixins import PrimaryKeyMixin, TimestampMixin

if TYPE_CHECKING:
    # 仅供 Mypy / Pyright 静态类型推断,运行时不会执行该导入语句
    from .order import Order

class User(Base, PrimaryKeyMixin, TimestampMixin):
    __tablename__ = "users"

    username: Mapped[str] = mapped_column(String(64), unique=True, index=True)
    email: Mapped[str] = mapped_column(String(255), unique=True)

    # 1. 类型提示使用字符串字面量或配合 __future__ 注解
    # 2. relationship 首参数使用字符串 "Order",由 ORM 在元数据初始化阶段延迟完成绑定
    orders: Mapped[List["Order"]] = relationship(
        "Order",
        back_populates="user",
        cascade="all, delete-orphan",
    )
# app/models/order.py
from __future__ import annotations
from typing import TYPE_CHECKING
from decimal import Decimal
from sqlalchemy import ForeignKey, Numeric, String
from sqlalchemy.orm import Mapped, mapped_column, relationship
from .base import Base
from .mixins import PrimaryKeyMixin, TimestampMixin
if TYPE_CHECKING:
from .user import User
class Order(Base, PrimaryKeyMixin, TimestampMixin):
__tablename__ = "orders"
order_no: Mapped[str] = mapped_column(String(64), unique=True, index=True)
total_amount: Mapped[Decimal] = mapped_column(Numeric(12, 2))
user_id: Mapped[int] = mapped_column(ForeignKey("users.id"), nullable=False, index=True)
# 同样使用字符串 "User" 进行解耦
user: Mapped["User"] = relationship("User", back_populates="orders")四、__init__.py 的聚合导出策略与白名单管控
models/ 目录中的 __init__.py 扮演着“对外统一门面”与“元数据注册器”的双重角色。在大型项目中,绝不能在 __init__.py 中使用通配符 from .xxx import *。随意使用通配符会导致命名污染、难以排查的命名覆盖,以及不可控的静态检查误报。
规范的做法是集中显式引入所有领域模型,并通过 __all__ 数组对外暴露:
# app/models/__init__.py
"""
Models 包统一导出层
对外暴露业务实体,同时确保所有模型类均被 Python 解释器导入并注册至 Base.metadata
"""
from .base import Base
from .mixins import PrimaryKeyMixin, TimestampMixin
from .auth import User, Role, Permission
from .product import Product, Category, SKU
from .order import Order, OrderItem
from .payment import PaymentTransaction, RefundRecord

__all__ = [
    # 基础元数据
    "Base",
    "PrimaryKeyMixin",
    "TimestampMixin",
    # 认证与用户
    "User",
    "Role",
    "Permission",
    # 商品
    "Product",
    "Category",
    "SKU",
    # 订单
    "Order",
    "OrderItem",
    # 支付
    "PaymentTransaction",
    "RefundRecord",
]Alembic 或 Django 迁移命令在生成 autogenerate 迁移脚本时,依赖 Base.metadata.tables 中记录的全部数据表。如果某个模型仅在某个偏僻的后台定时任务中被按需加载,而没有在 __init__.py 中集中导入,迁移工具就会无法发现该表,甚至误判该表已被删除而生成破坏性的 DROP TABLE 迁移代码!通过在 __init__.py 中统一导出,可百分之百保证迁移脚本的准确性。
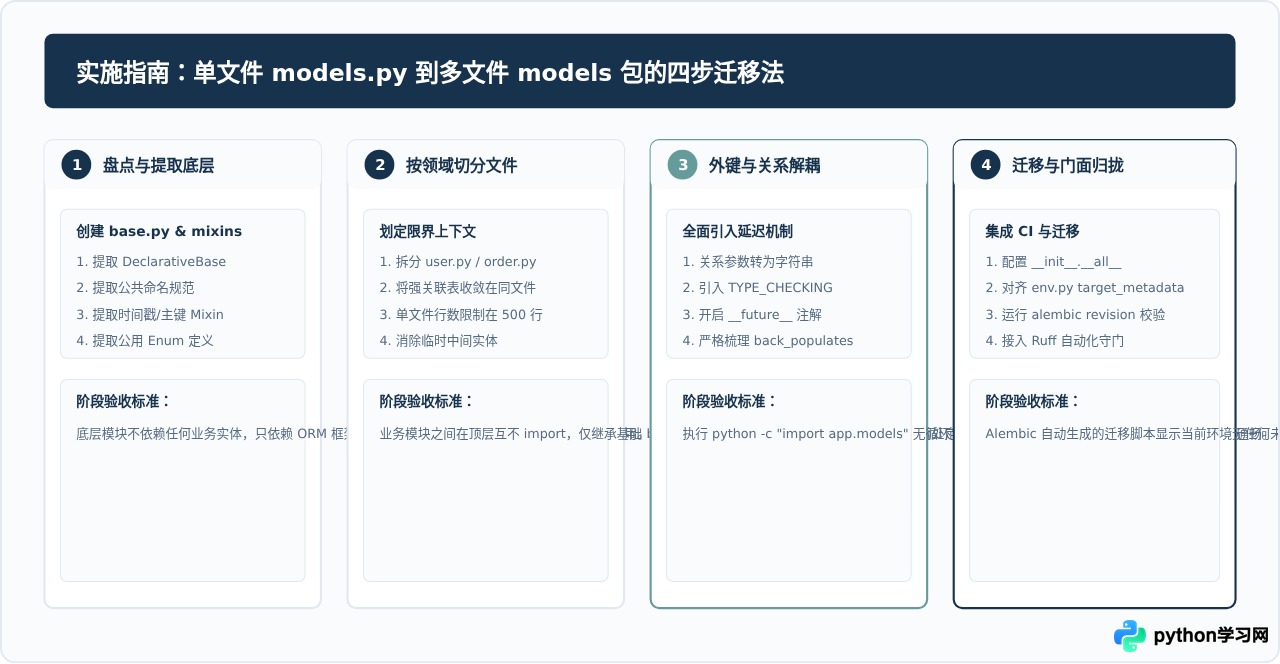
五、从单文件到多模型包的规范重构四步法
对于存量的大型遗留系统,重构模型目录不能一蹴而就,而需要按照清晰的拓扑依赖逐步推进。推荐的落地实施路径如下:
六、与数据库迁移工具(Alembic)的高效协同
在多模型架构下,数据库迁移文件生成器必须能稳定获取所有表格定义。以 SQLAlchemy + Alembic 组合为例,应当在 Alembic 的 migrations/env.py 中直接挂接聚合后的 Base.metadata:
# migrations/env.py 核心片段
from logging.config import fileConfig
from sqlalchemy import engine_from_config, pool
from alembic import context

# 关键步骤:导入 models 包,触发 __init__.py 执行,加载所有业务模型
import app.models
from app.models.base import Base

config = context.config
if config.config_file_name is not None:
    fileConfig(config.config_file_name)

# 将 target_metadata 设置为 Base 声明的 metadata
target_metadata = Base.metadata

def run_migrations_online() -> None:
    """在线模式执行迁移"""
    connectable = engine_from_config(
        config.get_section(config.config_ini_section, {}),
        prefix="sqlalchemy.",
        poolclass=pool.NullPool,
    )

    with connectable.connect() as connection:
        context.configure(
            connection=connection,
            target_metadata=target_metadata,
            # 开启比较类型与列属性变更
            compare_type=True,
            compare_server_default=True,
        )

        with context.begin_transaction():
            context.run_migrations()
七、团队协同规范与自动化防线
组织结构确定后,更重要的是通过工程化工具防止架构在后续迭代中重新腐化。团队应在持续集成(CI)阶段建立强制性守门规则:
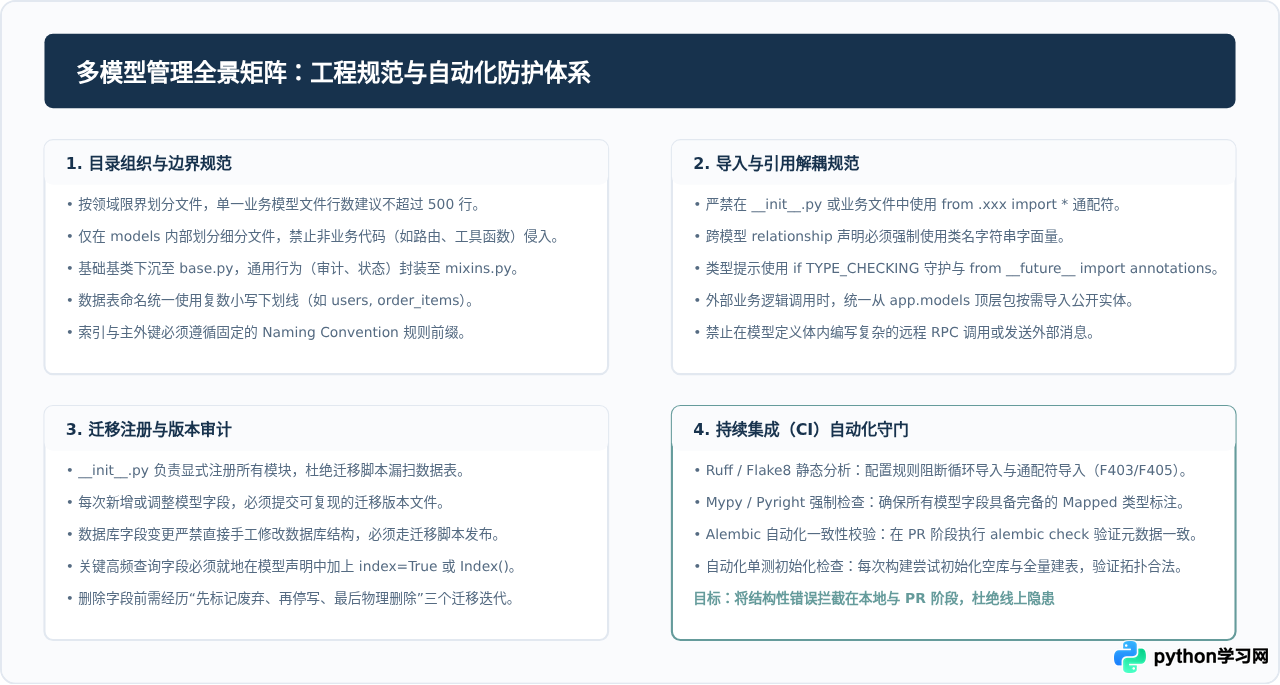
自动化静态防护配置建议
可以在项目根目录的 pyproject.toml 中配置工具链规则,防止团队成员误操作:
# pyproject.toml 关键校验配置
[tool.ruff]
select = [
    "F",      # Pyflakes (包含循环导入、未定义变量检测)
    "E",      # Pycodestyle 错误
    "W",      # Pycodestyle 警告
    "I",      # isort 导入排序规范
    "TCH",    # flake8-type-checking 检查 TYPE_CHECKING 块的合理放置
]
ignore = [
    "F401",   # 在 app/models/__init__.py 中允许存在 re-export 未直接引用的模型
]

[tool.mypy]
python_version = "3.10"
plugins = ["sqlalchemy.ext.mypy.plugin"]
disallow_untyped_defs = true
warn_unused_ignores = true
check_untyped_defs = true
八、总结与核心实践原则
组织大型 Python 项目的 models/ 目录,核心逻辑可以凝练为以下四项原则:
- 基类绝对下沉:
base.py保持纯粹,只承载 ORM 的DeclarativeBase与统一约束规则,决不回引任何业务逻辑。 - 依赖单向流动: 业务模型之间按领域边界划分,跨领域关联强制使用字符串声明与
TYPE_CHECKING延迟注解,从根源切断循环导入。 - 门面统一收敛: 依托
__init__.py的__all__白名单对外提供干净的引用接口,同时保证数据库迁移脚本完整收敛系统元数据。 - 工具自动守门: 借助静态类型检查工具(Mypy/Pyright)和代码规范工具(Ruff),将模型结构规范内嵌至持续集成流水线中,保障工程随着业务增长始终保持健壮。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









