

Python异步爬虫怎么写?asyncio提升抓取效率实战
深入解析基于Python标准库asyncio与aiohttp构建高性能异步爬虫的核心原理与实战步骤。通过对比同步阻塞与事件循环机制,结合信号量并发控制、连接池复用与异常边界设计,彻底解决高并发网络I/O等待瓶颈。
一、为什么同步爬虫慢?阻塞I/O与事件循环机制
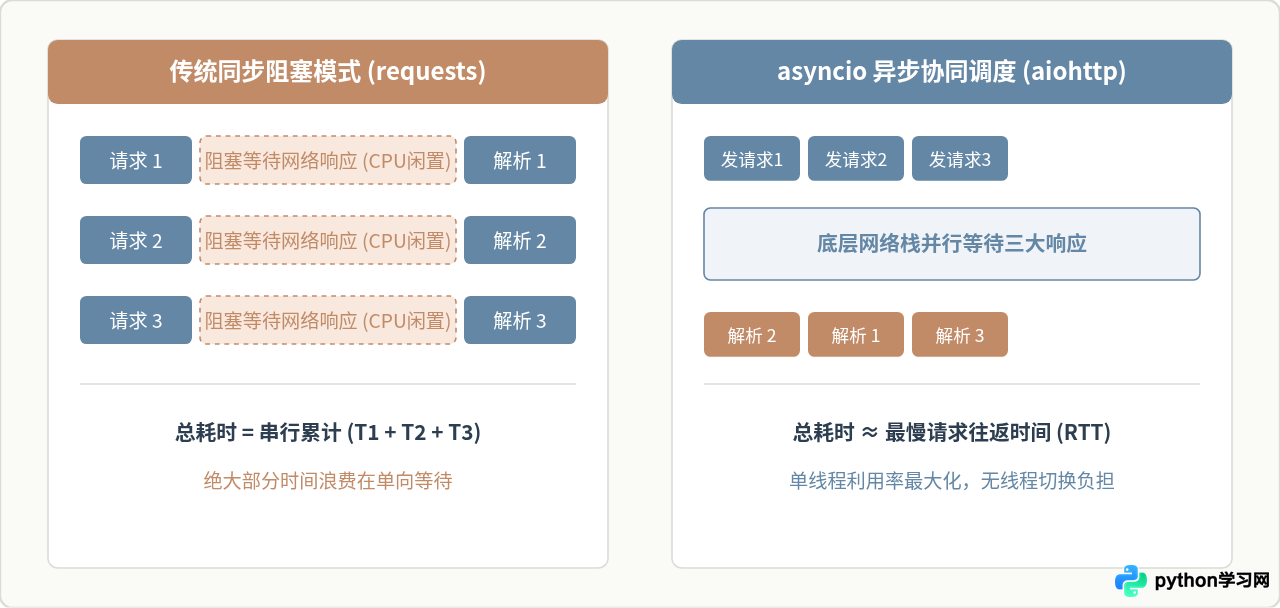
在使用传统的 requests 库编写爬虫时,程序执行流程是纯串行的:发送HTTP请求后,CPU会陷入完全的阻塞状态,必须等到远程目标服务器将数据完整返回(通常需要几百毫秒甚至数秒)才能继续往下执行。在爬取成千上万个页面时,绝大多数时间并非用于数据解析或计算,而是白白耗费在“网络I/O等待”上。
asyncio 改变了这一执行逻辑。它在单线程内运行一个事件循环(Event Loop)。当某个协程(Coroutine)执行到诸如网络请求等异步I/O操作时,会通过 await 关键字主动交出CPU执行权;事件循环立刻将CPU调度给其他就绪的任务;当远程响应数据包到达并触发通知后,事件循环再重新唤醒该协程继续执行后续解析。
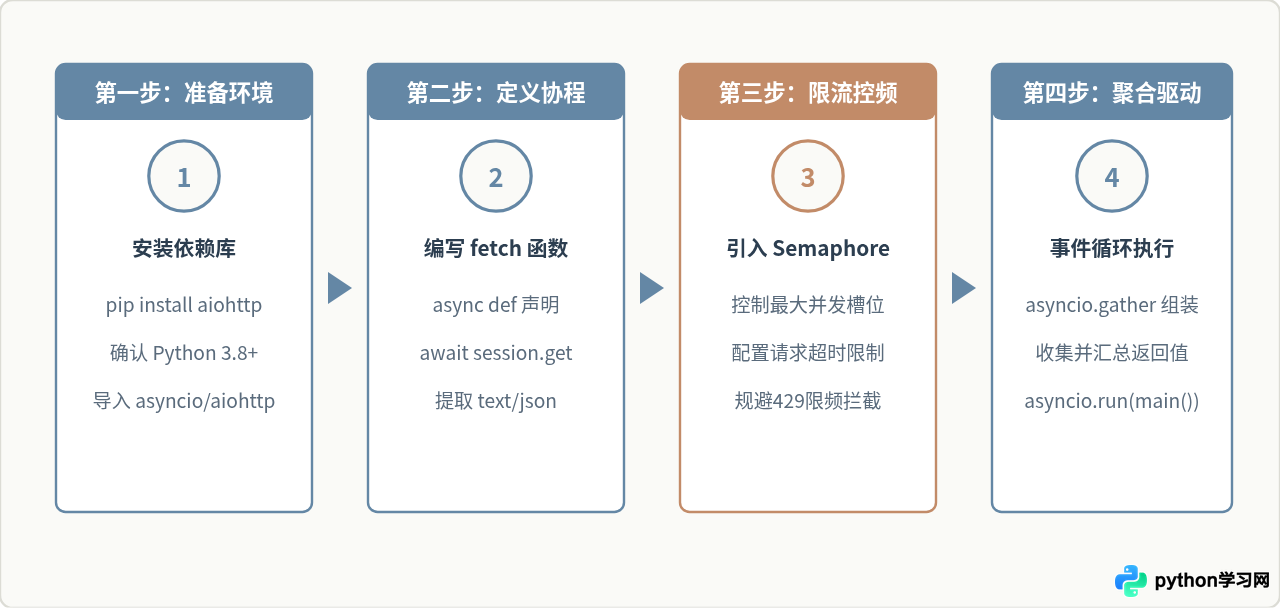
二、异步爬虫落地四步法实战
编写异步爬虫不能直接使用 requests 库,因为其底层的 socket 是同步阻塞的,强行在协程中调用会导致整个事件循环停滞。我们需要使用专为异步设计的网络客户端库 aiohttp。
完整实战代码示例
下面是一个符合生产级规范的基础异步爬虫脚本,包含会话管理、任务列表生成以及并发结果聚合:
import asyncio
import aiohttp

# 单个URL异步请求协程
async def fetch_page(session: aiohttp.ClientSession, url: str) -> str:
    try:
        # 设置单次请求的超时时间(连接10s,读取30s)
        timeout = aiohttp.ClientTimeout(total=30, connect=10)
        async with session.get(url, timeout=timeout) as response:
            if response.status == 200:
                html_text = await response.text()
                print(f"[成功] {url} - 获取字节数: {len(html_text)}")
                return html_text
            else:
                print(f"[警告] {url} - 返回状态码: {response.status}")
                return ""
    except asyncio.TimeoutError:
        print(f"[超时] {url} - 请求超时未响应")
        return ""
    except Exception as exc:
        print(f"[异常] {url} - 抓取失败: {exc}")
        return ""

# 主控协程:负责Session复用与任务分发
async def main():
    target_urls = [
        f"https://httpbin.org/delay/1" for _ in range(20)
    ]

    # 全局复用同一个 ClientSession,自动维护连接池与DNS缓存
    async with aiohttp.ClientSession() as session:
        # 创建待执行的协程任务列表
        tasks = [fetch_page(session, url) for url in target_urls]

        # 并发执行全部任务并等待全部完成
        results = await asyncio.gather(*tasks, return_exceptions=True)

        valid_results = [res for res in results if isinstance(res, str) and res]
        print(f"\n抓取完成!有效结果数: {len(valid_results)} / 总任务数: {len(target_urls)}")

if __name__ == "__main__":
    # 启动事件循环
    asyncio.run(main())
三、并发控制核心:asyncio.Semaphore 限流防封
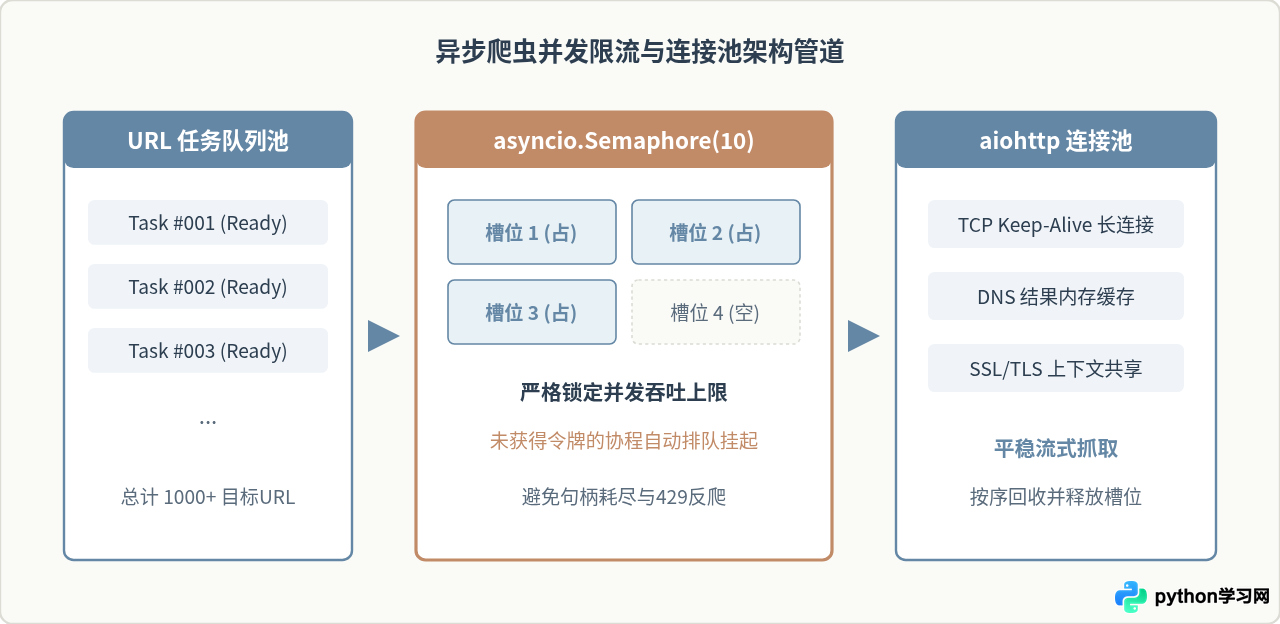
许多初学者在尝到异步的甜头后,容易犯一个严重错误:将成千上万个任务直接塞进 asyncio.gather()。虽然 Python 事件循环本身能够承载数万协程,但外部环境存在硬性约束:
- 本地操作系统文件描述符限制(FD Limit): 每个活跃网络连接对应一个套接字文件句柄,瞬时建立数千个连接会直接抛出
OSError: [Errno 24] Too many open files。 - 目标服务器风控拦截: 目标站点面对来自同一IP短时间内数百次突发请求,会直接判定为DDOS或恶意爬虫,返回
429 Too Many Requests或403 Forbidden。
解决该问题的标准做法是使用 asyncio.Semaphore(信号量)。它就像一个固定容量的“准入许可证池”,确保在任何时刻处于网络活跃状态的协程数量不超过设定阈值。
限流抓取的包装模式
在代码中应用信号量非常简洁,只需要使用 async with sem: 上下文管理器将请求逻辑包裹起来即可:
# 设定最大并发连接数为 15
CONCURRENCY_LIMIT = 15
sem = asyncio.Semaphore(CONCURRENCY_LIMIT)

async def bounded_fetch(session: aiohttp.ClientSession, url: str) -> str:
    # 尝试获取一个信号量许可
    async with sem:
        # 当正在执行的网络任务达到15个时,其他协程在此处等待,不发起请求
        async with session.get(url) as response:
            return await response.text()
四、异步爬虫常见误区与避坑指南
1. 误在协程中调用同步阻塞方法
在 async def 函数内绝对不能调用 time.sleep()、requests.get() 或同步的文件读写与数据库驱动。因为事件循环跑在单线程中,一旦某个同步调用耗时2秒,整个程序在这2秒内将无法调度任何其他协程,异步直接退化为同步串行。应使用 asyncio.sleep() 替代延时;若必须调用同步CPU密集型或旧版第三方库,需借助 loop.run_in_executor() 移交至独立线程池执行。
2. 每次请求都重新实例化 ClientSession
有的开发者将 async with aiohttp.ClientSession() as session: 写在单个请求函数内部。这意味着每次请求都会重新初始化连接池、解析DNS并完成TCP三次握手和TLS握手,请求完毕即刻销毁。这不仅产生巨大的性能浪费,还会造成本地短时产生大量处于 TIME_WAIT 状态的端口。务必在最外层的 main 函数中统一定义一个 Session,并通过参数传递给所有抓取协程复用。
3. 异常处理缺失导致 gather 整体雪崩
默认情况下,asyncio.gather(*tasks) 只要有一个任务抛出未捕获的异常,就会立即将该异常向外抛出,其他正在执行的任务虽然继续运行,但后续的接收逻辑被打断。在生产环境中,应在单个抓取函数内对 aiohttp.ClientError 和 asyncio.TimeoutError 做全面 try-except 兜底,并设置 gather(..., return_exceptions=True)。
五、总结与高效率工程准则
使用 asyncio 编写异步爬虫并非一味追求极限并发数值,而是在系统稳定性、目标服务器负载边界与数据抓取效率之间找到最佳平衡点。
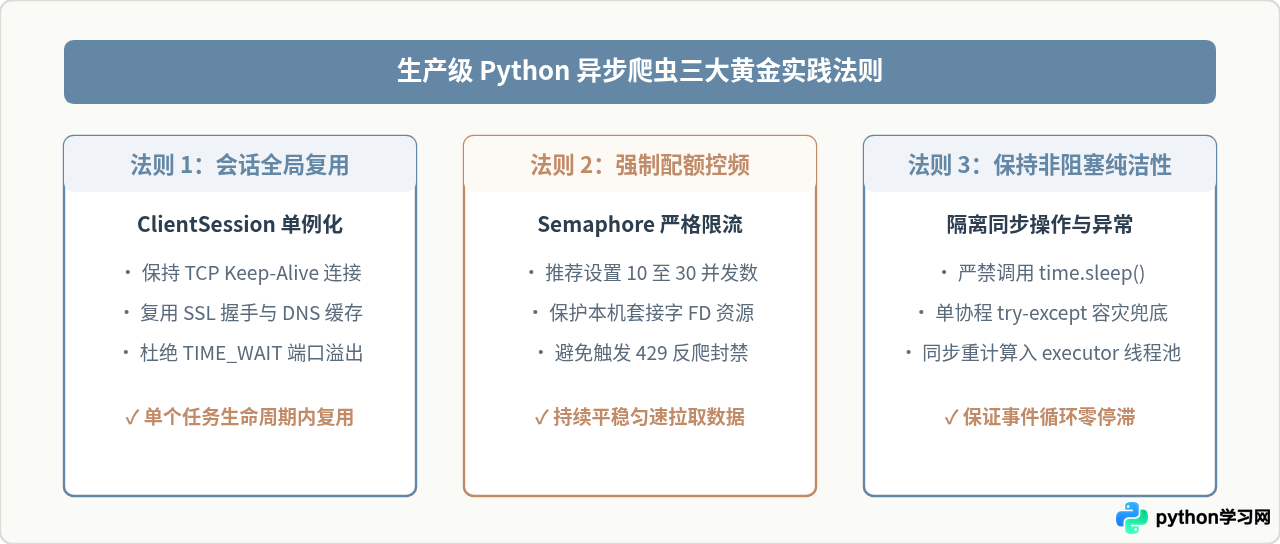
掌握了上述机制与编码模式后,你就已经具备了编写高吞吐、低资源消耗且稳定运行的异步爬虫的能力。在面对更大规模的抓取任务时,可在此基础上叠加分布式队列(如 Redis)或配合持久化管道,真正发挥现代 Python 异步高并发的技术威力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









