

Python网络请求与爬虫基础代码:requests用法与HTML解析示例
面向初学者的Python网络请求与爬虫基础教程。系统介绍requests库的GET/POST请求、请求头设置、参数传递、超时控制,以及使用BeautifulSoup解析HTML文档结构、提取文本与属性的完整代码示例与注意事项。
编写 Python 网络爬虫的核心流程主要由两部分构成:首先使用 requests 库向目标网络服务器发送 HTTP 请求,取得返回的网页源代码;随后利用 HTML 解析库(如 BeautifulSoup)遍历与检索 DOM 节点树,提取出业务所需的文字、链接或图片地址。本文直接面向具体开发场景,完整呈现从依赖准备、请求发送、请求头伪装、DOM 节点定位到异常捕获的基础实现代码与关键排错细节。
一、准备运行环境与安装核心依赖
在开始编写爬虫脚本前,需要确保系统已安装 Python 3 环境。Python 原生标准库中虽然提供了 urllib 模块,但其 API 较为底层且处理 Cookie、会话和请求头相对繁琐。目前行业通用做法是采用优雅易用的第三方库 requests 负责网络通信,并配合 beautifulsoup4 处理 HTML 文档。
在终端或命令行界面中运行以下安装命令:
# 在终端或控制台中安装 requests 与 BeautifulSoup4
pip install requests beautifulsoup4
安装完成后,可以在 Python 交互式环境或脚本中通过导入语句进行验证。若无报错即说明开发环境已就绪:
import requests
from bs4 import BeautifulSoup

print(requests.__version__)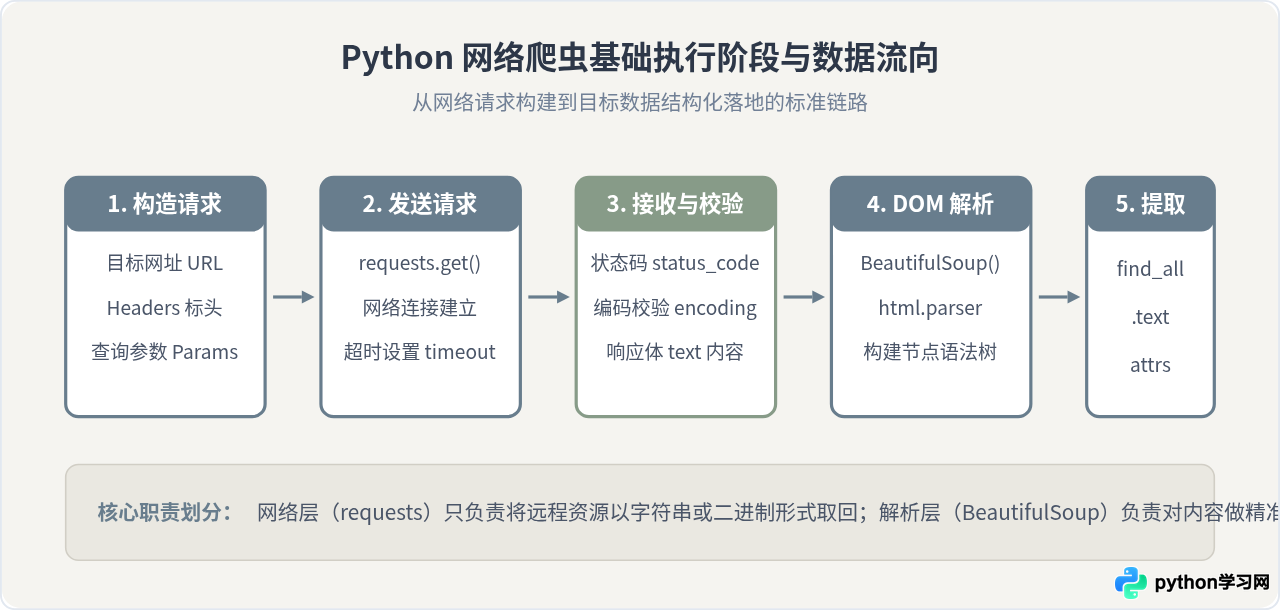
二、使用 requests 库发起基础网络请求
HTTP 协议中最常用的请求方式是 GET 请求。使用 requests.get() 方法只需传入目标 URL,即可获取一个包含了服务器全部返回数据的 Response 对象。
1. 最简 GET 请求代码
import requests

url = "https://httpbin.org/get"
response = requests.get(url)

# 打印响应状态码与内容
print("状态码:", response.status_code)
print("响应内容前100字符:\n", response.text[:100])
2. 常用 Response 属性与文本编码处理
Response 对象提供了若干核心属性,用于读取状态与不同格式的响应体:
response.status_code:整数类型,HTTP 状态码。例如200表示请求成功,404表示资源不存在,403表示服务器拒绝访问。response.text:字符串类型,已根据字符集解码后的响应正文,用于解析 HTML 或获取纯文本。response.content:字节类型(bytes),保存原始二进制数据,常用于下载图片、音频、PDF 等文件。response.encoding:当前响应所采用的编码格式。部分中文网站在响应头中未声明charset=utf-8,可能导致response.text出现乱码,此时可手动赋值修正为response.encoding = 'utf-8'或使用response.apparent_encoding。
三、请求参数传递与请求头 Headers 伪装
在实际网络抓取中,直接向服务器裸发请求往往会被拦截或无法获取特定分页数据。针对这两种常见需求,requests 提供了对应的参数配置项。
1. 通过 params 传递查询字符串
在浏览器中访问 https://example.com/search?keyword=python&page=2 时,问号后的部分即为查询字符串。在代码中不建议手动拼接字符串,而是使用字典结构传递给 params 参数:
import requests

url = "https://httpbin.org/get"
query_params = {
    "keyword": "python",
    "page": 2
}

response = requests.get(url, params=query_params)
print("实际请求URL:", response.url)
# 示例输出: 实际请求URL: https://httpbin.org/get?keyword=python&page=2
2. 通过 headers 设置 User-Agent
requests 在默认情况下发送的请求头中,User-Agent 值为类似 python-requests/2.31.0。许多反爬虫策略会直接识别并拦截非浏览器 User-Agent,返回 403 Forbidden。通过设置请求头字典,可以将请求伪装为标准桌面浏览器:
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8"
}

response = requests.get("https://httpbin.org/headers", headers=headers, timeout=5)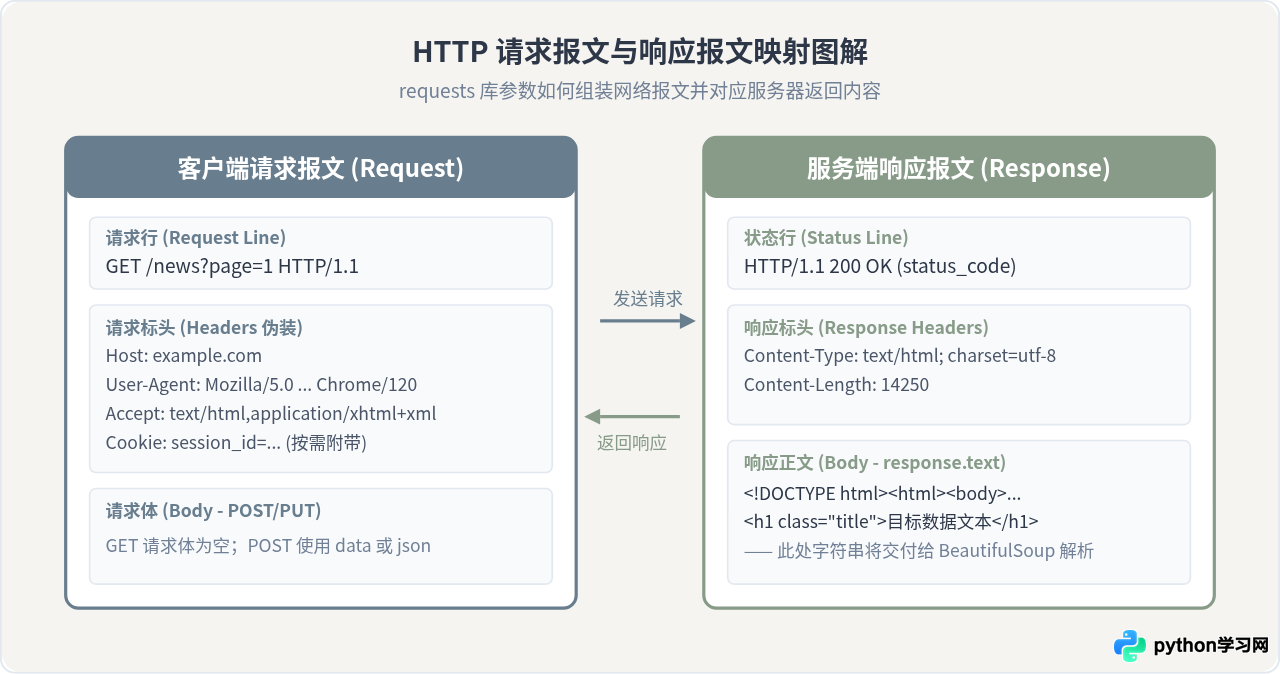
四、请求行为对照:默认裸请求 vs 规范化防护请求
为了让爬虫程序具备稳健的可用性,编写网络请求时通常需要在请求参数层面做严格规范。以下在相同网络环境与目标服务条件下,对比“直接裸请求”与“规范化防护请求”的差异:
| 考量维度 | 直接裸请求 (requests.get(url)) | 规范化防护请求 (带 Headers、timeout 与状态校验) |
|---|---|---|
| 身份特征标识 | 标头为 python-requests/x.x.x,极易被防火墙或 WAF 规则秒级拦截。 |
伪装为标准桌面浏览器 User-Agent,与普通访问流量一致。 |
| 超时控制 (timeout) | 默认 timeout=None。一旦远端服务器无响应或发生丢包,主线程将无限挂起。 |
显式指定例如 timeout=5,超过 5 秒未收到响应即抛出超时异常,便于重试。 |
| 错误响应识别 | 即使服务器返回 404 或 500 报错页,程序仍当作正常页面执行后续解析,导致空数据异常。 |
调用 response.raise_for_status() 或判断 status_code == 200,阻断非法数据污染。 |
| 稳定性与鲁棒性 | 仅适合简单测试;面对真实网站时错误率高、脚本极易中断。 | 适合批量或多阶段自动化抓取任务,容错与可维护性强。 |
五、使用 BeautifulSoup 进行 HTML 文档解析
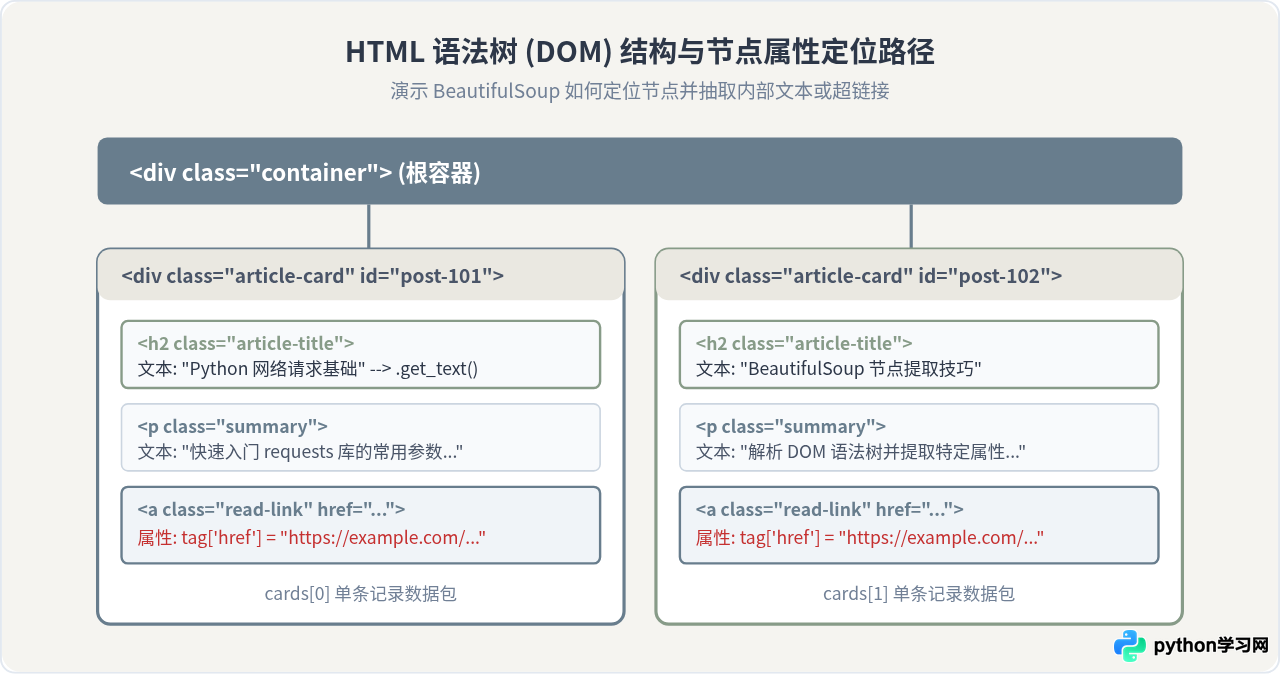
当获取到 response.text 字符串后,需要将其解析为可供结构化检索的 DOM 树对象。BeautifulSoup 支持传入 HTML 文本并选用指定的解析器。标准内置解析器为 html.parser,无需额外安装 C 扩展库即可跨平台运行。
1. 构建 BeautifulSoup 解析对象
from bs4 import BeautifulSoup

# 示例 HTML 片段
html_doc = """
<div class="container">
    <div class="article-card" id="post-101">
        <h2 class="article-title">Python 网络请求基础</h2>
        <p class="summary">快速入门 requests 库的常用参数与调用方法。</p>
        <a class="read-link" href="https://example.com/posts/101">阅读全文</a>
    </div>
    <div class="article-card" id="post-102">
        <h2 class="article-title">BeautifulSoup 节点提取技巧</h2>
        <p class="summary">解析 DOM 语法树并提取特定属性。</p>
        <a class="read-link" href="https://example.com/posts/102">阅读全文</a>
    </div>
</div>
"""

# 创建 soup 对象,选用内置解析器 html.parser
soup = BeautifulSoup(html_doc, "html.parser")
2. 使用 find() 与 find_all() 提取节点
find() 返回符合匹配条件的第一个节点对象(未找到则返回 None);find_all() 返回包含所有匹配节点的列表(未找到则返回空列表 [])。
- 按标签名查找:
soup.find('h2')查找第一个<h2>标签。 - 按类名查找:由于
class是 Python 保留关键字,需使用class_参数,如soup.find_all('div', class_='article-card')。 - 提取文字内容:调用节点的
.text或.get_text(strip=True),去除首尾空白字符。 - 提取属性值:节点对象支持字典式访问或
.get()方法,例如link_tag['href']或link_tag.get('href')。
六、提取方法对照:find/find_all 与 select CSS 选择器
BeautifulSoup 提供了两套常用的节点查找 API:以原生标签参数为代表的 find/find_all,以及基于前端 CSS 语法的 select/select_one。在对相同结构的 HTML 文档进行提取时,两者表现出不同的适用场景与语法特性:
| 比对维度 | find / find_all 方法族 | select / select_one 选择器方法族 |
|---|---|---|
| 语法形式 | 通过 Python 关键字传参:soup.find('a', class_='read-link')。 |
遵循标准 CSS 规则字符串:soup.select('div.article-card a.read-link')。 |
| 层级关系表达 | 表达深层嵌套时需分层级连续调用多次 find(),链条过长时较繁琐。 |
支持空格(后代)、大于号(直接子代)等丰富组合符,一行即可精确定位深层嵌套元素。 |
| 代码可读性 | 简单按单标签或单属性查找时语义明确、参数清晰,对新手极其直观。 | 适合有前端或浏览器开发者工具调试经验的开发者,可直接拷贝审查元素的 CSS 选择器。 |
| 多条件匹配 | 组合多个属性时需要编写字典参数,如 attrs={'data-id': '101'}。 |
支持属性选择器简写,如 div[data-id="101"]。 |
七、完整实战代码示例:网络请求与数据清洗落地
结合上述知识点,以下示例展示一个结构完整、带有异常防御机制的爬虫脚本。代码首先向目标网址发送带有伪装头部的 GET 请求,校验状态码,随后用 BeautifulSoup 解析提取文章标题与链接,最终整合成结构化的字典列表:
import requests
from bs4 import BeautifulSoup

def fetch_and_parse_articles():
    url = "https://httpbin.org/html"
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }

    try:
        # 发起带有超时限制的网络请求
        response = requests.get(url, headers=headers, timeout=10)
        # 校验 HTTP 状态码,如果返回 4xx/5xx 则触发异常
        response.raise_for_status()

        # 针对中文编码问题可在此处显式校正
        response.encoding = response.apparent_encoding

    except requests.exceptions.Timeout:
        print("错误:请求连接超时,请检查网络或目标网站响应状态。")
        return []
    except requests.exceptions.RequestException as e:
        print(f"错误:网络请求失败 - {e}")
        return []

    # 载入 HTML 内容并初始化 BeautifulSoup
    soup = BeautifulSoup(response.text, "html.parser")

    # 提取目标数据
    results = []

    # 示例以页面中的标题与段落作为演示提取目标
    heading_tag = soup.find("h1")
    if heading_tag:
        page_title = heading_tag.get_text(strip=True)
    else:
        page_title = "未获取到标题"

    paragraphs = soup.find_all("p")
    for index, p_node in enumerate(paragraphs, start=1):
        content_text = p_node.get_text(strip=True)
        if content_text:
            results.append({
                "index": index,
                "title": page_title,
                "text": content_text
            })

    return results

if __name__ == "__main__":
    data_list = fetch_and_parse_articles()
    print(f"抓取完成,共提取 {len(data_list)} 条记录:")
    for item in data_list:
        print(f"[{item['index']}] 标题: {item['title']} | 内容: {item['text'][:40]}...")
运行结果示例(控制台打印输出):
抓取完成,共提取 1 条记录:
[1] 标题: Herman Melville - Moby-Dick | 内容: Availing himself of the mild, summer-cool weather that now reigned...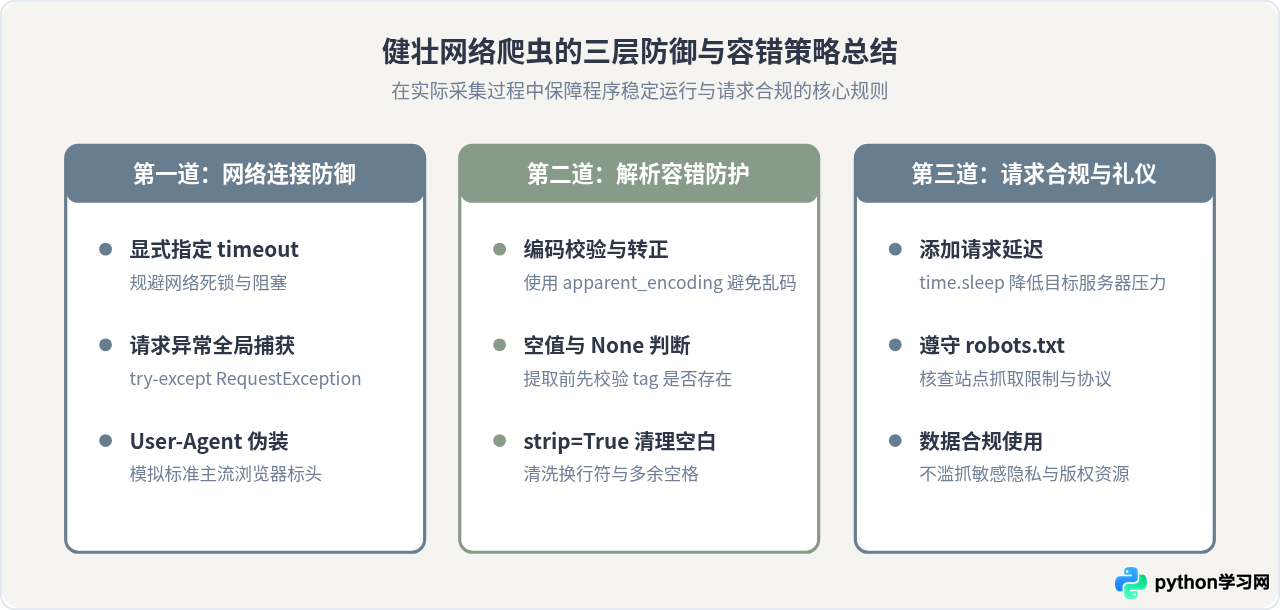
八、常见问题与注意事项
防踩坑要点提示:
- AttributeError: 'NoneType' object has no attribute 'text':最常出现的报错。原因是
soup.find(...)未能在 HTML 中匹配到符合条件的节点,返回了None。在调用.text或['href']前,务必先判断节点是否存在(例如if tag:)。 - 动态渲染页面无法抓取:许多现代前端框架(如 React、Vue)的内容是通过 JavaScript 异步异步接口拉取并渲染的。直接使用
requests.get()获取到的仅仅是骨架 HTML,里面不含实际内容。遇到此类页面应优先在浏览器开发者工具(Network 标签页)中抓包排查其真实数据接口(通常为返回 JSON 数据的 Fetch/XHR 接口),直接请求该接口效率更高。 - 合理设置采集频率:在进行循环翻页抓取时,应在循环体末尾加入
time.sleep(1)等合理的时间延迟,避免短时间内向目标主机高频并发请求,既保护对方服务器正常运作,也能有效防止本机 IP 被加入黑名单。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









