

Python切片怎么包含结束索引的元素
深入解析Python切片如何包含结束索引处的元素,涵盖常规正索引加一技巧、截取到末尾时的省略与None用法、负索引避坑指南及原理机制。
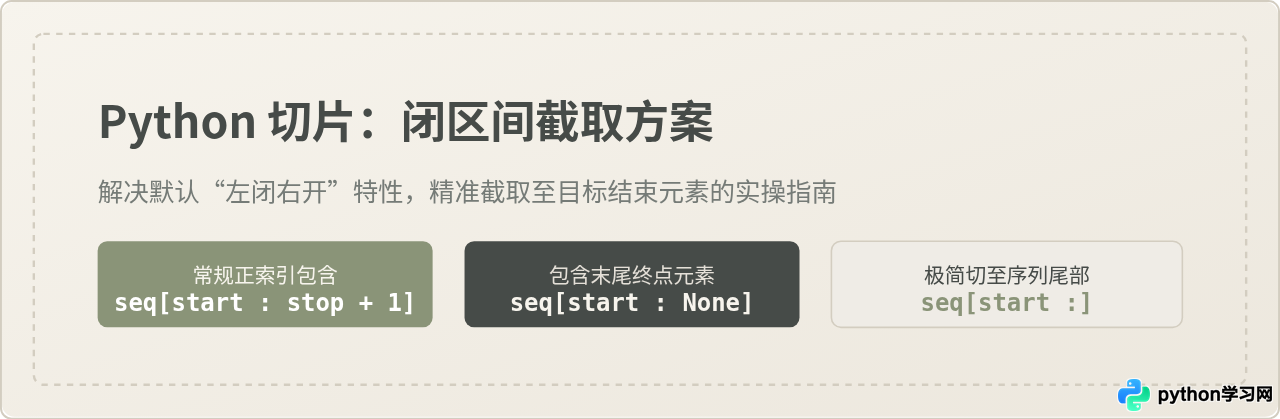
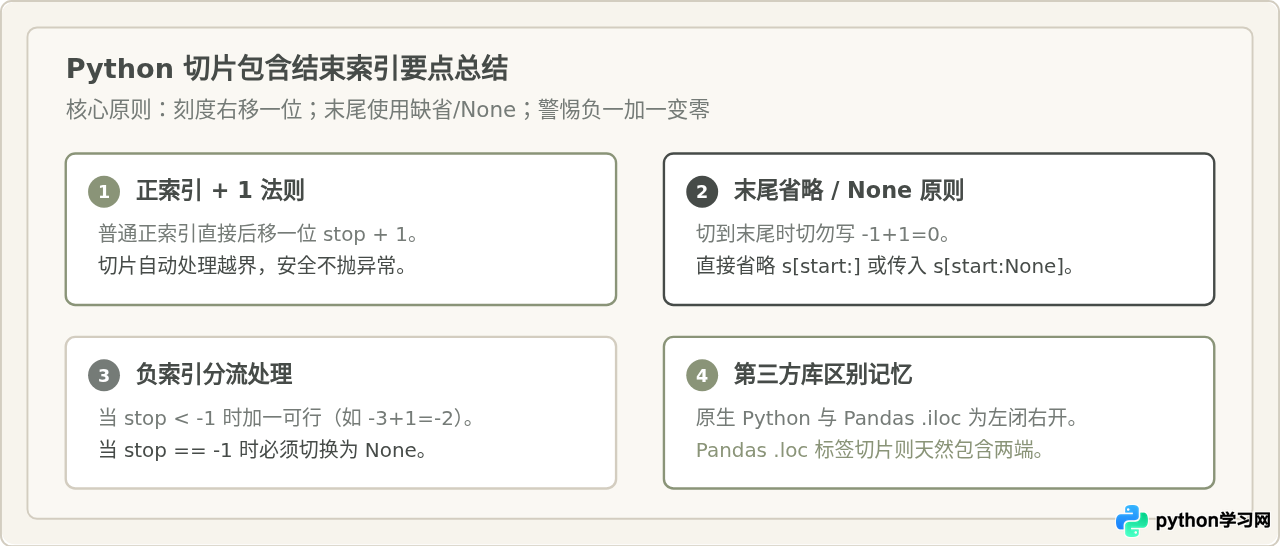
在 Python 中,切片语法 sequence[start:stop] 遵循“左闭右开”规则,即结果包含 start 处的元素,但不包含 stop 处的元素。想要让切片包含结束索引所指向的元素,核心方法是将结束索引后移一位:当目标为普通正索引时,写成 sequence[start:stop + 1];如果目标恰好是序列的最后一个元素,则不能使用负索引加一,而应直接省略结束索引或传入 None,即 sequence[start:] 或 sequence[start:None]。
一、为什么 Python 切片默认不包含结束索引?
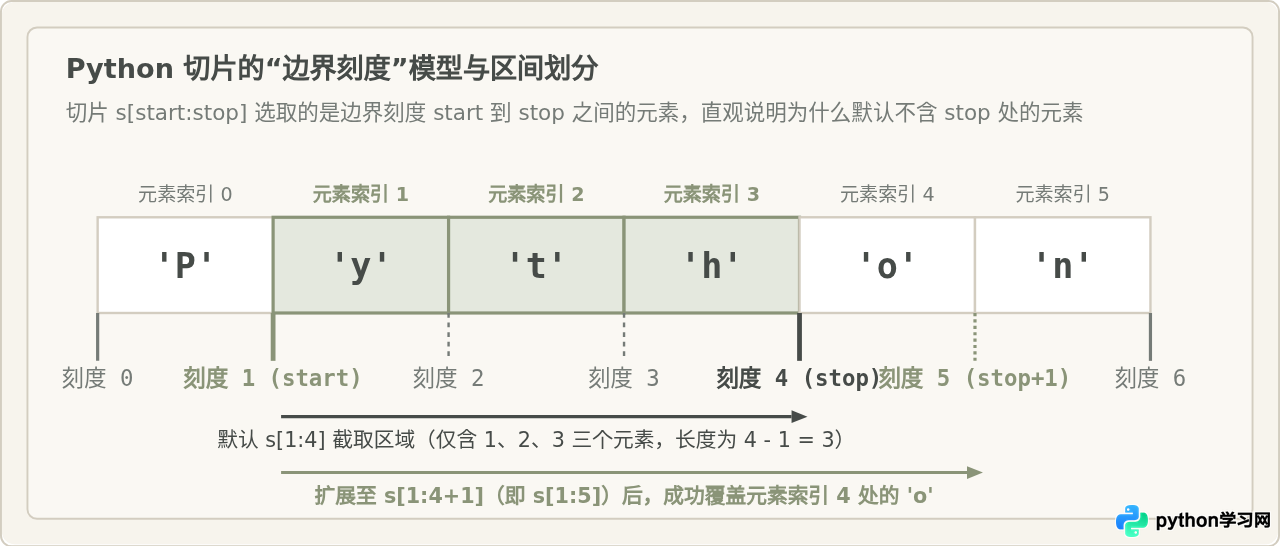
初学 Python 时,很多人容易将切片中的数字理解为“包含第几个到第几个”。但 Python 官方将切片索引设计为元素之间的边界刻度(Fences/Gaps),而非单纯的格子标号。
假设有一个列表 s = ['P', 'y', 't', 'h', 'o', 'n'],索引 0 代表序列最左侧的起点刻度,索引 1 落在第一个元素与第二个元素之间,以此类推。切片 s[1:4] 截取的是刻度 1 到刻度 4 之间的区域,包含的是 s[1]('y')、s[2]('t')、s[3]('h'),而刻度 4 之后的 s[4]('o')自然被排除在外。
这种设计虽然让“想包含右端元素”时需要额外处理,但带来了两大重要的工程优势:
- 切片长度计算直观:当使用
s[start:stop]时,切片返回的元素数量恰好等于stop - start。例如s[1:4]的元素个数正是4 - 1 = 3。 - 序列分割无需重叠或空隙:将序列在某个索引
i处拆分为两半时,前半部分是s[:i],后半部分是s[i:],两部分拼接s[:i] + s[i:]严丝合缝地等于原列表,无需做+1或-1的位移修正。
二、核心操作:实现包含结束索引元素的具体做法
搞清了刻度模型后,包含结束索引处元素的核心逻辑就非常清晰了:将切片的结束刻度向右推进一位。但在具体编写时,需要根据目标索引的具体位置与形式区分处理。
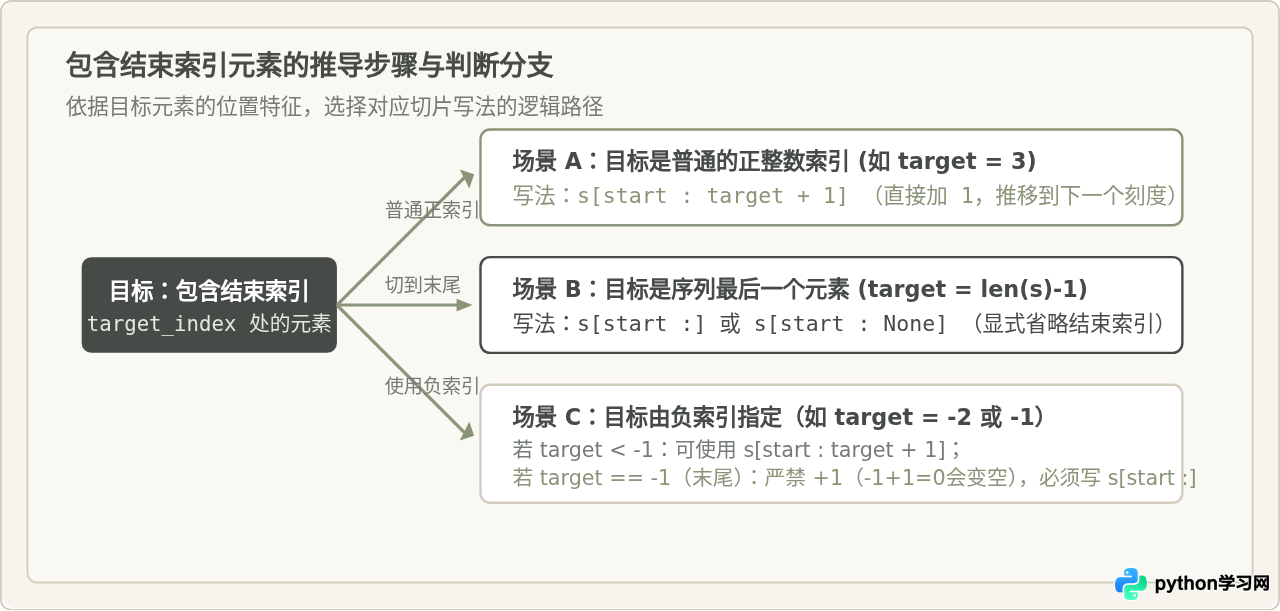
1. 常规场景:直接使用 stop + 1
当目标位置是一个明确的正整数索引时,最标准、直观的做法就是将结束索引加 1。
# 准备一个包含 5 个字符串的列表
fruits = ['apple', 'banana', 'cherry', 'date', 'fig']
# 索引对应: 0:apple, 1:banana, 2:cherry, 3:date, 4:fig

# 目标:获取索引 1 到索引 3 的元素,且必须包含索引 3 处的 'date'
start_idx = 1
end_idx = 3

result = fruits[start_idx : end_idx + 1]
print("示例输出:", result)
# 示例输出: ['banana', 'cherry', 'date']
由于传入切片的 stop 参数是 4,Python 会截取刻度 1 到刻度 4 之间的元素,即索引为 1、2、3 的项,完全符合“包含索引 3”的需求。
2. 边界场景:切片需要包含序列的最后一个元素
如果目标索引恰好是整个序列的末尾元素(例如 end_idx = len(fruits) - 1),继续写 end_idx + 1 依然有效:
# 包含最后一个元素(索引为 4 的 'fig')
result = fruits[2 : 4 + 1]
print("示例输出:", result)
# 示例输出: ['cherry', 'date', 'fig']
但如果代码是以负索引(例如 -1 代表最后一个元素)来指定结束位置,直接套用加一操作就会引发隐藏 Bug。
三、容易混淆的负索引陷阱与边界辨析
这是许多初学者甚至有一定经验的开发者都会遇到的典型陷阱。当试图使用 -1 作为结束索引并包含它时,往往会直觉写成 fruits[start:-1 + 1]。
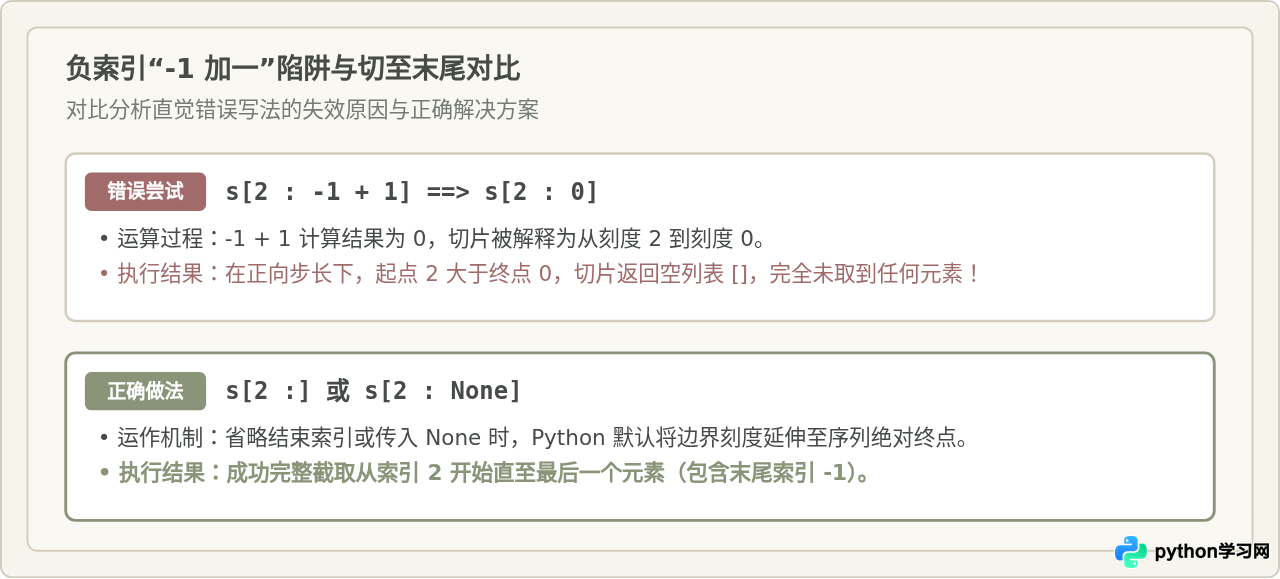
由于 -1 + 1 = 0,代码实际执行的是 fruits[2:0]。在默认步长 step=1 为正数的情况下,切片起点为 2,终点为 0,起点大于终点,Python 会判定该区间为空,直接返回空列表 []。
1. 如果负索引不是倒数第一个(例如 stop = -3,想要包含倒数第三个元素):此时可以安全加一,写成 s[start : -3 + 1](即 s[start:-2])。
2. 如果负索引是倒数第一个(即 stop = -1):切勿使用加一运算,必须使用省略形式 s[start:],或者在动态变量传参时传入 None,即 s[start:None]。
切片越界机制:stop + 1 超出长度会报错吗?
在单元素按索引访问时,如果写 fruits[99],Python 会立即抛出 IndexError: list index out of range。很多人因此担心:如果 stop + 1 大于或等于列表长度,会不会引发程序崩溃?
答案是完全不会。Python 的切片机制对越界具有极高的容错性:
- 如果
stop + 1 > len(sequence),Python 会自动将结束刻度截断至序列的最大有效长度len(sequence)。 - 例如长度为 5 的列表,执行
fruits[2:100]会安全返回索引 2 到 4 的所有元素,不会抛出任何异常。
四、工程实战:封装通用的“闭区间切片”函数
如果需要在代码中频繁进行包含两端索引的切片操作,或者需要动态接收可能为正、负或 None 的结束索引,编写一个专门处理边界的辅助函数是更稳健的做法。
def slice_inclusive(seq, start=0, stop=None):
    """
    对序列进行闭区间切片(两端均包含)
    :param seq: 支持切片的序列对象(list, str, tuple等)
    :param start: 起始索引,默认 0
    :param stop: 结束索引(结果将包含该索引处的元素)
    """
    # 如果不指定 stop,或者 stop 为 None,直接切到末尾
    if stop is None:
        return seq[start:]

    # 如果 stop 为 -1,说明要包含倒数第一个元素,等同于切到末尾
    if stop == -1:
        return seq[start:]

    # 其它普通索引(正整数或小于 -1 的负索引)安全后移一位
    return seq[start : stop + 1]

# 验证不同场景:
data = [10, 20, 30, 40, 50]

print("正索引切片 (包含索引2):", slice_inclusive(data, 0, 2))
# 示例输出: [10, 20, 30]

print("末尾切片 (包含末尾-1):", slice_inclusive(data, 2, -1))
# 示例输出: [30, 40, 50]

print("中间负索引 (包含倒数第二项-2):", slice_inclusive(data, 1, -2))
# 示例输出: [20, 30, 40]
五、全场景速查与总结
为了方便在实际开发中快速选用合适的方法,下表汇总了不同需求下包含结束元素的对应操作:
| 目标场景 | 直观需求 | 正确切片代码 | 关键注意事项 |
|---|---|---|---|
已知具体正索引 k |
包含第 k 个索引的元素 |
s[start : k + 1] |
就算 k+1 超过序列长度也不会报错,会自动截断到末尾。 |
| 包含序列最后一个元素 | 一直取到列表终点 | s[start :] 或 s[start : None] |
不能写 s[start:0];在动态传参场景中传入 None 最为安全。 |
负索引(非末尾,如 -2) |
包含倒数第 2 项 | s[start : -2 + 1] 即 s[start : -1] |
因为 -1 是倒数第 1 项的左边界,正好包进倒数第 2 项。 |
负步长逆序切片(如 step=-1) |
反向切片包含结束索引 0 | s[start : None : -1] 或 s[start : : -1] |
逆向切片到 0 时,若写 s[start:0:-1] 会漏掉索引 0,必须省略 stop。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









