

OpenCode 2.3.2 的 GPT-6.2 缓存修复能降低哪些重复输入?
OpenCode 2.3.2 主要减少的是多步任务里反复发送、却没有命中缓存的系统提示。它将这段提示改为开头的 developer 消息,使相关 Responses 路由从第二步起复用前缀;实际账单变化仍要结合提供方和会话内容判断。
为什么同一段系统提示还会重复计费?
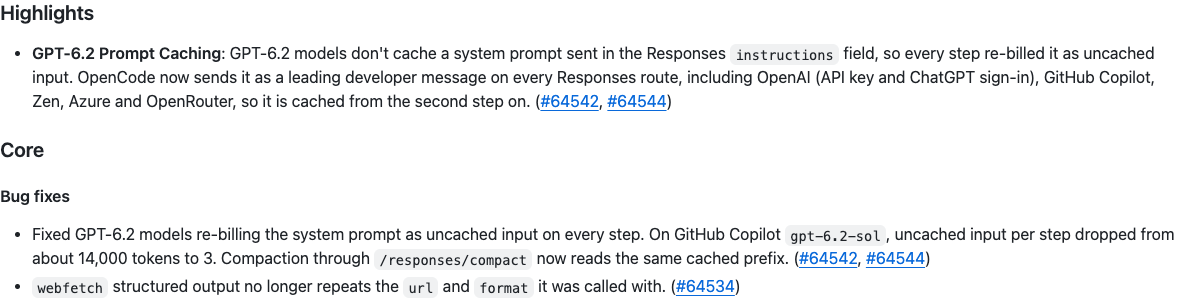
按照本次发布说明,GPT-6.2 对放在 Responses instructions 字段中的系统提示不做缓存。任务执行多个步骤时,提示虽然相同,仍会反复进入未缓存输入。2.3.2 修改了消息排列方式,而不是删掉系统提示或缩减用户任务要求。
修复将提示放到首个 developer 消息中。覆盖范围包括 OpenAI 的 API 密钥、ChatGPT 登录,以及 GitHub Copilot、Zen、Azure、OpenRouter 的相关 Responses 路由。这里的范围限定很重要:它不代表所有模型、所有协议的请求都改用相同缓存策略。
约 14,000 到 3 是哪一部分?
官方示例使用 GitHub Copilot 的 gpt-6.2-sol,报告每步未缓存输入由约 14,000 个令牌降到 3 个。数字针对未缓存输入这一项,不能理解成完整上下文只有 3 个令牌,也不能据此得出所有会话的费用降幅。缓存中的提示仍然存在,其他动态内容与模型输出也没有因此消失。
本次还使 /responses/compact 能读取同一个缓存前缀。对长时间运行的任务而言,压缩与后续步骤的前缀保持一致,是这次修复的一部分。
网页抓取的清理会影响什么?
另一个核心修复是 webfetch 不再在结构化输出中重复 url 和 format。这两个值来自调用输入,移除返回副本可以减少冗余。发布说明并未把它描述为新的网页抓取能力,也没有承诺速度和正文质量提升。
如何判断与自己的任务是否相关?
如果任务会在 GPT-6.2 上持续执行多个步骤,并走相关 Responses 路由,系统提示的重复输入问题就更值得关注。其他模型的用户可以了解变化,但不应直接套用上述示例数字。2.3.2 是正式发行;发布页显示的后续开发提交与该版本分发包应分别看待,不能把开发分支进展当作已经安装的功能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









