

为什么Python list.append()返回None?
深入解析Python中list.append()方法返回None的深层原因、内存模型、常见赋值错误及Python的原地修改设计哲学。
在Python中调用列表的 append() 方法时,该方法默认返回 None,而不是修改后的列表。这是初学者极易踩坑的地方:一旦写出 nums = nums.append(4),原列表变量就会瞬间变成 None。这一行为背后并非疏忽或语言缺陷,而是Python为了保证API一致性与语义清晰度所做出的严谨架构设计——所有就地修改(In-Place Mutation)可变对象内容的方法均返回 None。
一、核心机制:原地修改与返回值规范
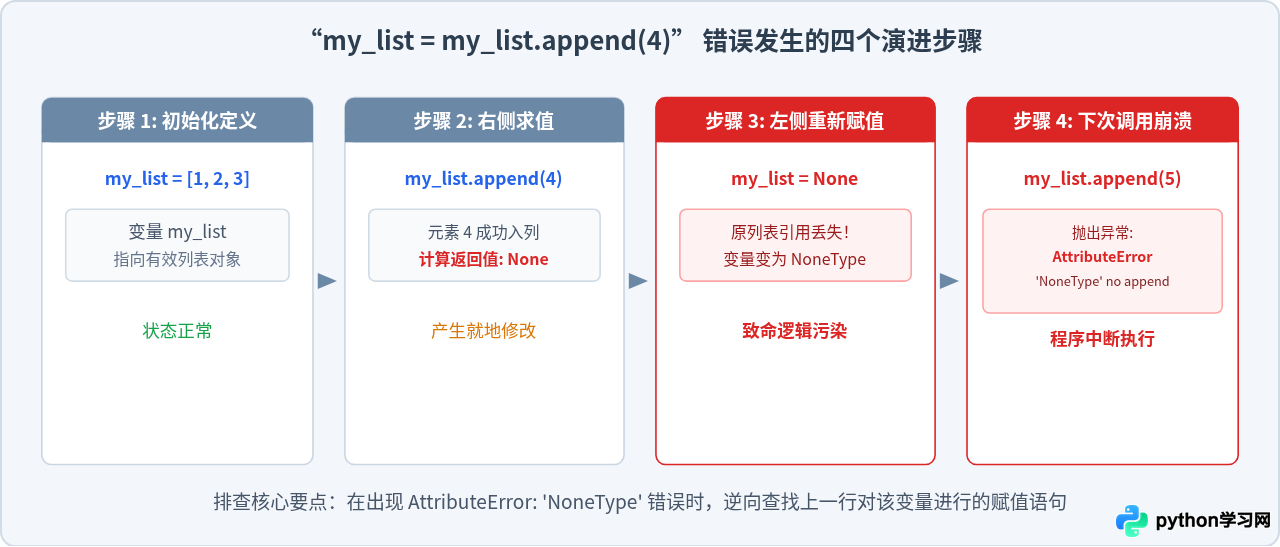
Python中的数据类型分为“可变对象”(如列表 list、字典 dict、集合 set)与“不可变对象”(如整数 int、字符串 str、元组 tuple)。当对不可变对象进行修改时,底层必须分配新的内存空间并返回全新的对象;而当操作可变对象时,方法可以直接在原有内存块上增删元素。
list.append(x) 的职责是把元素 x 直接追加到当前列表的末尾。在执行完这一物理操作后,Python设计者(Guido van Rossum)设定了一个普遍规则:凡是产生就地修改副作用(Side Effect)的方法,都不应返回新列表或自身,而是显式返回 None。这一约定的直接目的是给调用者一个明确信号:该操作已经就地生效,不要期待从返回值中提取结果。
二、最典型的踩坑场景:误将 append() 重新赋值
初学Python时,许多人因为习惯了字符串的链式替换方法(如 s = s.replace("a", "b")),往往会习惯性地写出如下代码:
# 常见错误写法
my_list = [1, 2, 3]
my_list = my_list.append(4)  # 致命错误:append() 返回 None 并覆盖了 my_list

print(my_list)               # 输出: None
my_list.append(5)            # 崩溃: AttributeError: 'NoneType' object has no attribute 'append'
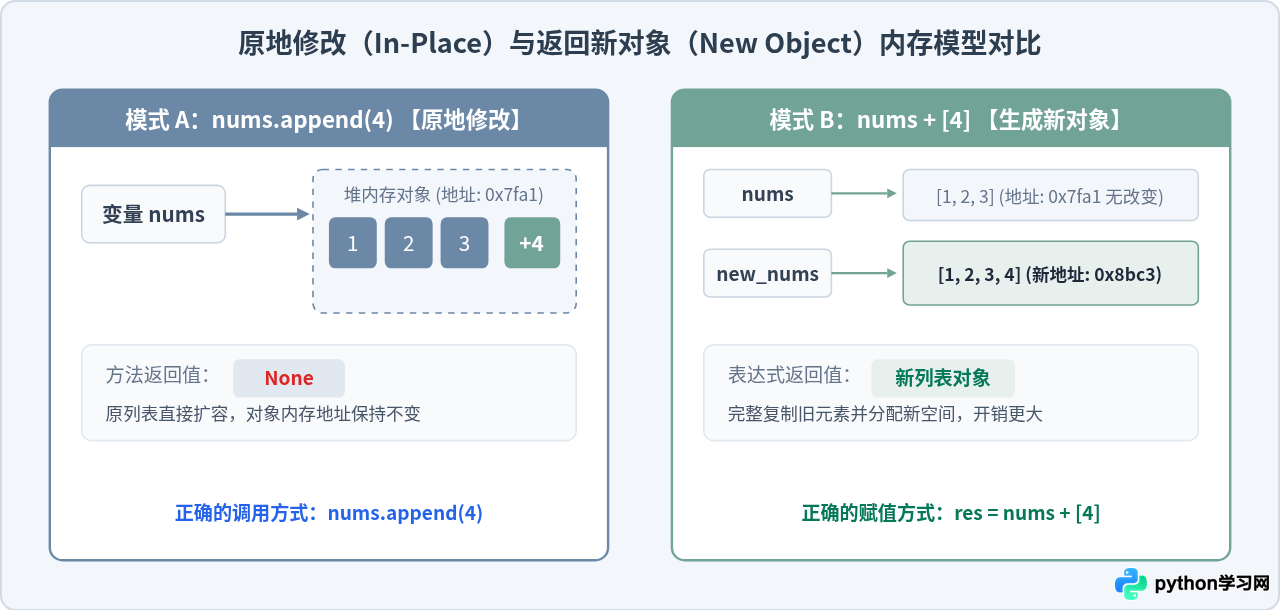
在这段代码中,右侧表达式 my_list.append(4) 先执行,成功将 4 塞入了原列表中;紧接着,该表达式计算出的返回值 None 被赋给了左侧变量 my_list。原列表对象的引用被切断,my_list 指向了单一的 None 对象。当程序后续再次尝试向 my_list 追加数据时,便抛出了经典的 AttributeError 异常。
三、设计哲学:为什么不返回 self?
很多其他编程语言(如 JavaScript 的方法链式调用,或者部分面向对象库的流式接口)喜欢在原地修改后返回对象自身(即 return this),以便支持形如 list.append(1).append(2) 的链式操作。Python 之父 Guido van Rossum 为什么坚定地否定了这种做法?核心原因包含以下三点:
1. 强制区分“原地变动”与“纯函数调用”
在 Python 的设计准则中,一个方法如果对外部传入的对象状态造成了改变(即产生了副作用),它就不应当伪装成一个返回值表达式。返回 None 可以强制开发者将“状态变更语句”独立成行,避免把有副作用的操作嵌套在复杂逻辑中。
2. 避免误导性能预期
如果 append() 返回列表本身,很多初学开发者会误认为该操作“返回了一个包含新元素的全新列表”。这种误解在面对大型列表时会带来毁灭性的隐患——开发者可能毫无戒备地在多处共享列表并随意调用 append(),导致其他引用该列表的模块莫名发生数据同步变更,引发隐蔽的并发与引用污染 Bug。
3. 契合《Python之禅》(The Zen of Python)
《Python之禅》明确提倡:“Explicit is better than implicit(明了胜于晦涩)”。将具有破坏性修改的操作与纯数据加工操作从返回值上进行一刀切式的隔离,使得读代码的人一眼就能看出:这一行代码是在就地改数据,下一行代码是在计算新结果。
四、常见 Python 序列操作行为对比
为了在实际编码中不再混淆,我们需要清晰掌握 Python 内置列表中不同操作的具体行为与返回值特性:
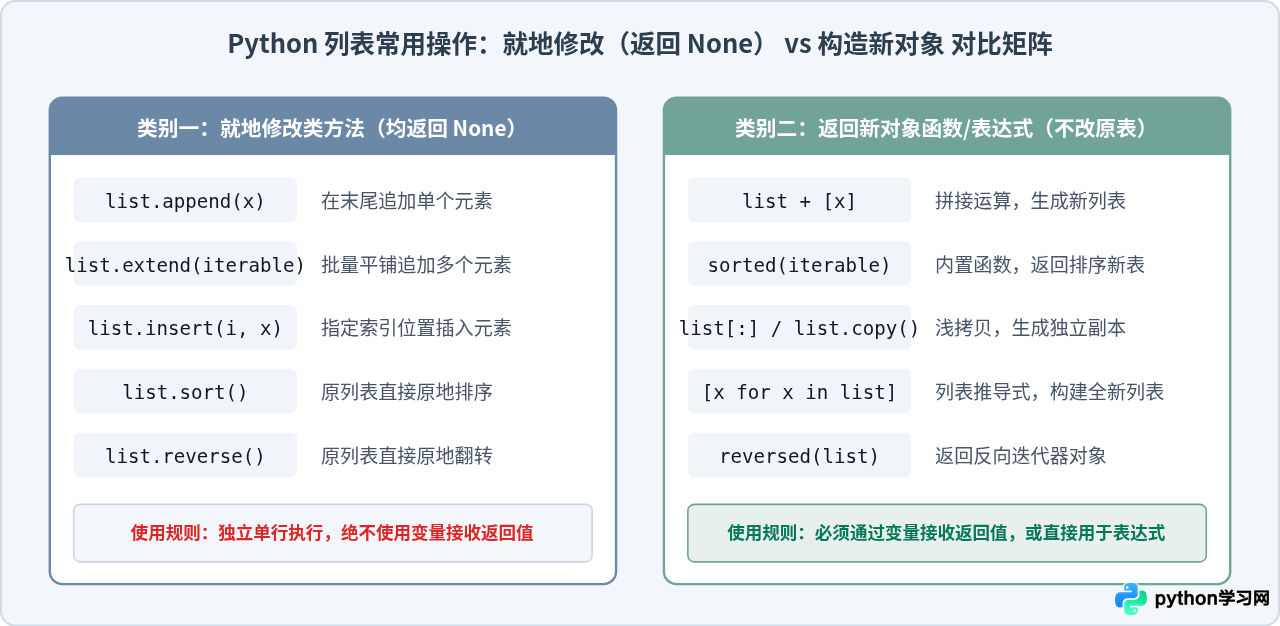
这种设计最直观的例证是排序操作:nums.sort() 是原地修改,返回 None,原列表顺序被打乱;而内置全局函数 sorted(nums) 不修改原列表,而是创建并返回一个排序好的新列表。两个名字一目了然地界定了副作用的有无。
五、实战解决方案与编码决策树
在了解了原理之后,在实际业务编写中如果需要追加元素或获取新列表,应该如何正确选择与实现?请遵循以下三条标准路径:
路径一:只需要单纯追加数据(推荐)
保持原列表对象不变,直接单行调用,绝不进行重复赋值:
items = ["apple", "banana"]
items.append("cherry")   # 正确:就地修改,单行执行
print(items)             # 输出: ['apple', 'banana', 'cherry']
路径二:需要保留原列表,并获取追加后的新列表
此时不能直接使用 append(),而应该使用拷贝或加号拼接:
original = [1, 2, 3]

# 方案 A:使用 + 拼接单元素列表
new_list = original + [4]

# 方案 B:先拷贝,后 append
new_list_b = original.copy()
new_list_b.append(4)

print(original)    # 原列表依然是 [1, 2, 3]
print(new_list)    # 新列表是 [1, 2, 3, 4]
路径三:一次性追加多个元素
如果要追加一个序列(如另一个列表),使用 extend() 同样要注意它是就地修改、返回 None;若想得到新对象,则使用 +:
a = [1, 2]
b = [3, 4]

# 原地追加多个元素(返回 None)
a.extend(b)      # a 变为 [1, 2, 3, 4]

# 合并生成新列表(不修改原列表)
c = [1, 2] + [3, 4]  # c 为 [1, 2, 3, 4]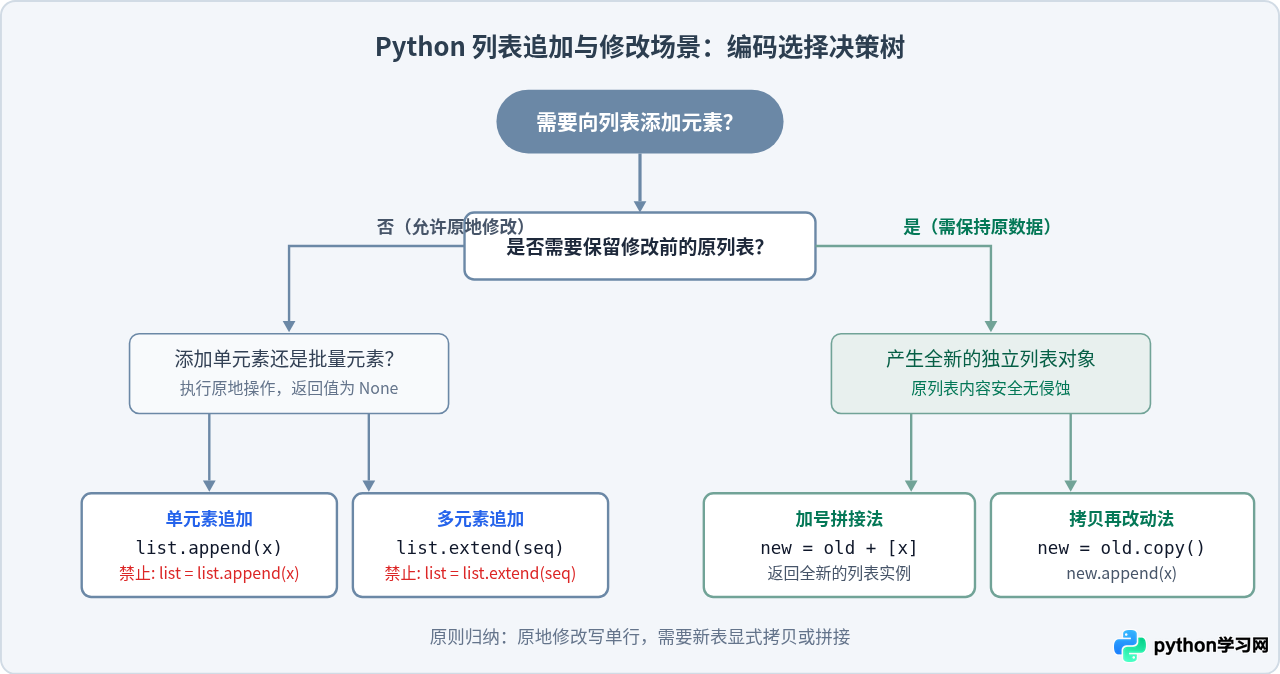
六、总结
回顾核心问题“为什么 Python list.append() 返回 None”:
- 本质原因:
append()是一个就地修改(In-Place)方法,它直接在原有内存地址上扩充列表,不产生新对象。 - 设计准则:Python 约定所有就地修改可变对象状态的方法均统一返回
None,用于提示开发者该操作伴随副作用。 - 防错铁律:在日常编码中,永远不要把
append()、extend()、sort()的执行结果重新赋值给原变量。如果需要新列表,请显式使用+运算符或copy()。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









