

Python for循环遍历列表的基础语法与示例
深入浅出地讲解Python中for循环遍历列表的基础语法、执行机制、实用遍历模式及防踩坑注意事项,配以清晰图解与可运行代码示例。
在 Python 中,遍历列表最基础、最直接的做法是使用 for 变量 in 列表: 语句结构。它会自动从列表的第一个元素按顺序提取到最后一个元素,每提取一个值就赋值给临时变量并执行一次循环体内的代码块,无需程序员手动维护索引计数器。本文将聚焦于这一核心语法,通过执行逻辑拆解、基础与进阶遍历示例以及核心注意事项,帮助你清晰掌握列表遍历的操作方法。
一、核心语法结构与执行机制
很多初学者从 C 语言或旧版 JavaScript 转来时,习惯使用 i = 0; i < len; i++ 的思路去访问列表项。但 Python 的 for 循环本质上是一个迭代机制(Iterator),它的基本语法设计十分精简:
for 临时变量 in 目标列表:
    # 针对当前元素的处理操作
执行语句在这里,目标列表 是一个已存在的序列对象;in 是成员遍历关键字;临时变量 则在每一次迭代开始时,由 Python 解释器自动绑定到当前所指的列表元素上。当最后一个元素被处理完毕后,循环自动终止,控制权移交给后续代码。
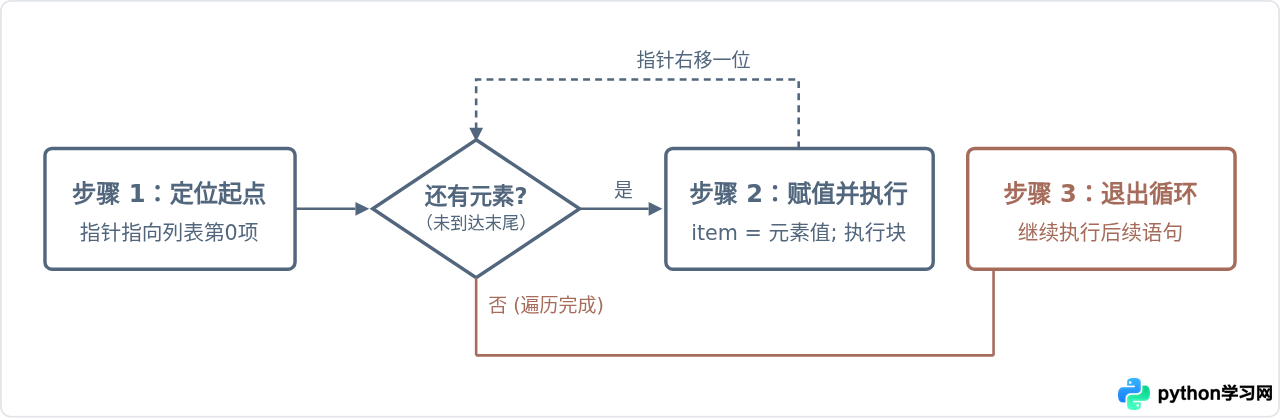
从底层来看,Python 并没有在内存中复制一份列表,而是利用内部指针按照列表项在内存中的偏移顺序依次提取。这种方式无论列表内部存储的是整数、字符串,还是字典等复合对象,访问逻辑都保持一致。
二、基础语法代码示例
掌握语法最直接的途径是运行一段完整代码。以下展示了最直接的单元素访问场景:
# 示例 1:顺序遍历打印水果名称
fruits = ["苹果", "香蕉", "橙子", "葡萄"]

for fruit in fruits:
    print(f"当前水果是:{fruit}")

print("--- 遍历结束 ---")当前水果是:苹果
当前水果是:香蕉
当前水果是:橙子
当前水果是:葡萄
--- 遍历结束 ---
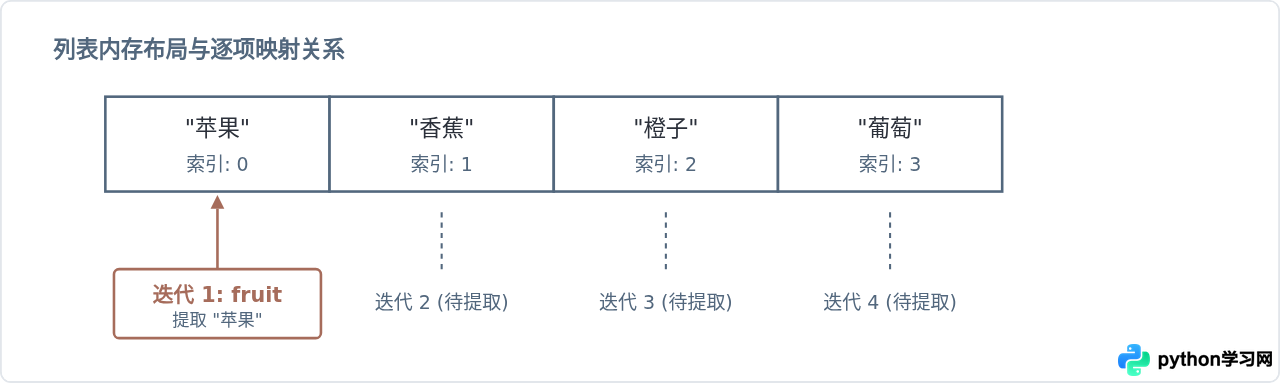
在这个示例中,循环体一共执行了 4 次。变量 fruit 在每次迭代开始时被赋予当前项的值。即使列表包含不同类型的数据,例如 [10, "文本", 3.14, True],语法机制也完全一样,for 循环会逐个接纳对应值并传递给循环体处理。
三、常见应用场景与进阶写法
纯粹打印列表项通常只作为教学演示。在实际代码中,遍历列表往往伴随更具体的业务需求:
1. 同时获取下标与元素:enumerate()
很多时候我们需要知道当前元素处于列表的第几个位置。如果生硬地写 for i in range(len(fruits)): 再用 fruits[i] 取值,虽然可行,但可读性差且不够 Pythonic。推荐使用内置函数 enumerate():
# 示例 2:使用 enumerate 同时获取序号与数据
scores = [92, 85, 78, 96]

for index, score in enumerate(scores, start=1):
print(f"第 {index} 位考生的成绩是:{score}")第 1 位考生的成绩是:92
第 2 位考生的成绩是:85
第 3 位考生的成绩是:78
第 4 位考生的成绩是:96
2. 并行遍历多个列表:zip()
若有两个或多个长度对应或相关的列表,可以用 zip() 把它们打包成元组再进行同步解构:
# 示例 3:同时遍历名字和对应工号
names = ["张伟", "李强", "王芳"]
emp_ids = [1001, 1002, 1003]

for name, emp_id in zip(names, emp_ids):
print(f"员工: {name} | 工号: {emp_id}")员工: 张伟 | 工号: 1001
员工: 李强 | 工号: 1002
员工: 王芳 | 工号: 1003
3. 条件控制:break 与 continue
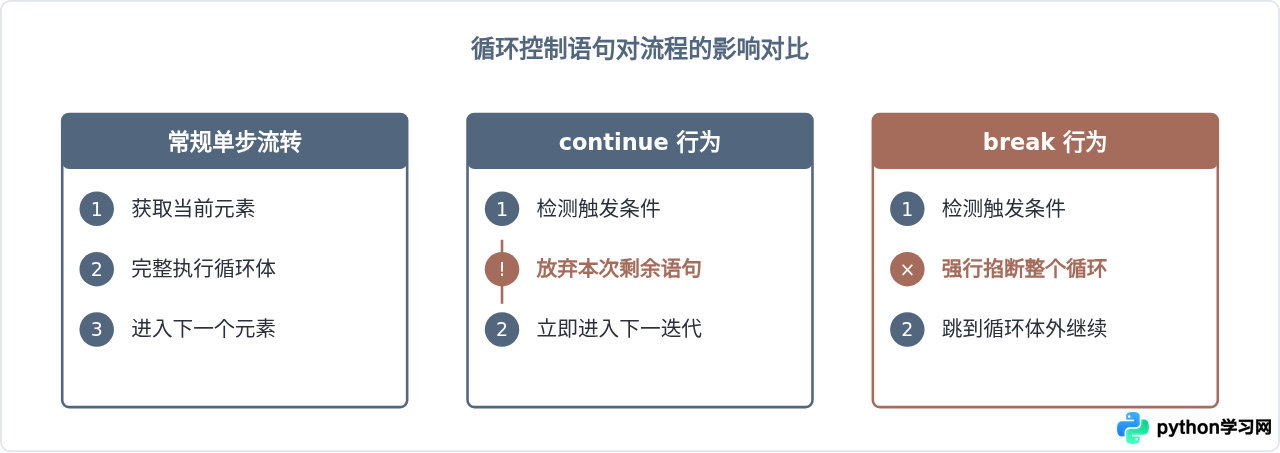
循环体内配合 if 使用 break(彻底跳出当前循环)或 continue(跳过本次剩余代码,直接进入下一次循环),可以灵活筛选目标:
# 示例 4:过滤偶数并截断
numbers = [1, 2, 3, 4, 5, 6, 7, 8]

for num in numbers:
    if num % 2 == 0:
        continue  # 跳过偶数
    if num > 5:
        break     # 超过5则直接终止
print(f"符合条件的奇数: {num}")符合条件的奇数: 1
符合条件的奇数: 3
符合条件的奇数: 5
四、核心注意事项与易错陷阱
在熟练使用 for 循环时,有两个非常高频但容易导致隐蔽 Bug 的场景需要特别注意:
由于
for 循环依赖内部指针位置移动,当你在循环体中使用 list.remove()、list.pop() 或 del 时,列表元素的物理位置会向前填补,而指针仍然按照既定步长往后移,这会导致部分元素被直接“跳过”不处理。
例如,若你写出以下代码:
# 错误示例:边遍历边删除
nums = [10, 20, 20, 30]
for n in nums:
    if n == 20:
        nums.remove(n)
print(nums)  # 预期全清,但实际输出为 [10, 20, 30]!第二个20被遗漏跳过
推荐的正确做法有两种:
- 遍历原列表的浅拷贝: 使用切片
for n in nums[:]:。这样循环在遍历拷贝镜像,实际删除动作作用在原列表上,不会引起迭代漏查。 - 使用列表推导式重构: 直接生成过滤后的新列表
nums = [n for n in nums if n != 20],效率更高且代码更为清晰。
五、知识梳理与场景选择总结
针对不同的列表遍历任务,选择最匹配的语法方式能大幅减少冗余代码。以下为常用方案的决策参考:
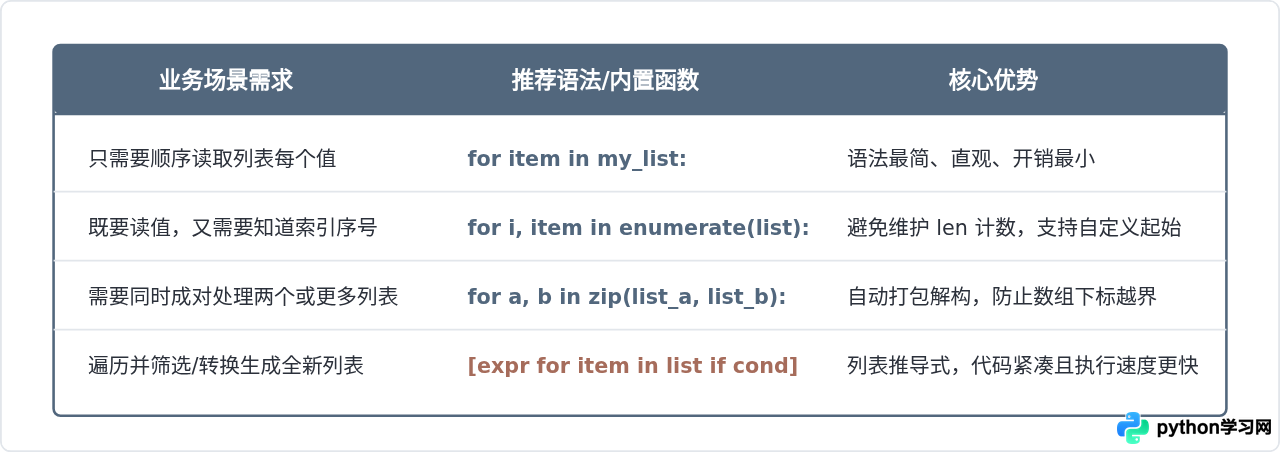
掌握了标准的 for item in list、搭配 enumerate 与 zip 的组合技,并时刻规避在循环内部边遍历边修改原序列的隐患,你就能在几乎所有常规 Python 场景中稳定、优雅地处理列表数据。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









