

Python序列和列表有什么区别?
深入解析Python中序列与列表的核心区别。从抽象协议规范与具体实现的层级关系出发,剖析序列通用操作、列表可变性与内存机制,配合架构图、内存原理图、选型决策流程与全景对比图,帮助读者建立扎实的Python数据结构基础。
一、核心认知:规范接口与具体实现的层次差异
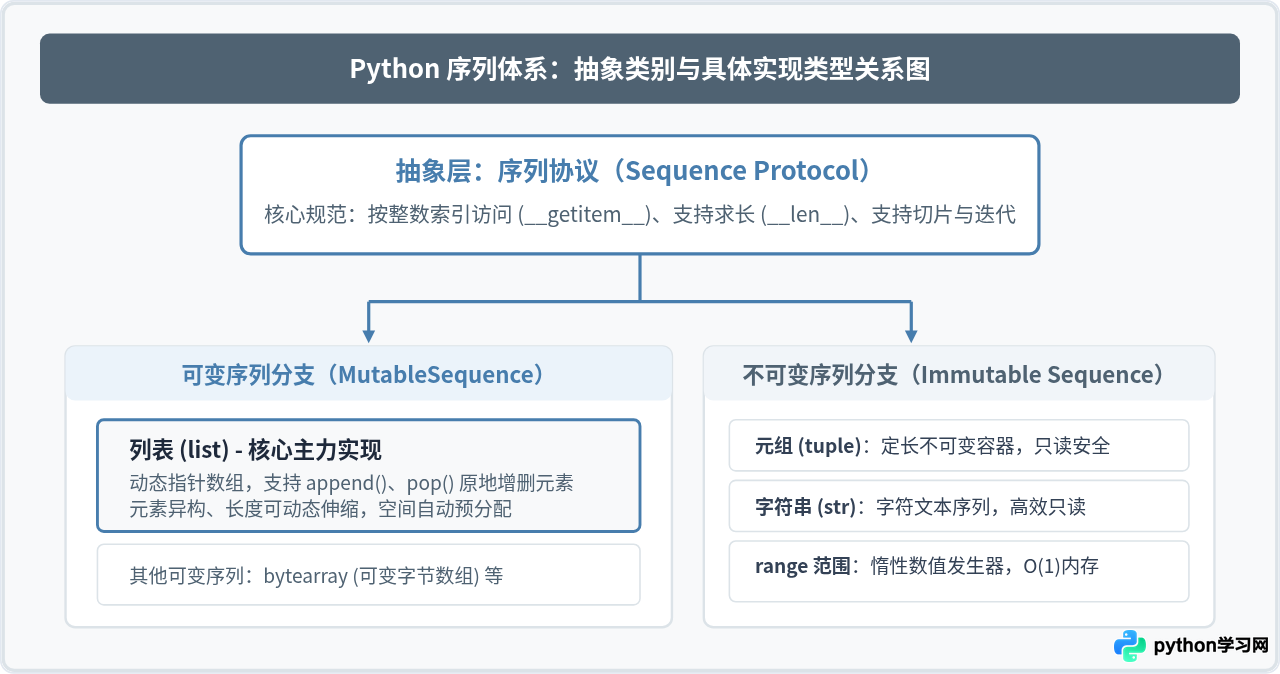
很多初学者容易将序列与列表混为一谈,主要原因是在日常编写代码时,列表(list)是出现频率最高的序列容器。但从 Python 语言的体系设计来看,二者处于完全不同的维度:
- 序列(Sequence)是抽象概念:它规定了“只要一个对象能够通过连续的整数下标访问元素、可以计算元素个数、支持切片与遍历”,这个对象就属于序列。序列本身不直接存储数据,而是一套行为协议。
- 列表(List)是具体类型:它是根据序列协议打造的一个通用、有序、可原地修改(Mutable)的具体数据结构。你可以直接使用
[]或list()实例化一个列表并往里面存取数据。
二、序列通用的基础能力与底层协议
既然序列是一种协议规范,只要一个对象属于序列,它就必然具备统一的接口规范。在底层,序列主要依赖 Python 对象的两个魔法方法:__len__() 提供容器大小,__getitem__() 提供基于整数下标的随机访问。
所有序列类型(无论是列表、元组、字符串还是 range)都天然支持以下通用操作:
- 整数索引访问:支持正向由
0到n-1寻址,以及反向由-1到-n倒序寻址。 - 切片操作(Slicing):通过
seq[start:stop:step]截取局部序列。 - 成员测试:通过
in和not in运算符检查某元素是否存在于序列中。 - 拼接与重复:支持用
+拼接两个同类序列,或用*进行序列重复展开。 - 聚合统计:支持
len()测长、count()计数、index()查找首个索引,以及min()、max()极值获取。
# 示例:序列通用的操作在不同具体类型中的一致表现
sample_list = [10, 20, 30, 40]
sample_tuple = (10, 20, 30, 40)
sample_str = "1234"

# 1. 索引与负索引访问
print(sample_list[0], sample_tuple[-1], sample_str[1])  # 输出: 10 40 2

# 2. 切片操作
print(sample_list[1:3])   # [20, 30]
print(sample_tuple[1:3])  # (20, 30)
print(sample_str[1:3])    # "23"

# 3. 成员判定与迭代
print(20 in sample_list)  # True
print("2" in sample_str)  # True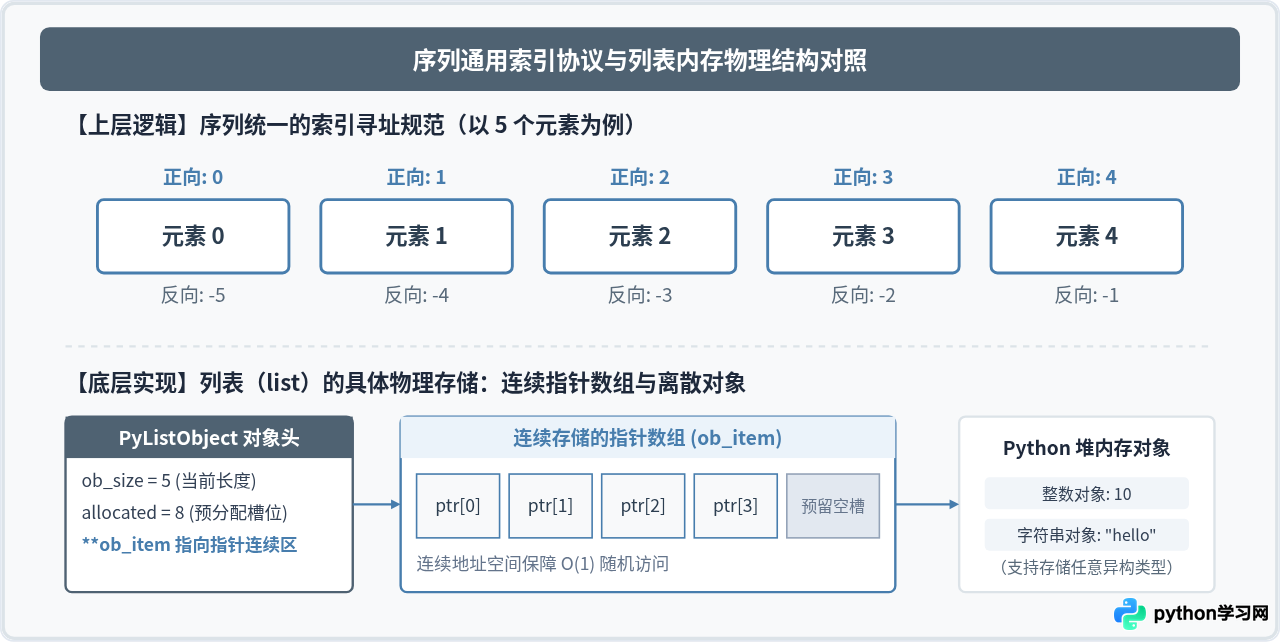
三、列表的独有特性:可变性与动态数组实现
明确了序列的通用性之后,我们再来看列表独特的个性。列表是 MutableSequence(可变序列)的代表,它的两大关键特征决定了其应用场景:
1. 原地修改(In-place Mutation)
不可变序列在修改时只能创建新的对象(产生新的内存分配),而列表允许直接在现有对象空间上对数据进行增、删、改:
- 增加元素:
append(x)在尾部追加、insert(i, x)在指定位置插入、extend(iterable)批量扩展。 - 删除元素:
pop()弹出末尾或指定索引项、remove(val)移除首个匹配值、clear()清空所有项。 - 原地排序与逆序:
sort()可以就地对列表元素排序,无需重新分配容器内存。
2. 动态扩容机制(Over-allocation)
为了保证 append() 操作具有平摊常数级时间复杂度(平摊 $O(1)$),Python 列表并不是“存一个申请一个空间”,而是采用了预分配动态数组策略。当内部容量不足时,会按照特定增长比率(约为原容量的 1.125 倍并向上对齐)一次性申请一块更大的连续内存,并将现有指针迁移过去。这种机制赋予了列表极高的追加效率。
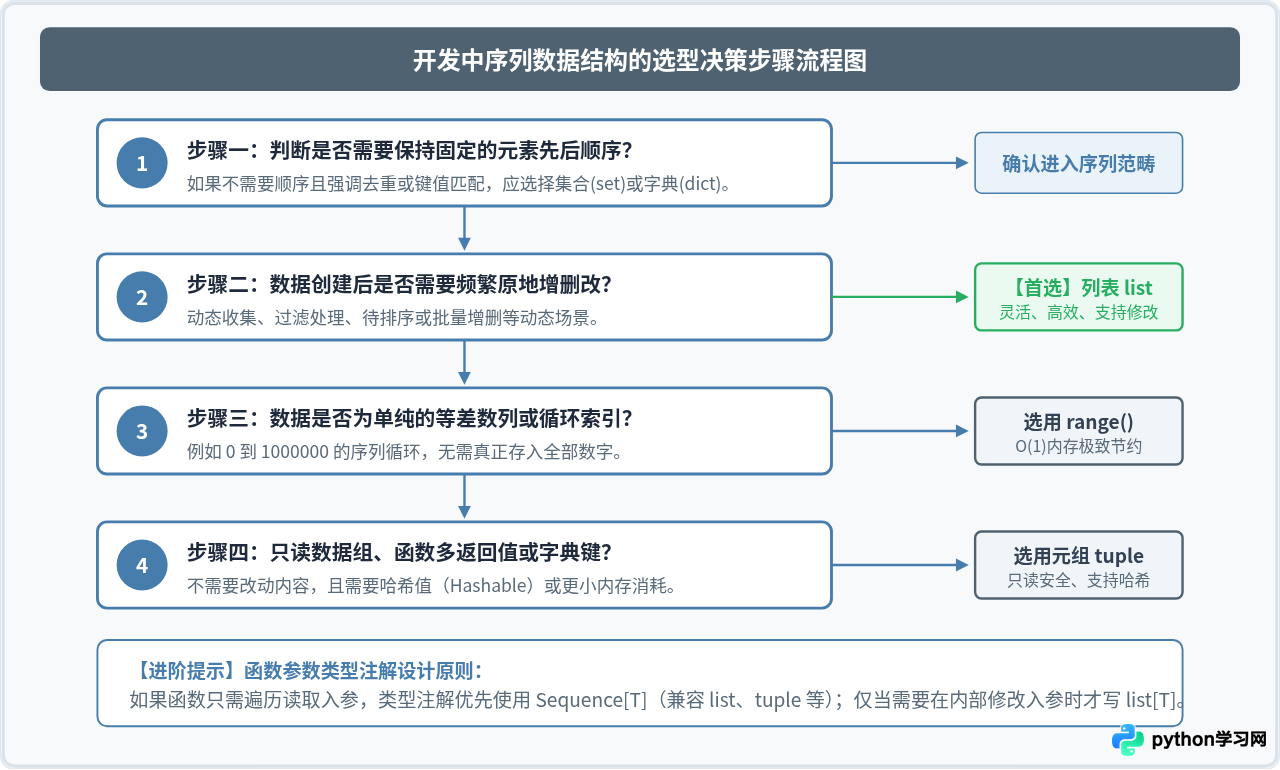
四、开发选型决策:如何判断何时使用列表?
在编写实际程序时,面对不同类型的有序数据,应当如何挑选合适的数据结构?下面给出一套标准操作决策路径:
五、开发中极易混淆的常见误区与避坑指南
在实际编码中,因忽视“序列是协议、列表是实体”这一事实,容易引发以下两类典型缺陷:
误区一:函数入参过度限定为列表类型(类型提示过窄)
很多开发者在编写只读遍历函数时,习惯于标注参数为 list:
# 不推荐写法:限制了入参只能是列表
def calculate_total(items: list[float]) -> float:
    return sum(items)

# 此时若传入元组或自定义序列,静态类型检查器(如 Mypy)会报警
data = (1.5, 2.8, 3.7)
calculate_total(data)  # 报类型不匹配警告

# 推荐写法:面向协议编程,使用 collections.abc.Sequence
from collections.abc import Sequence

def calculate_total_robust(items: Sequence[float]) -> float:
return sum(items) # 完美接受 list、tuple、range 等所有序列类型!Sequence),出参尽量明确(面向具体类型如 list)。
误区二:误将列表当作默认参数引发的可变对象陷阱
这是 Python 经典陷阱之一。因为列表是可变对象,在函数定义时创建的默认列表会在所有调用间共享:
# 错误示例:默认参数使用了可变列表
def add_task(task_name: str, task_list: list = []):
    task_list.append(task_name)
    return task_list

print(add_task("测试 A"))  # ['测试 A']
print(add_task("测试 B"))  # 变成了 ['测试 A', '测试 B']!

# 正确示例:使用 None 并在函数体内按需初始化
def add_task_safe(task_name: str, task_list: list = None):
    if task_list is None:
        task_list = []
    task_list.append(task_name)
    return task_list
六、序列与列表全维度对比总结
最后,我们将 Python 序列与列表在各个核心维度的特性进行全景对照归纳:
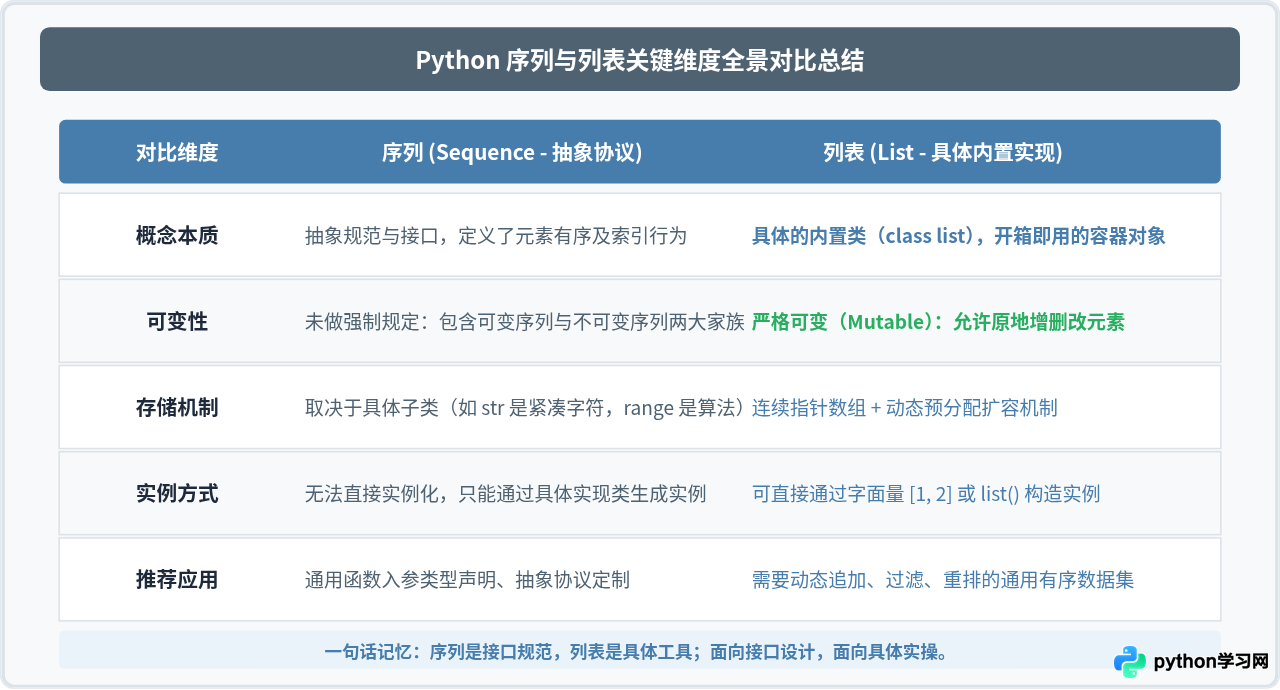
掌握了这一层关系,在后续的 Python 学习与项目开发中,就能更准确地选择合适的数据容器,写出类型兼容度更高、运行效率更优的代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









