

Python切片中的双冒号怎么设置步长?正负步长效果解析
深入解析Python切片语法中双冒号设置步长的具体机制,包括start:stop:step各参数默认规则、正负步长的移动方向与边界判定,以及序列反转与跳跃采样的常见应用。
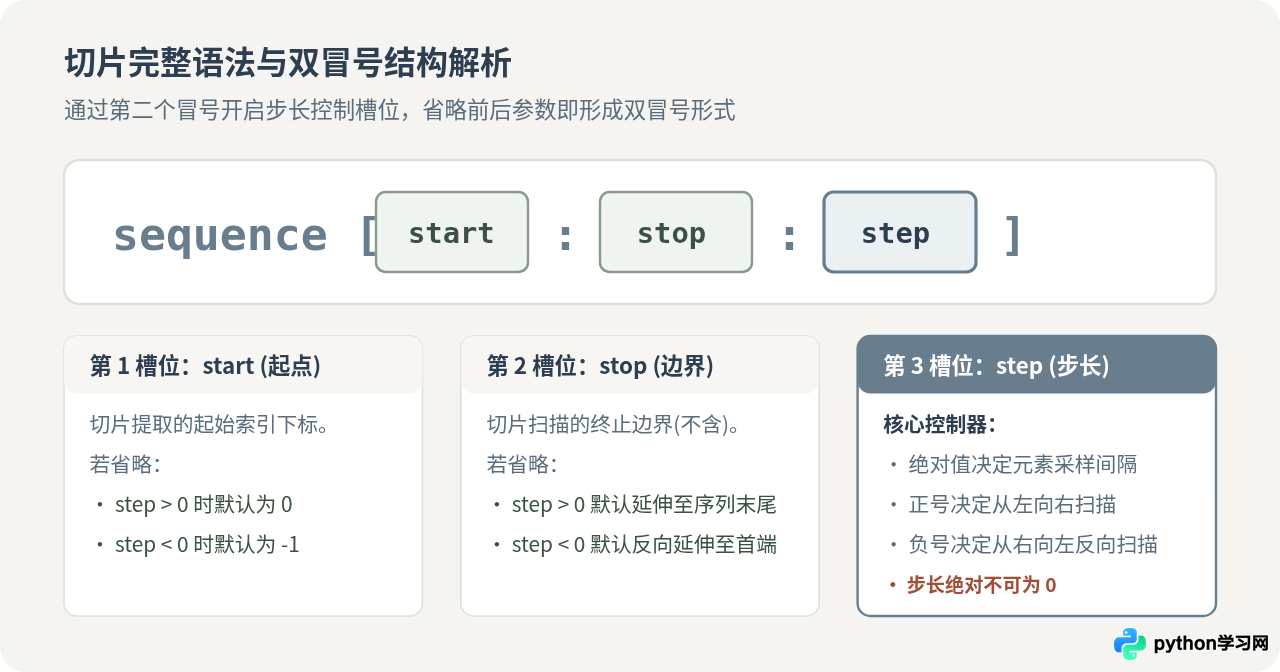
sequence[start:stop:step]。当开发者省略中间的结束位置参数 stop,或者同时省略 start 与 stop 时,中括号内就会连续出现两个冒号(如 sequence[::step] 或 sequence[start::step])。第二个冒号之后的位置专门用于设置“步长”(step)。步长不仅决定了每次提取元素跨越的间隔,其正负号还直接控制切片的扫描方向:正步长从左向右提取,负步长从右向左逆向提取。
一、双冒号语法的形成与参数解析
初学 Python 切片时,最常见的是单冒号写法 s[1:5],它包含两个槽位:起始索引 start 和结束索引 stop。切片机制支持第三个参数,即步长 step。为了向解释器传达第三个参数,Python 使用第二个冒号作为分隔符:
# 标准三参数格式
sequence[start:stop:step]

# 双冒号省略格式(同时省略 start 与 stop)
sequence[::step]

# 保留起始位置,省略结束位置
sequence[start::step]
当省略参数时,Python 会自动应用默认值。默认值并非固定不变,而是由 step 的正负号动态决定:
- 正步长模式(step > 0):
start默认为序列开头(索引0),stop默认为序列末尾之后(切片覆盖到最后一个元素)。 - 负步长模式(step < 0):
start默认为序列末尾(索引-1),stop默认为序列最左侧元素之前(切片反向覆盖到索引0)。
二、正步长(step > 0)的具体设置与执行步骤
当步长设置为正整数时,切片扫描游标自左向右递增移动。每次提取当前索引处的元素后,将当前索引值增加 step,直到索引达到或超过 stop 为止。
1. 全序列等距抽样:sequence[::step]
若希望在整段序列中隔项采样,省略 start 与 stop 是最简洁的书写方式。例如设置 step=2,Python 会从索引 0 开始,依次提取索引 0、2、4、6 处的元素:
numbers = [10, 20, 30, 40, 50, 60, 70, 80]

# 每隔一个元素提取一次(提取偶数索引位)
even_indices = numbers[::2]
print(even_indices)2. 指定起点的正步长抽样:sequence[start::step]
如果需要提取奇数索引项,只需显式将 start 设置为 1,其余边界保持默认:
# 从索引 1 开始,每隔 2 项提取一次
odd_indices = numbers[1::2]
print(odd_indices)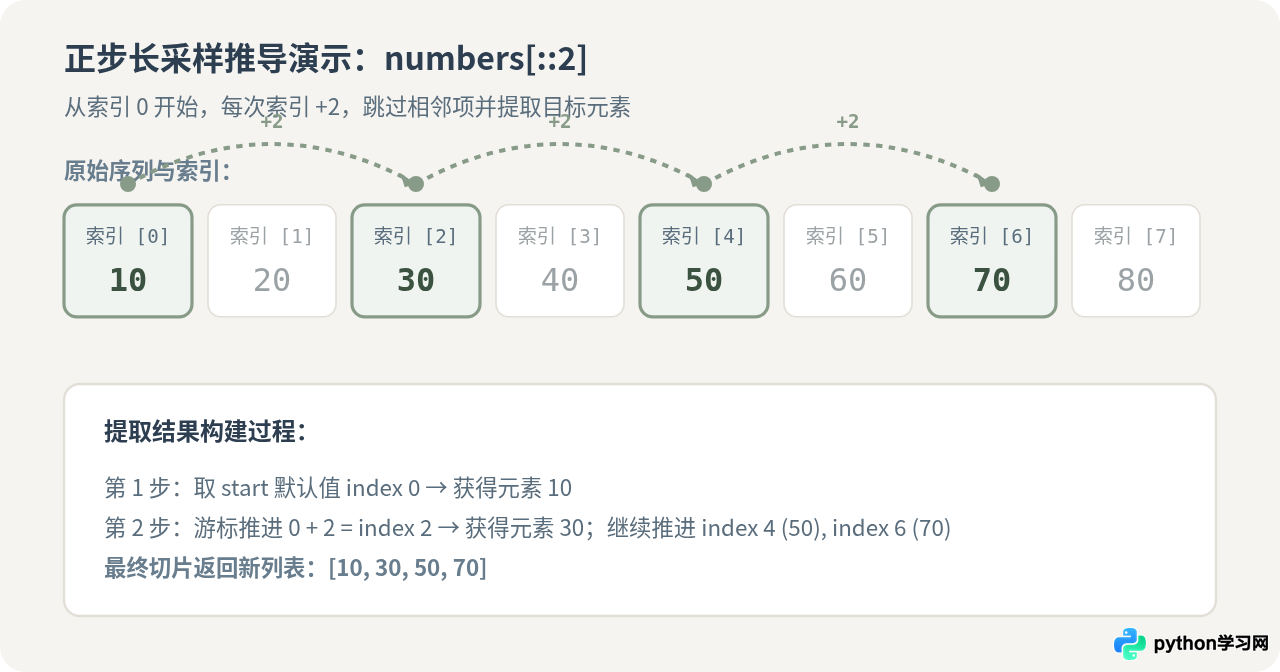
三、负步长(step < 0)的反向机制与边界陷阱
当步长设置为负数时,Python 的内部切片游标会彻底反转扫描方向,从序列右端向左端(索引递减方向)前进。
1. 经典序列反转:sequence[::-1]
在日常开发中,sequence[::-1] 是反转列表或字符串最地道、最高效的写法之一。
word = "Python"
reversed_word = word[::-1]
print(reversed_word)
为什么 [::-1] 能够完整反转序列?因为当 step = -1 时,start 隐式生效为最后一个元素(index = -1),而 stop 隐式生效为最前端元素之前的位置。游标逐个向左移动 1 位,从而遍历整条序列。
2. 显式指定 start 与 stop 时的方向冲突陷阱
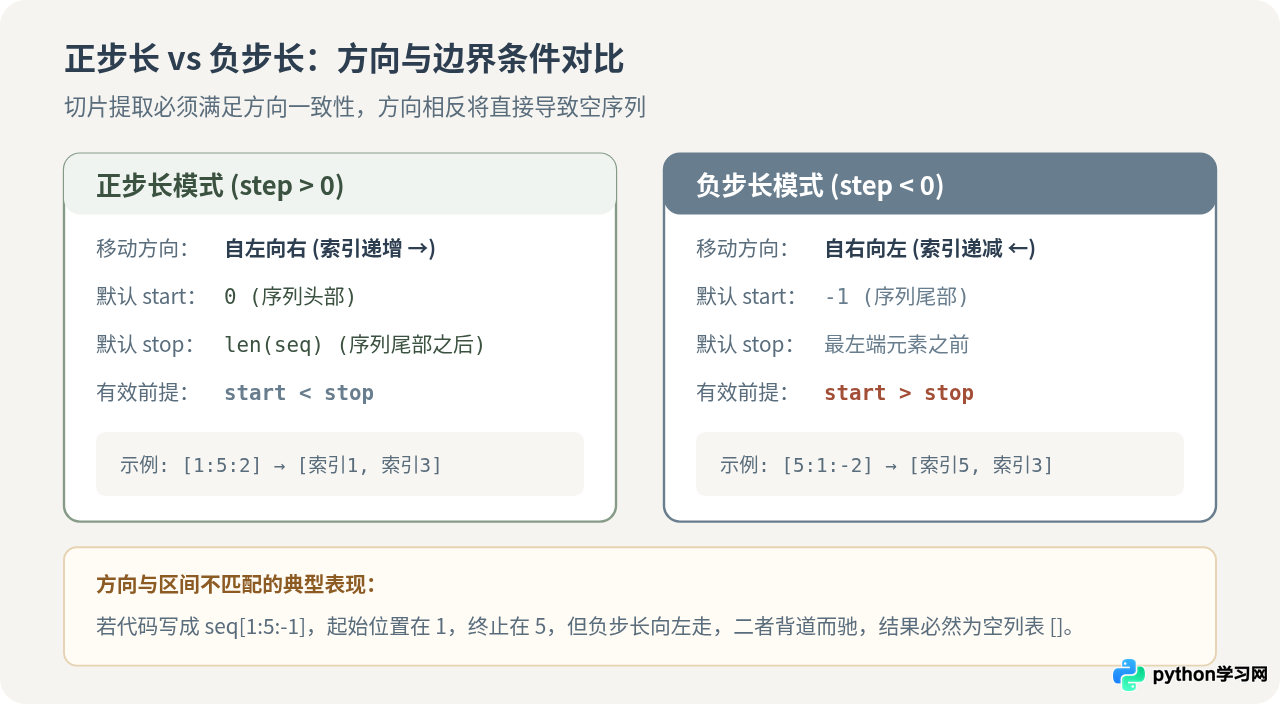
当使用负步长且显式给出了 start 和 stop 时,开发者极易陷入逻辑误区。必须牢记:只要 step 为负,切片就只能从较大索引走向较小索引(start 必须大于 stop)。
items = ["A", "B", "C", "D", "E", "F"]

# 正确写法:从索引 4 向左扫描到索引 1(不含索引 1)
correct_slice = items[4:1:-1]
print(correct_slice)

# 常见错误:希望倒序,却写了 start < stop
wrong_slice = items[1:4:-1]
print(wrong_slice)避坑提示:在 items[1:4:-1] 中,起始位置是索引 1,步长要求向左移动,但终止边界 4 位于起始位置的右侧。游标向左永远无法触及右侧的终点,因此 Python 直接返回空序列 [],而不会报错。
四、双冒号设置步长的核心规则总结表
为了在日常编写代码时快速检索,下表归纳了双冒号切片在不同参数组合下的行为表现:
| 写法格式 | 实际等价形式 | 步长值 | 执行效果说明 |
|---|---|---|---|
s[::] 或 s[:] |
s[0:len(s):1] |
+1 | 完整浅拷贝序列,顺序不变 |
s[::2] |
s[0:len(s):2] |
+2 | 从第 1 项开始,每隔 1 项提取(提取所有偶数索引项) |
s[1::2] |
s[1:len(s):2] |
+2 | 从第 2 项开始,每隔 1 项提取(提取所有奇数索引项) |
s[::-1] |
s[-1:-(len(s)+1):-1] |
-1 | 整条序列完全反向逆序提取 |
s[::-2] |
s[-1:-(len(s)+1):-2] |
-2 | 从最末项开始,反向隔项提取 |
s[start:stop:-1] |
需满足 start > stop |
-1 | 在指定区间内逆向截取片段,区间左闭右开 |
五、常见错误与使用注意事项
在使用双冒号切片时,有两个最关键的语法与逻辑边界需要注意:
1. 步长绝对不能设置为 0
切片步长代表每次前进的位移,若位移为 0,程序将陷入死循环。因此 Python 在语法设计上直接禁止 step = 0,一旦传入会立即抛出 ValueError:
data = [1, 2, 3]
# 尝试将 step 设置为 0
result = data[::0]2. 切片操作生成的是新对象(浅拷贝)
切片操作无论是正步长还是负步长,都会返回一个新的容器对象。对于不可变对象(如字符串、元组),切片是安全的只读操作;对于可变对象(如列表),切片是浅拷贝(shallow copy)。如果列表中包含嵌套列表或字典,修改切片中的嵌套元素仍然会影响原列表。
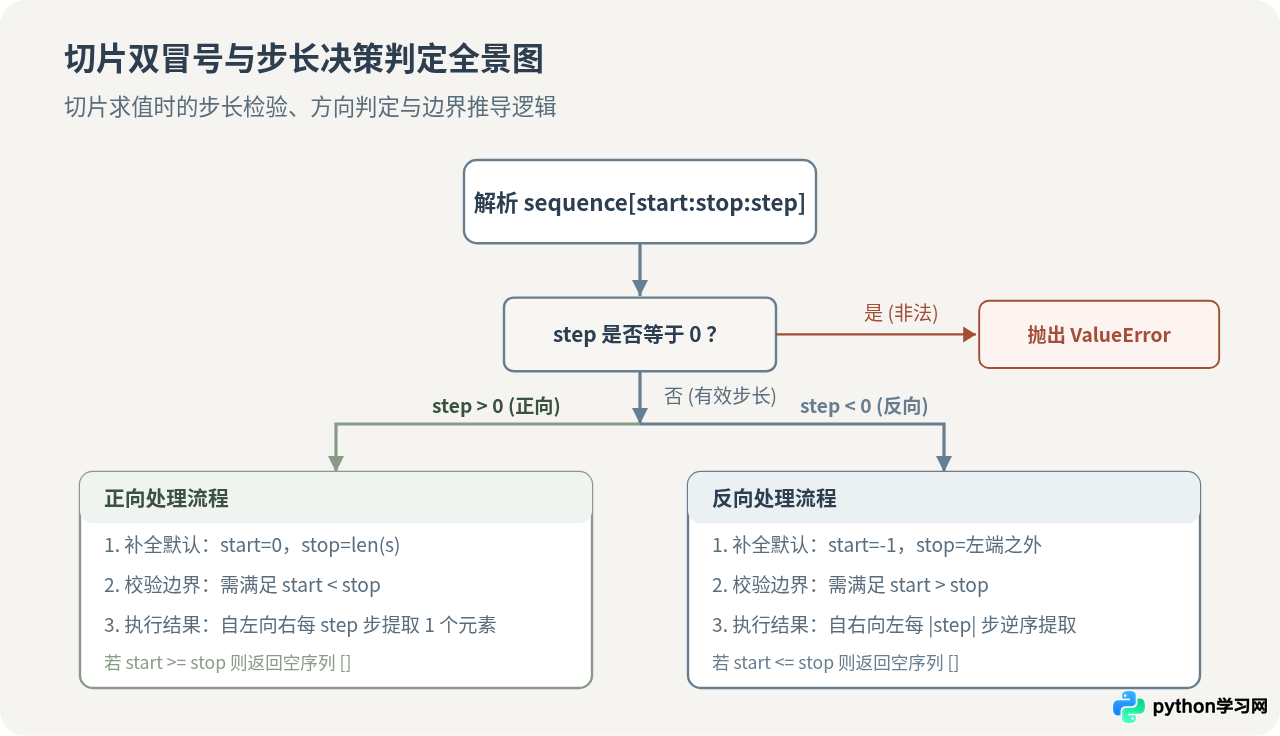
总结而言,Python 切片中的双冒号并不是特殊运算符,而是通过连续放置两个冒号省略了 stop 参数、直接指向第三个参数 step 的简写方式。设置步长时,只要记住“正步长向右、负步长向左、步长不能为零、区间顺应方向”这四条准则,就能自如运用 [::2]、[1::2] 以及 [::-1] 完成各类序列抽样与逆序需求。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









