

Python数据分析完整实战流程:从数据获取、清洗到洞察输出
系统梳理Python数据分析的完整实战闭环,涵盖数据采集提取、脏数据清洗转换、指标建模探索与业务洞察输出的端到端操作步骤、代码规范与架构设计。
数据分析不是孤立的代码练习,而是一套将零散业务事实转化为决策依据的技术流水线。本文以一份典型零售电商业务场景为样本,梳理从多元数据提取、结构化清洗治理、探索性统计建模到最终产出业务洞察报告的标准化闭环,提供工业界通用的执行框架与工程参考。
一、全流程全景拓扑与阶段划分
在真实业务工程中,数据分析的工作量通常呈现“前沉后轻”的倒金字塔结构:60%至70%的精力消耗在数据源接入、脏数据清洗与特征重构上,探索建模与分析报告则建立在前期治理后的坚实底座之上。任何在初期被忽视的空值、格式偏差或统计口径不一致,都会在后续的聚合计算中形成滚雪球式的系统性误差。
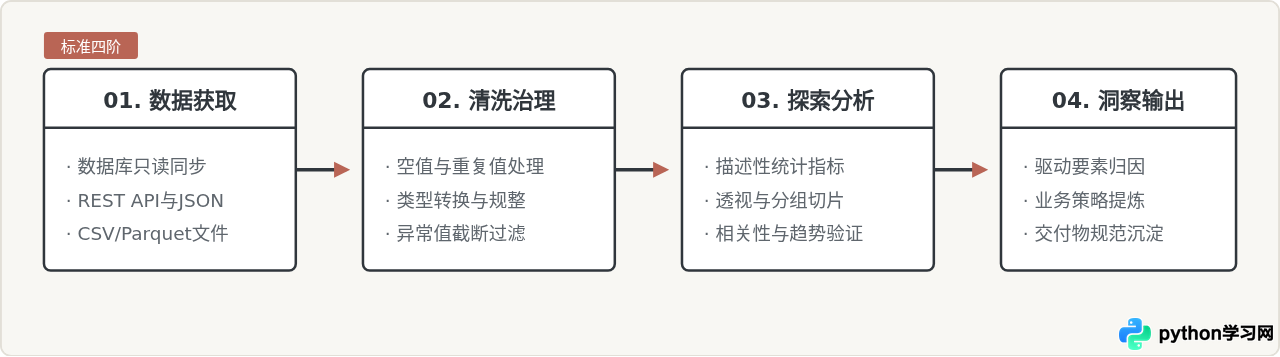
整个数据分析实战体系可拆解为四大不可逆的核心工程阶段:数据接入层(Ingestion)解决物理源到内存对象的映射;清洗治理层(Sanitation)解决质量与一致性问题;探索分析层(Exploration)提炼多维交叉指标;业务洞察层(Insight)完成从指标波动的归因到行动策略的收敛。
二、阶段一:多源数据的高效安全获取
数据分析的第一道关卡是获取具有代表性与合法性的数据集合。实际生产环境中,分析师面对的极少是干净单一的本地表格,通常是关系型业务库(如PostgreSQL、MySQL)、数据仓库只读副本,或外部接口。
直接在生产库执行复杂聚合查询是严重违背架构安全规范的行为。标准做法是:通过只读账号建立数据库连接,仅抽取分析周期所需的字段与时间窗口,落入内存对象或分析缓存池。
import pandas as pd
import sqlalchemy as sa

# 建立只读数据库引擎连接
DATABASE_URL = "postgresql+psycopg2://reader_user:secure_pwd@db.internal:5432/retail_dw"
engine = sa.create_engine(DATABASE_URL, pool_recycle=3600)

# 仅抽取目标分析区间字段,避免 SELECT * 拖垮网络带宽与内存
extract_query = """
SELECT
    order_id,
    user_id,
    order_timestamp,
    gross_amount,
    discount_amount,
    device_type,
    user_city
FROM dw_orders
WHERE order_timestamp >= '2026-01-01' AND order_timestamp < '2026-07-01'
  AND order_status IN ('COMPLETED', 'SHIPPED')
"""

# 分块读取策略应对大容量数据,常规量直接构造DataFrame
try:
    df_raw = pd.read_sql(extract_query, con=engine)
    print(f"数据抓取成功,初始维度: {df_raw.shape[0]} 行, {df_raw.shape[1]} 列")
except Exception as e:
    print(f"数据加载终止,错误追踪: {e}")
raisepd.read_sql 中传入 chunksize 参数进行流式批处理,或者在数仓端提前完成初步预聚合,切忌在单机环境硬加载数千万行宽表。
三、阶段二:结构化数据清洗与形态治理
原始数据永远是充满噪声的。字段中可能包含全角空格、乱码时间戳、退款导致的负数金额、爬虫刷单带来的极端离群值,以及由于跨表关联产生的未匹配空值。这一步的目标是将松散的粗糙表转化为严格符合数学统计要求的干净状态。
1. 缺失值排查与处理策略
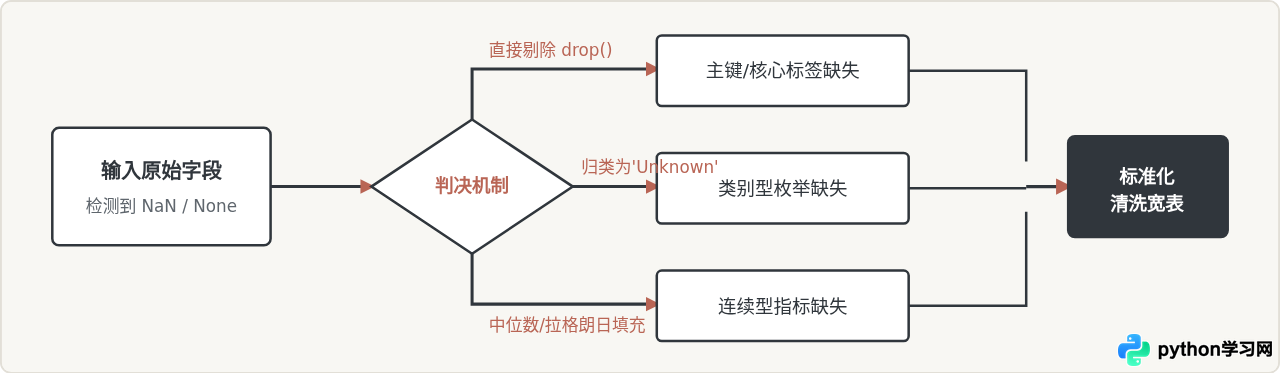
不能简单粗暴地将所有包含缺失值的行使用 dropna() 删除了事。需要针对字段的统计意义进行差异化处置:主键缺失必须剔除;关键指标(如金额)缺失需核对业务逻辑;分类标签(如设备类型)缺失可归纳为“未知(Unknown)”独立类别;连续型数值则视分布形态选择均值、中位数或拉格朗日插值填补。
2. 规范化清洗代码实战
以下代码演示一个严密的清洗管道:执行时间格式转换、负值过滤、分类变量填充以及基于箱线图IQR(四分位距)逻辑的异常金额截断。
import numpy as np

def clean_sales_data(df: pd.DataFrame) -> pd.DataFrame:
    # 建立深度副本以阻断链式赋值告警
    data = df.copy()

    # 1. 关键标识去重与缺失过滤
    data = data.dropna(subset=['order_id', 'user_id'])
    data = data.drop_duplicates(subset=['order_id'], keep='last')

    # 2. 时间维度统一格式化并衍生时间特征
    data['order_timestamp'] = pd.to_datetime(data['order_timestamp'], errors='coerce')
    data = data.dropna(subset=['order_timestamp'])
    data['order_date'] = data['order_timestamp'].dt.date
    data['order_hour'] = data['order_timestamp'].dt.hour

    # 3. 维度缺失值填充与类型收敛
    data['device_type'] = data['device_type'].fillna('Unknown').astype('category')
    data['user_city'] = data['user_city'].fillna('Others').str.strip()

    # 4. 业务逻辑合法性清洗(金额必须为正)
    data = data[(data['gross_amount'] > 0) & (data['discount_amount'] >= 0)]
    data['net_amount'] = data['gross_amount'] - data['discount_amount']
    data = data[data['net_amount'] > 0]

    # 5. 统计离群值判定(基于IQR法则进行极端刷单订单的标记而非盲目删除)
    q1 = data['net_amount'].quantile(0.25)
    q3 = data['net_amount'].quantile(0.75)
    iqr = q3 - q1
    upper_bound = q3 + 3.0 * iqr  # 采用极端异常阈值
    data['is_outlier'] = data['net_amount'] > upper_bound

    return data

df_cleaned = clean_sales_data(df_raw)
print(f"清洗完成,健康记录数: {len(df_cleaned)}, 异常离群单数: {df_cleaned['is_outlier'].sum()}")
四、阶段三:探索性数据分析(EDA)与业务指标建模
当数据进入清洁状态后,分析进入建模与挖掘环节。探索性数据分析(Exploratory Data Analysis)的核心任务不是无目的地绘制散点图,而是通过切片(Slice)、钻取(Drill-down)与透视(Pivot),拆解核心业务指标的内部结构。
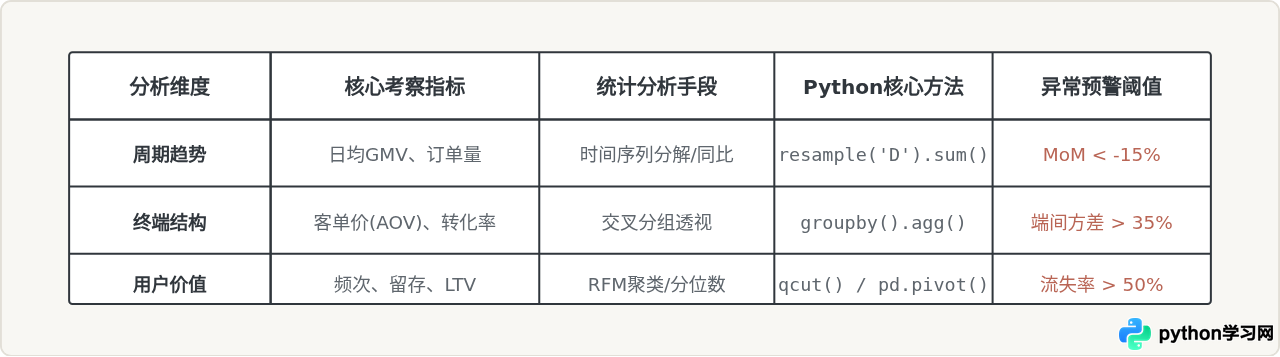
假设本案例的核心商业目标是:“分析平台净交易额(Net GMV)与客单价(AOV)的下滑主因”。我们需要从“时间周期”、“渠道终端”和“用户地域”三个维度交叉审视。
多维聚合与统计代码实现
# 排除极端离群单后进行多维下钻
df_valid = df_cleaned[~df_cleaned['is_outlier']].copy()

# 1. 终端维度的透视统计
channel_metrics = df_valid.groupby('device_type', observed=True).agg(
    total_orders=('order_id', 'count'),
    unique_users=('user_id', 'nunique'),
    total_net_gmv=('net_amount', 'sum'),
    avg_order_value=('net_amount', 'mean'),
    discount_ratio=('discount_amount', lambda x: x.sum() / (x.sum() + df_valid.loc[x.index, 'net_amount'].sum()))
).reset_index()

# 2. 衍生指标二次计算
channel_metrics['arpu'] = channel_metrics['total_net_gmv'] / channel_metrics['unique_users']
channel_metrics['net_gmv_share'] = channel_metrics['total_net_gmv'] / channel_metrics['total_net_gmv'].sum()

# 格式化输出分析结果(示例展示)
print(channel_metrics.sort_values(by='total_net_gmv', ascending=False).to_string(index=False))
五、阶段四:归因建模与业务洞察产出
“数据统计”与“洞察输出”的根本区别在于:前者陈述事实(“6月份移动端收入下降了18%”),后者解释机制并提供行动方案(“由于优惠券核销门槛调整导致移动端小额订单转化腰斩,建议回调起用梯度”)。
将冷冰冰的数字沉淀为决策资产,需要经过标准的“现象-归因-对策”转化漏斗。
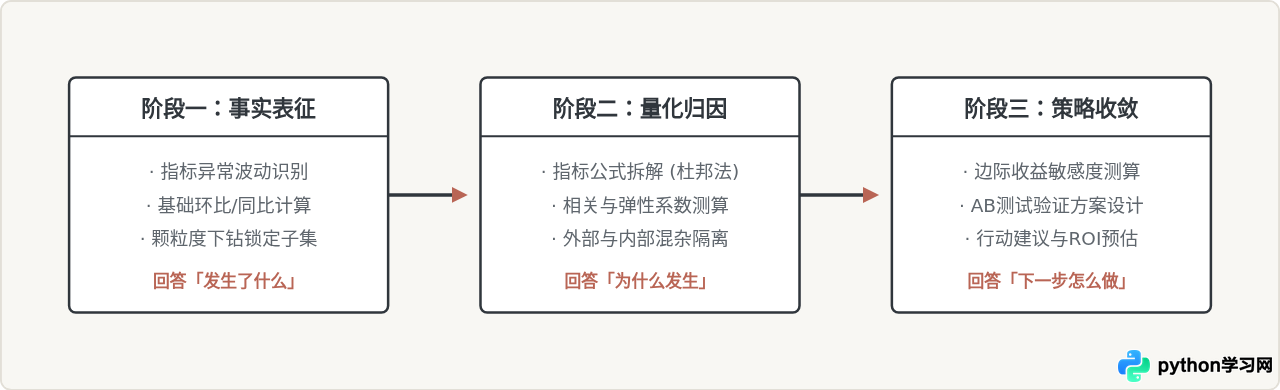
洞察结论沉淀与自动化报告输出
分析的最终交付通常是标准化的执行摘要表格或自动化邮件摘要。借助Python字典与文本渲染机制,可将核心指标异动以结构化方式固化:
def generate_executive_summary(metrics_df: pd.DataFrame) -> dict:
    """提取核心洞察并生成业务策略映射"""
    summary = {}

    # 提取移动端与PC端的客单价差距
    ios_aov = metrics_df.loc[metrics_df['device_type'] == 'iOS', 'avg_order_value'].values[0]
    web_aov = metrics_df.loc[metrics_df['device_type'] == 'Web', 'avg_order_value'].values[0]

    gap_ratio = (ios_aov - web_aov) / web_aov

    summary['aov_structural_gap'] = {
        'finding': f"iOS端客单价显著高于Web端约 {gap_ratio:.1%}",
        'underlying_cause': "Web端以低单价引流款为主,移动端承担了高客单捆绑包购买场景",
        'action_item': "在Web端结账链路增加组合购买推荐算法,提升跨品类连带率"
    }

    return summary

insight_report = generate_executive_summary(channel_metrics)
for k, v in insight_report.items():
    print(f"【业务判断】: {v['finding']}")
    print(f"【归因分析】: {v['underlying_cause']}")
    print(f"【落地策略】: {v['action_item']}")
六、工程落地中的高频陷阱与规避清单
在端到端的实战过程中,初学者与具备经验的工程师往往在代码编写之外的“边界假设”上拉开差距。以下是在各阶段必须严防的典型陷阱:
- 忽略隐式类型推断错误:CSV加载时将用户ID(如
0012893)默认识别为整数(12893),导致前导零丢失。在pd.read_csv时应对所有编码类字段显式声明dtype={'user_id': str}。 - 不恰当的填充污染分布:当某个数值型字段缺失率超过30%时,使用均值填充会人为严重压缩样本的方差,导致后续回归或分布分析失真。此类情况更适合作为独立特征哑变量(Dummy Variable)处理。
- 幸存者偏差与样本时间截断:分析用户复购周期时,如果仅统计“已复购用户”的间隔,会严重低估平均流失周期;必须对观测周期内尚未复购的沉默用户施加生存分析(Survival Analysis)中的截尾处理。
- 混淆相关性与因果性:观测到“领券用户客单价更高”,往往并非优惠券激发了消费能力,而是高消费意愿用户主动寻找领券入口。盲目推导因果会导致错误的补贴预算投放。
掌握Python数据分析的本质,是建立起在“严谨的数据流工程”与“敏锐的商业现实”之间自由切换的双重视角。遵循“标准化获取-精细化清洗-多维探索-归因建议”的完整闭环,每一行代码的执行,都能最终收敛为推动业务增长的实质证据。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









