

Python怎么使用enumerate和zip优化循环代码?
详细讲解在 Python 中如何使用内置的 enumerate 和 zip 函数优化循环遍历代码,消除 range(len()) 与冗余计数器,掌握元组解包、边界处理及常见误区辨析。
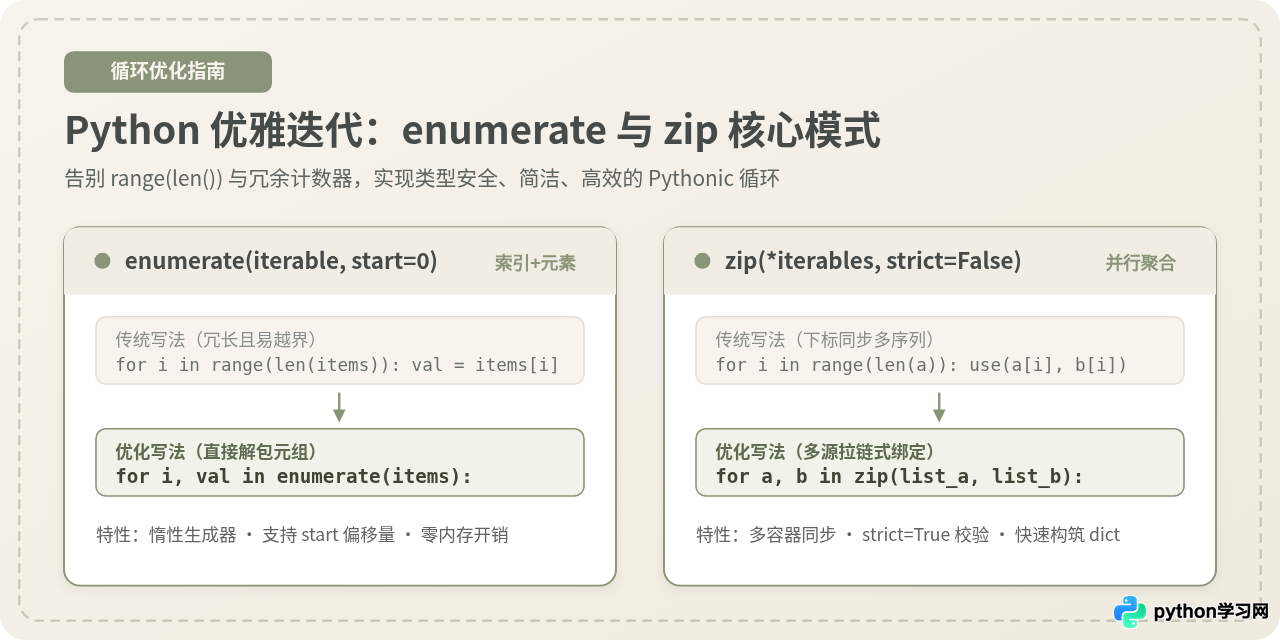
在 Python 中遍历数据时,经常需要同时获取元素索引,或者同时并行遍历多个数据列表。传统做法往往依赖 range(len(...)) 配合下标索引或手动累加计数器,不仅代码冗长繁琐,还容易引发下标越界并降低执行效率。Python 提供了两个内置的高阶迭代器:enumerate() 用于在遍历中自动绑定索引与元素,zip() 用于将多个序列的对应元素聚合配对。掌握这两个工具的解包机制与边界条件,能够让循环代码变得清晰、紧凑且符合 Pythonic 规范。
一、为什么要替代传统的下标索引循环?
初学 Python 时,很多开发者习惯把其他命令式语言(如 C 或 Java)的索引访问方式带入 Python。最典型的写法是通过 range(len(seq)) 生成索引,再在循环体内使用方括号访问序列元素:
# 待优化的传统写法
items = ["apple", "banana", "cherry"]
for i in range(len(items)):
    item = items[i]
    print(f"序号: {i}, 元素: {item}")
这种写法主要存在三个维度的局限:
- 样板代码冗余:定义了中间变量
i并反复执行items[i]下标索引,阅读者的视线被索引计算干扰,掩盖了循环体的真实业务逻辑。 - 序列类型受限:
len()和下标索引要求对象必须支持随机访问(即实现__len__与__getitem__协议的 Sequence 类型)。如果目标是生成器、文件对象、字典视图或网络数据流,这种写法会直接抛出TypeError。 - 多列表同步风险:当需要同步操作两个关联列表时,通常写成
list_a[i]和list_b[i]。一旦两个列表长度不一致,或者len()误用了较长的列表,程序运行到末尾时就会抛出IndexError: list index out of range。
Python 的 for 循环本质上直接操作可迭代对象的迭代器(Iterator),无需关心底层长度。接下来我们将分别学习专门处理“计数与元素”的 enumerate() 和处理“多序列并行”的 zip()。
二、使用 enumerate() 优雅处理“索引与元素”
enumerate() 是 Python 的内置函数,其作用是接收一个可迭代对象,并在每次迭代时产出一个包含两个元素的元组:(索引, 元素)。
1. 基础解包用法
通过 Python 的元组解包语法,我们可以在 for 语句头部直接将这两个值解构成两个具名局部变量:
languages = ["Python", "Rust", "Go"]

for index, name in enumerate(languages):
print(f"索引 {index}: {name}")索引 0: Python
索引 1: Rust
索引 2: Go2. 自定义起始计数值:start 参数
日常业务中,需要向终端用户展示或输出日志的序号通常以 1 开始,而不是计算机内部的 0。很多开发者习惯写 index + 1,但更标准的方法是直接传入 start 参数:
tasks = ["需求评审", "接口联调", "编写测试"]

for step_num, task in enumerate(tasks, start=1):
print(f"步骤 {step_num}:{task}")步骤 1:需求评审
步骤 2:接口联调
步骤 3:编写测试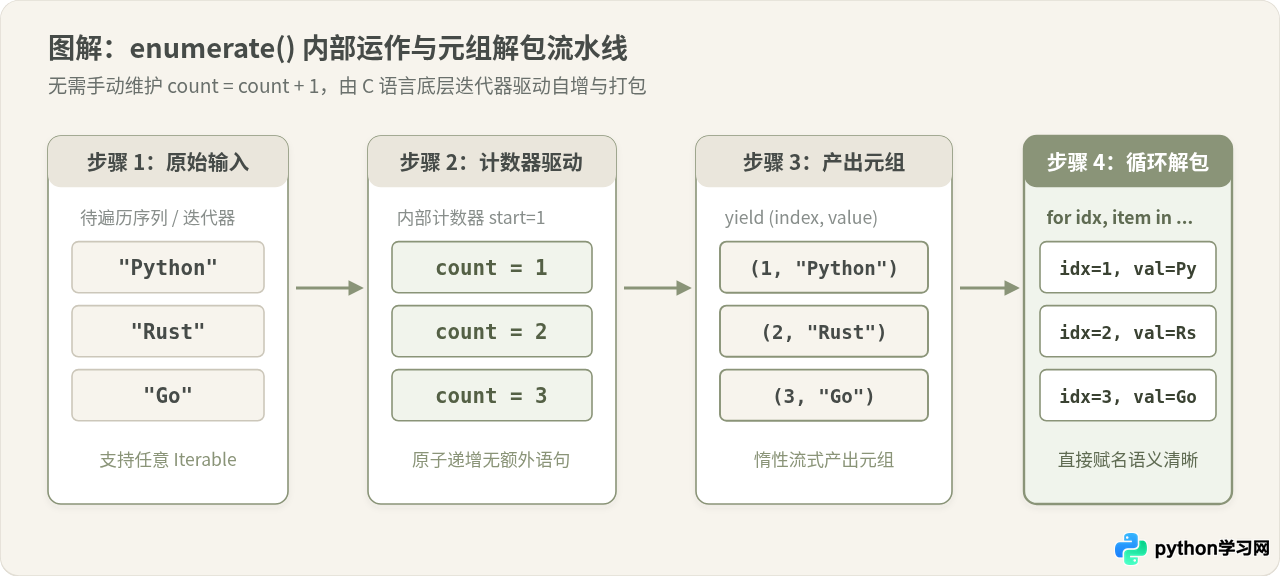
3. 常见认知误区辨析
这种想法为什么看似合理?因为很多开发者认为提前把索引拿出来可以避免后续临时修改循环头的麻烦,似乎“有备无患”。
为什么需要修正?在 Python 中,如果循环体内根本不需要使用位置索引,最简洁、表达力最强的写法始终是直接遍历:for item in items:。额外添加 enumerate 会增加不必要的变量绑定,给后续维护代码的人带来认知负担(读者会误以为 index 在后续逻辑中有关键作用)。因此,只有在业务明确依赖元素位置、打印编号或需要基于索引做模运算(如隔行变色)时,才应使用 enumerate()。
三、使用 zip() 并行聚合与遍历多个序列
当业务逻辑需要同时处理两个或多个平行的列表时(例如“姓名列表”与“成绩列表”、“商品名”与“单价”),zip() 是最优解。它像拉链一样,将传入的多个序列在相同位置的元素逐一咬合,打包成元组。
1. 基础用法:并行遍历两个及以上列表
代码示例:并行遍历两个列表names = ["张三", "李四", "王五"]
scores = [95, 88, 92]
for name, score in zip(names, scores):
print(f"学生:{name},成绩:{score} 分")学生:张三,成绩:95 分
学生:李四,成绩:88 分
学生:王五,成绩:92 分2. 快速生成字典
除了直接在循环中解包,zip() 还常与 dict() 构造器配合使用,将两个关联列表在一步内快速映射为键值对字典:
keys = ["host", "port", "protocol"]
values = ["127.0.0.1", 8080, "https"]

config = dict(zip(keys, values))
print(config)
# 示例输出: {'host': '127.0.0.1', 'port': 8080, 'protocol': 'https'}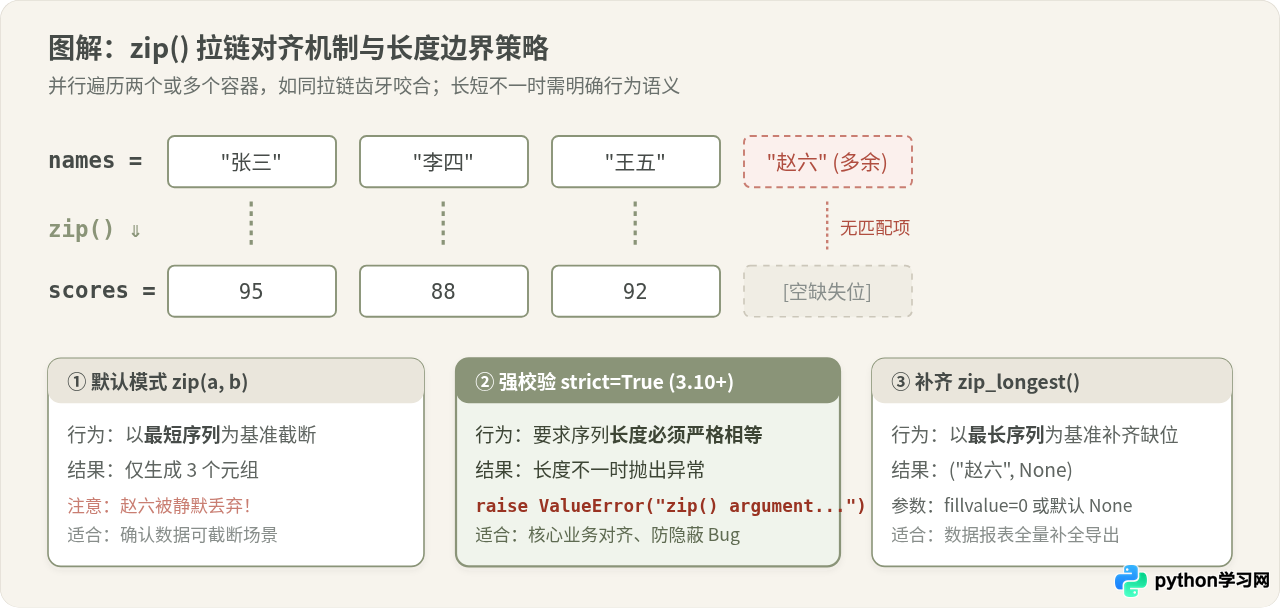
3. 序列长度不一致时的三种处理策略
现实场景中,多个数据源的长度可能并不完全一致。针对这种情况,Python 提供了三种截然不同的控制策略:
-
策略一:默认静默截断(以最短序列为准)
zip(a, b)默认会在任意一个序列耗尽时立即停止迭代。多余的元素会被完全忽略。这种特性在“只处理配对完整数据”时很有用,但在关键业务中极易因为数据缺失而产生隐蔽 Bug。 -
策略二:严格对齐校验(Python 3.10+ 的 strict=True)
如果业务要求传入的多个列表长度必须完全相等,请务必开启strict=True参数。一旦发现序列长短不一,它会在遍历末尾主动抛出ValueError,杜绝数据静默丢失:# Python 3.10+ 推荐写法 names = ["张三", "李四", "王五", "赵六"] scores = [95, 88, 92] try: for n, s in zip(names, scores, strict=True): print(n, s) except ValueError as e: print(f"数据长度不匹配: {e}") # 示例输出: 数据长度不匹配: zip() argument 1 is longer than argument 2 -
策略三:以长序列补全(itertools.zip_longest)
如果希望保留所有元素,对于较短序列缺失的位置用占位符填充,可以使用标准库itertools.zip_longest:from itertools import zip_longest names = ["张三", "李四", "王五", "赵六"] scores = [95, 88, 92] for n, s in zip_longest(names, scores, fillvalue=0): print(f"{n}: {s}") # 示例输出: # 张三: 95 # 李四: 88 # 王五: 92 # 赵六: 0
历史渊源:在早期的 Python 2 中,zip() 确实会直接返回一个由元组构成的完整 list,在处理百万级大型数据时容易造成瞬时内存激增。
现代事实:在 Python 3 中,zip() 和 enumerate() 均返回标准的惰性迭代器(Iterator),只有在循环推进到当前位置时才会计算并产出一个元组,其空间复杂度为常量级别的 O(1)。即使传入两个包含千万个元素的生成器,也不会占用额外内存。
四、进阶组合:enumerate 与 zip 联合使用
在综合业务中,我们经常遇到这样的需求:既要同时并行对比多个序列,又要在输出时显示当前的序号或行号。这时可以将两者嵌套组合使用:
联合用法代码示例:students = ["小明", "小红", "小刚"]
math_scores = [90, 85, 95]
english_scores = [88, 92, 89]
for rank, (name, m_score, e_score) in enumerate(zip(students, math_scores, english_scores), start=1):
total = m_score + e_score
print(f"名次 {rank}: {name} (数学: {m_score}, 英语: {e_score}, 总分: {total})")名次 1: 小明 (数学: 90, 英语: 88, 总分: 178)
名次 2: 小红 (数学: 85, 英语: 92, 总分: 177)
名次 3: 小刚 (数学: 95, 英语: 89, 总分: 184)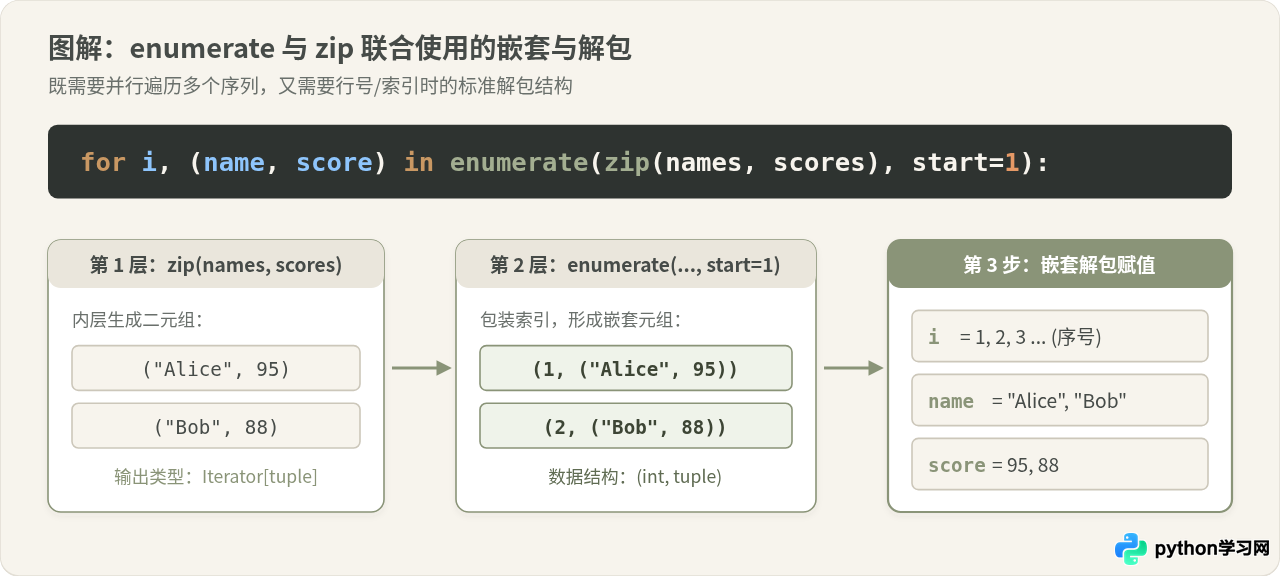
关键排错点:元组解包的括号嵌套
编写 enumerate(zip(...)) 时,最常见的语法报错就是遗漏括号:
# 错误示例:遗漏了内层括号
for i, name, score in enumerate(zip(names, scores)):
    ...
# 运行时报错: ValueError: not enough values to unpack (expected 3, got 2)
原因剖析:enumerate() 每次产出的永远是两项数据:(索引, 元素)。当它包装 zip() 时,这个“元素”本身又是一个元组 (name, score)。因此最外层只有两个项,如果直接写 i, name, score,Python 会尝试将二元组解包给 3 个变量,自然会抛出异常。正确的写法必须显式加上小括号:for i, (name, score) in ...。
五、循环重构决策与最佳实践总结
为了帮助大家在日常编码中快速选用最恰当的循环模式,下表总结了传统写法与优化写法的直观映射关系:
| 需求场景 | 传统低效/繁琐写法 | 现代化优化写法 | 核心优势 |
|---|---|---|---|
| 需要元素和从 0 开始的索引 | for i in range(len(items)): val = items[i] |
for i, val in enumerate(items): |
直观清晰,消除下标访问与越界隐患 |
| 需要元素和从 1 开始的展示序号 | for i in range(len(items)): num = i + 1 |
for num, val in enumerate(items, start=1): |
语义明确,无需在循环体内进行下标算术 |
| 并行同步遍历两个序列 | for i in range(len(a)): x, y = a[i], b[i] |
for x, y in zip(a, b): |
天然多源绑定,支持任意生成器和迭代器 |
| 要求多个序列长度严格一致 | assert len(a) == len(b); for i ... |
for x, y in zip(a, b, strict=True): |
Python 3.10+ 内置强校验,防范静默截断 Bug |
| 多序列并行且需要记录序号 | count = 1; for ...: count += 1 |
for i, (x, y) in enumerate(zip(a, b), 1): |
消除外部变量污染,解包直接赋值 |
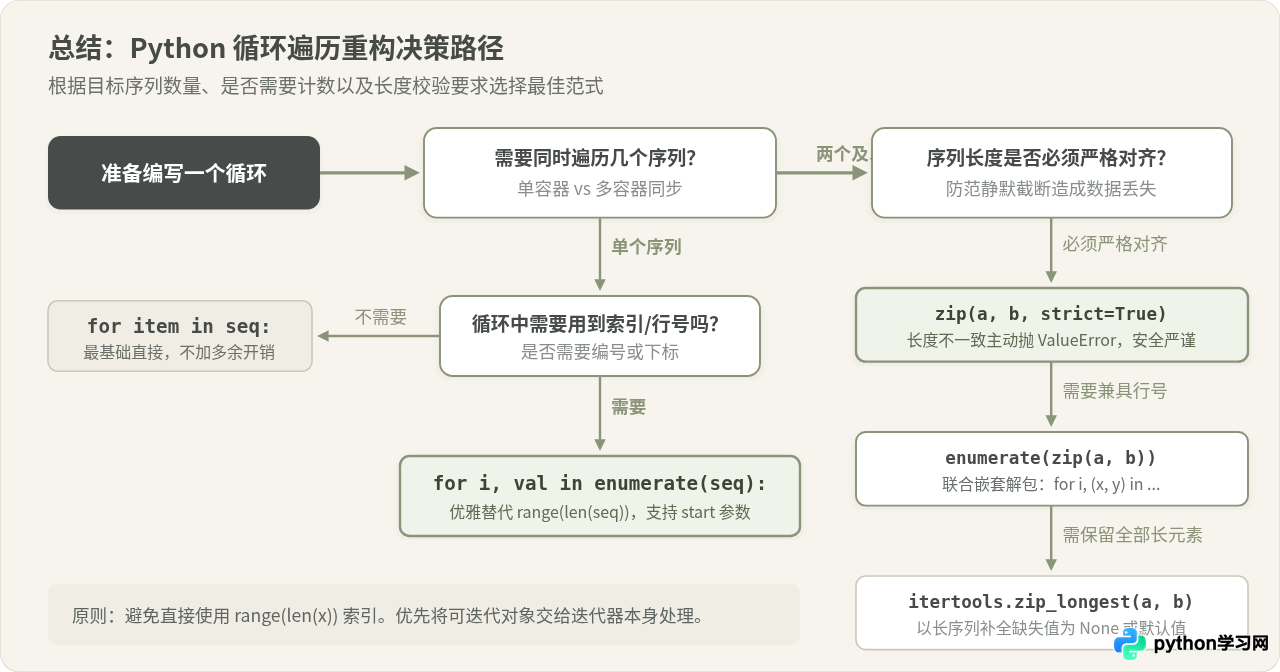
重构清单(Checklist)
- 当看到代码中出现
range(len(...))时,立即停下来思考:是否可以使用enumerate()或zip()代替?95% 以上的场景都可以直接替换。 - 如果循环内根本用不到数字序号,直接使用
for item in items:,不要画蛇添足。 - 在处理多序列并行的关键数据(如账单明细匹配、坐标映射)时,在 Python 3.10+ 环境下优先开启
strict=True,让潜在的数据对齐问题尽早暴露。 - 组合使用
enumerate(zip(...))时,始终确认用于解包内层元组的括号(a, b)是否完整。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









