

怎么用Python字符串和列表方法高效清洗文本数据
深入讲解如何使用Python原生字符串与列表方法高效完成文本数据清洗,涵盖空白去除、符号替换、大小写归一化、切分过滤与内存优化,并附清晰架构与流程图解。
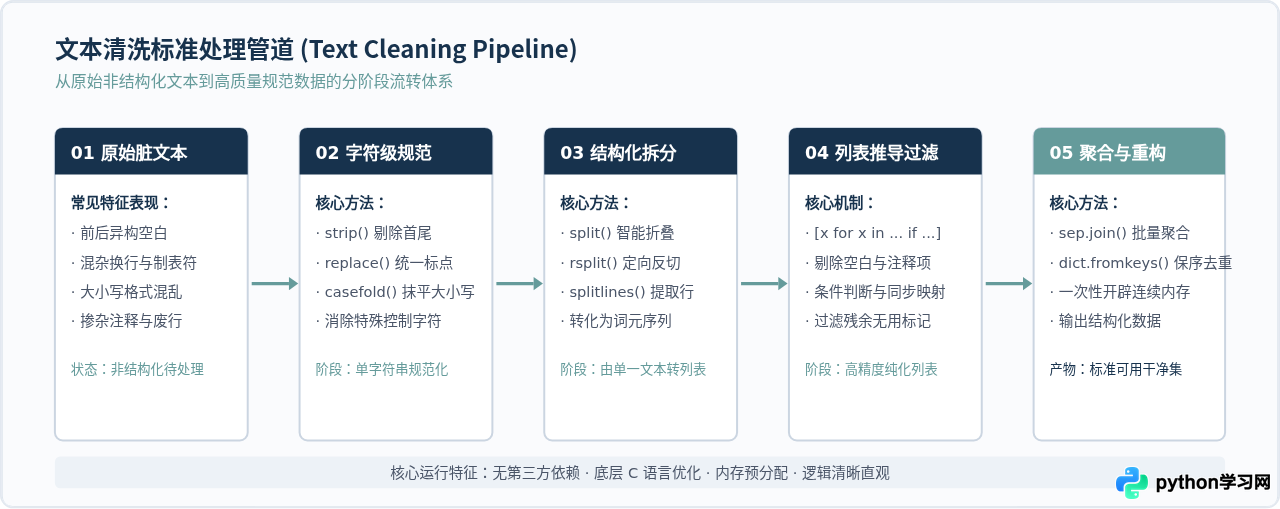
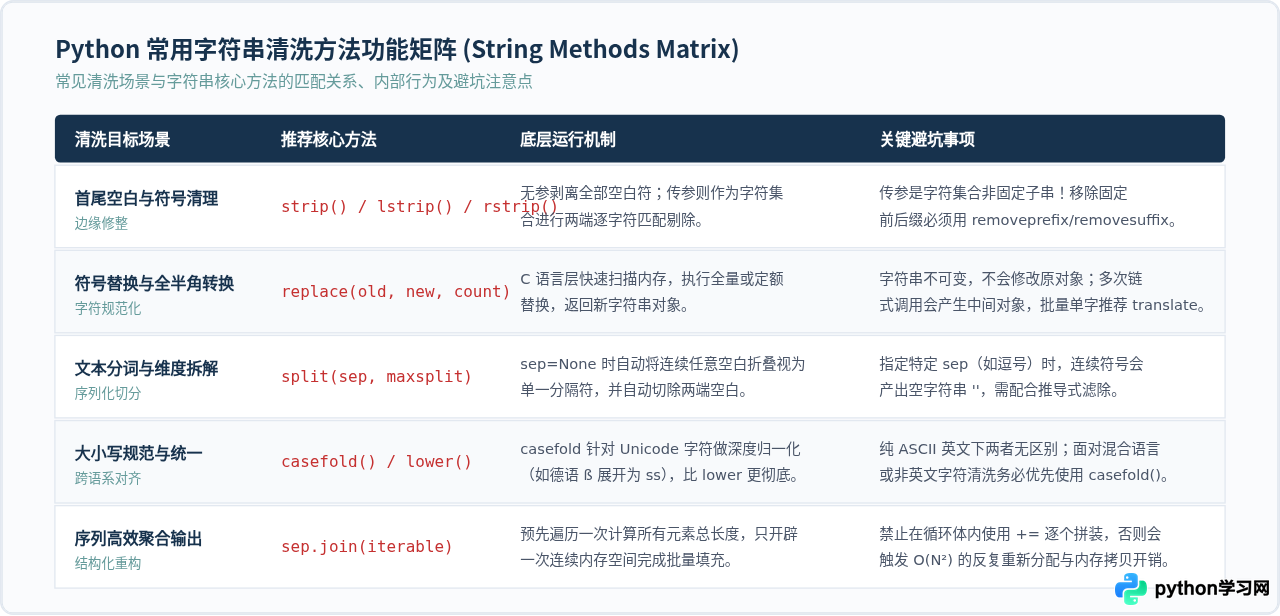
在绝大多数日常数据分析、爬虫信息提取和日志处理任务中,文本清洗并不需要立刻引入庞大的自然语言处理库或复杂的正则表达式。Python 原生内置的字符串(str)方法与列表(list)操作,在底层完全由 C 语言实现,具备极高的执行效率与极低的心智负担。通过合理串联首尾剥离、符号替换、按需切分、列表推导式过滤以及高效重组,能够纯粹依托原生基础语法构建出一条简洁、健壮的高性能文本清洗流水线。
一、首尾规整:精准清除边缘干扰与不可见空白
文本从外部输入(如文件读取、网络接口或用户表单)导入时,两端最容易混杂空格、制表符(\t)以及不同操作系统下的换行符(\r\n 或 \n)。清理这些无意义的外围字符是文本清洗的第一要务。
1. strip() 的默认行为与核心机制
当不向 strip() 传递任何参数时,它会自动在底层按字节扫描字符串的开头和结尾,移除所有匹配空白定义的字符(包括空格、\t、\n、\r、\v 和 \f)。若只需要修剪左侧或右侧,则分别使用 lstrip() 和 rstrip()。
raw_input = "  \t\n  用户数据上报记录: 活跃状态  \r\n "
cleaned = raw_input.strip()
print(f"原始长度: {len(raw_input)}, 清理后长度: {len(cleaned)}")
print(repr(cleaned))原始长度: 32, 清理后长度: 15
'用户数据上报记录: 活跃状态'
2. 传参使用 strip() 时的常见误区
很多初学者会误以为 strip("abc") 会把整体子串 "abc" 移除。事实上,strip() 的参数是一个“字符集合(character set)”,而不是一个固定的前缀或后缀子串。只要字符串两端的字符存在于该集合中,就会持续被剥离,直到遇到第一个不属于该集合的字符为止。
# 错误示例:试图剥离前缀 URL 协议
url = "https://example.com"
wrong_cleaned = url.lstrip("https://")
print(wrong_cleaned)

# 正确做法:使用 Python 3.9+ 提供的 removeprefix() 或切片
correct_cleaned = url.removeprefix("https://")
print(correct_cleaned)example.com # 此处虽然结果看起来正确,但若域名以 h/t/p/s/e 开头会产生误删!例如 "https://ssl.com".lstrip("https://") 会变成 "l.com"
example.com # removeprefix 是严格的子串匹配,安全可靠
避坑指南:只有在明确需要剔除两端任意标点符号集合(如 strip(".,;?!\"'"))时才给 strip() 传参;若要剔除特定单词或协议头,务必使用 removeprefix() / removesuffix()。
二、内容替换与符号标准化:消除内部噪点
除首尾外,文本内部常出现全角半角标点混用、非法制表符、特殊分隔符混乱等问题。此时需要使用 replace() 进行针对性清理。
1. 替换统一换行与多余制表符
当处理跨系统采集的文本时,Windows 的 \r\n 与 Unix 的 \n 往往并存。统一换行符能够大幅简化后续的分行与处理逻辑:
raw_text = "第1行数据\r\n第2行数据\r第3行数据\n"
# 统一换行符为 \n
normalized_text = raw_text.replace("\r\n", "\n").replace("\r", "\n")
print(repr(normalized_text))'第1行数据\n第2行数据\n第3行数据\n'
2. 多字符映射清洗利器:str.maketrans 与 translate
如果需要同时清理或转换大量散乱标点符号(例如将中文全角逗号、句号、冒号转换为半角,或一次性移除所有括号),多次调用 replace() 会频繁产生中间字符串对象。使用 str.maketrans() 配合 translate() 可以单次扫描完成批量转换:
dirty_record = "订单编号:【A10029】,金额:¥299.00;状态:(已发货)"
# 建立字符映射转换表:左侧映射为右侧,第三个参数中的字符直接被删除
trans_table = str.maketrans(",;:", ",;:", "【】()¥")
clean_record = dirty_record.translate(trans_table)
print(clean_record)订单编号:A10029,金额:299.00;状态:已发货
三、大小写规范化:为什么在清洗中优先选用 casefold()
在进行文本去重、关键词匹配或建立索引前,必须保证英文或外文单词的大小写标准统一。绝大多数教程习惯使用 lower(),但在正式的文本清洗工程中,更推荐使用 casefold()。
lower() 仅对标准的 ASCII 字符(A-Z)以及常见的直接小写字符生效,而 casefold() 实现了完整的 Unicode 规范大小写折叠。例如在德语中,大写字母 ß(或 SS)在调用 lower() 时依然是 ß,但在调用 casefold() 时会被正确转换为标准的 ss。如果数据集中包含多语言字符或特殊西文符号,casefold() 能杜绝因编码特性导致的漏匹配。
word_de = "STRASSE"
print("lower():", word_de.lower())
print("casefold():", word_de.casefold())

# 关键词清洗匹配判断
user_query = "Fluß"
db_record = "FLUSS"
print("直接判断:", user_query == db_record)
print("casefold归一化后:", user_query.casefold() == db_record.casefold())lower(): strasse
casefold(): strasse
直接判断: False
casefold归一化后: True
四、文本切分与解构:split() 与 rsplit() 的深度运用
清洗完单字符串后,下一步通常是将篇章或长字段解构成离散的列表数据。Python 提供了功能强大的 split() 系列方法。
1. split() 传参与不传参的本质区别
这是 Python 字符串切分中最容易被忽视、却极其好用的特性:
text.split()(不传参数):Python 会自动将任意连续的空白字符(多个空格、换行、制表符的混合物)整体视为单一分隔符,并且会自动忽略字符串首尾的空白。text.split(" ")(明确传递单空格):严格按照单个空格符号进行切分。如果出现两个连续空格,就会在结果列表中产生一个空字符串""。
messy_tokens = "  Python    数据清洗\t\t实战   进阶\n指南  "

# 方式一:默认不传参(自动合并连续空白)
tokens_auto = messy_tokens.split()
print("默认 split():", tokens_auto)

# 方式二:显式指定单空格
tokens_space = messy_tokens.split(" ")
print("指定空格 split(' '):", tokens_space)默认 split(): ['Python', '数据清洗', '实战', '进阶', '指南']
指定空格 split(' '): ['', '', 'Python', '', '', '', '数据清洗\t\t实战', '', '', '进阶\n指南', '', '']
显而易见,针对日常由不规则空格隔开的词汇提取,直接使用不带参数的 split() 可以免去大量后续剔除空元素的繁杂操作。
2. maxsplit 参数与 rsplit() 的定向提取
当日志文件按特定结构排列,但内容本身包含分隔符时,可以通过 maxsplit 限制切分次数。例如每行日志格式为 时间戳 级别 详细消息(详细消息本身可能包含空格):
log_line = "2026-10-17 08:30:15 INFO System started successfully with 4 workers"
# 只在左侧切分前两次,将后续日志内容完整保留为第3个元素
parts = log_line.split(" ", maxsplit=2)
print("split 限制切分:", parts)

# 从右侧切分:常用于剥离后缀标签或文件扩展名
filename = "user.backup.config.json"
base, ext = filename.rsplit(".", maxsplit=1)
print(f"文件名: {base}, 扩展名: {ext}")split 限制切分: ['2026-10-17', '08:30:15', 'INFO System started successfully with 4 workers']
文件名: user.backup.config, 扩展名: json
五、列表推导式:高效过滤与批量清洗的核心引擎
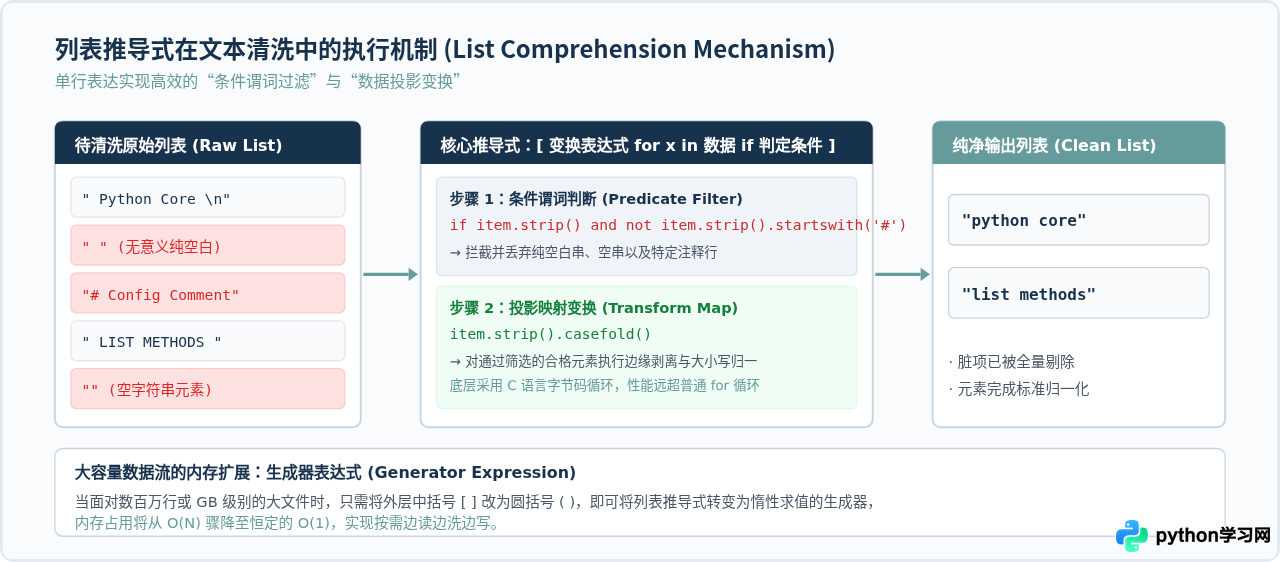
切分之后,数据进入列表形态。面对包含空行、注释、非法字符或格式各异的列表元素,列表推导式(List Comprehension)是 Python 中兼具极致性能与优雅语法的处理方案。
1. 过滤脏数据与同步变换的实战范式
传统的 for 循环不仅代码冗长,而且因为每次循环都在 Python 虚拟机层面执行字节码并反复调用 list.append(),性能开销明显偏高。列表推导式在底层由 C 级别专门针对循环逻辑进行了预分配与指令内联优化,执行速度通常比等效的 for 循环快 25% 至 40%。
raw_lines = [
    "  Header Information  ",
    "   ",
    "# 这是一个配置注释行",
    "data_row_1: 10023, active",
    "   ",
    "# 另一个备注信息",
    "data_row_2: 10024, pending  "
]

# 单行搞定:过滤空行和注释行,并对内容进行边缘修剪与统一
cleaned_rows = [
    line.strip()
    for line in raw_lines
    if line.strip() and not line.strip().startswith("#")
]

print("清洗后数据条目数:", len(cleaned_rows))
for row in cleaned_rows:
print(" ->", row)清洗后数据条目数: 3
-> Header Information
-> data_row_1: 10023, active
-> data_row_2: 10024, pending
2. 列表保序去重:dict.fromkeys()
在清洗分词列表或标签集合时,去重是极其常见的需求。虽然 list(set(tokens)) 能够快速去重,但由于 set 是基于哈希散列的无序容器,它会完全打乱元素原有的出现次序,这对于时序日志或句式文本来说往往是不可接受的。
自 Python 3.7 起,字典(dict)保证插入顺序。利用 dict.fromkeys() 可以实现兼顾 \(O(N)\) 时间复杂度且严格保留原始出现顺序的去重:
dirty_tags = ["python", "数据清洗", "python", "字符串", "数据清洗", "列表"]

# 传统 set 去重:顺序会被打乱
set_dedup = list(set(dirty_tags))
print("set 去重(顺序失真):", set_dedup)

# 推荐:dict.fromkeys 保序去重
ordered_dedup = list(dict.fromkeys(dirty_tags))
print("dict.fromkeys 去重(保持原序):", ordered_dedup)set 去重(顺序失真): ['列表', '字符串', '数据清洗', 'python']
dict.fromkeys 去重(保持原序): ['python', '数据清洗', '字符串', '列表']
六、聚合与重构:避免 += 陷阱与优雅组装
当列表清洗完毕后,我们往往需要将其重新组装为标准格式的字符串(例如以换行符隔开的规整文本,或以逗号隔开的 CSV 字段行)。
1. 为什么严禁在循环中用 += 拼接字符串
在 Python 中,字符串是不可变对象(Immutable Object)。如果在循环中执行 result += item,由于原字符串无法被就地扩容,Python 每次都必须重新申请一块新的内存空间,将旧字符串的内容复制过去,再加上新内容。在处理 \(N\) 个元素时,总体时间复杂度将急剧恶化为 \(O(N^2)\),当数据量较大时会导致严重的性能雪崩。
2. 终极性能解法:str.join()
sep.join(iterable) 在底层执行前,会先遍历一次可迭代对象,精确计算出所有字符串元素及其连接符所需的总内存字节数,然后一次性向系统申请该连续内存空间,随后按顺序直接写入数据。这种两阶段算法将复杂度压到了极致的 \(O(N)\)。
items = ["user_id:1001", "role:admin", "status:active", "level:5"]

# 高效拼接为标准化日志行
log_entry = " | ".join(items)
print(log_entry)

# 批量拼接为多行文档
multiline_doc = "\n".join(items)
print(multiline_doc)user_id:1001 | role:admin | status:active | level:5
user_id:1001
role:admin
status:active
level:5
七、决策与综合实战:构建模块化清洗流水线
了解各个方法的独立作用后,我们来看面对不同的输入形式与清洗诉求时,如何快速选择最优技术路径,并将其组织成易于复用的模块化函数。
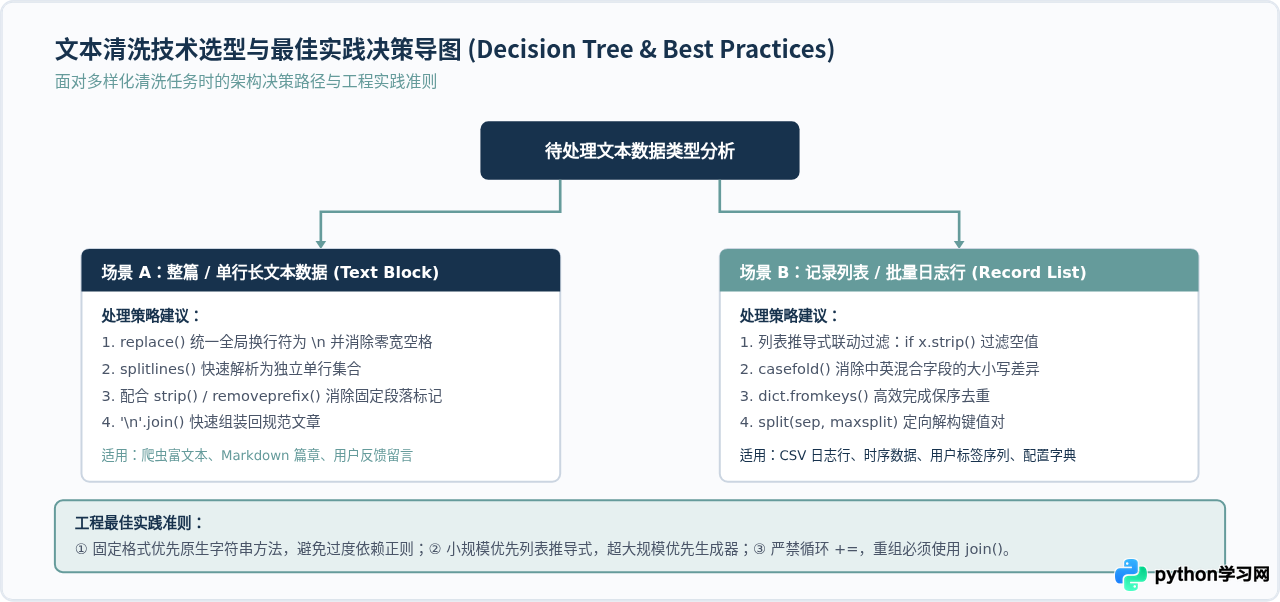
综合清洗流水线函数封装示例
下面是一个将上述全部方法融会贯通的清洗函数。它接收一段充满杂乱格式的原始字符串,自动完成空行剔除、注释过滤、字段修剪、大小写规范化与去重,最终输出标准结构化数据:
def clean_text_pipeline(raw_content: str) -> list[str]:
    """
    轻量级高效文本清洗管道
    1. 统一换行符
    2. 按行切分并消除空行与注释
    3. 字段两端修饰与大小写归一
    4. 保持原有次序去重
    """
    if not raw_content:
        return []

    # 第一步:统一换行并提取行
    normalized = raw_content.replace("\r\n", "\n").replace("\r", "\n")
    lines = normalized.splitlines()

    # 第二步:列表推导式执行过滤与映射
    processed = [
        line.strip().casefold()
        for line in lines
        if line.strip() and not line.strip().startswith(("#", "//"))
    ]

    # 第三步:保序去重
    deduped = list(dict.fromkeys(processed))
    return deduped

# 测试数据
raw_data = """
# 系统配置表单导出
HOST: 127.0.0.1:8080

// 冗余注释
ENV: PRODUCTION
host: 127.0.0.1:8080
DEBUG: FALSE

"""

result = clean_text_pipeline(raw_data)
print("最终清洗产物:")
for item in result:
print(" -", item)最终清洗产物:
- host: 127.0.0.1:8080
- env: production
- debug: false
八、总结与要点速查
高效的 Python 文本清洗并不取决于工具库的复杂程度,而在于对内置基础特性的精准运用:
- 剥离边缘:使用
strip()默认处理空白;消除特定前缀使用removeprefix()。 - 处理内容:使用
replace()处理简单文本替换,多标点批处理使用str.maketrans()与translate()。 - 规范格式:跨语言、深度归一化优先选用
casefold()。 - 维度转换:空白分词用无参
split(),结构化切分用split(sep, maxsplit)或rsplit()。 - 批量纯化:使用列表推导式完成带条件的快速过滤;涉及大容量数据时无缝切换为生成器表达式。
- 聚合保序:去重保序使用
dict.fromkeys(),字符串重构统一使用sep.join()。
遵循这一套原生体系,既能保证代码拥有极佳的运行性能,又能使逻辑保持高度的清晰与可维护性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









