

Python批量处理字符串:列表推导式实现ASCII+5偏移
本文详细讲解在Python中利用列表推导式结合ord()与chr()函数实现字符串ASCII+5偏移的高效方法,涵盖单字符串处理、批量列表转换、数据流图解及边界防御方案。
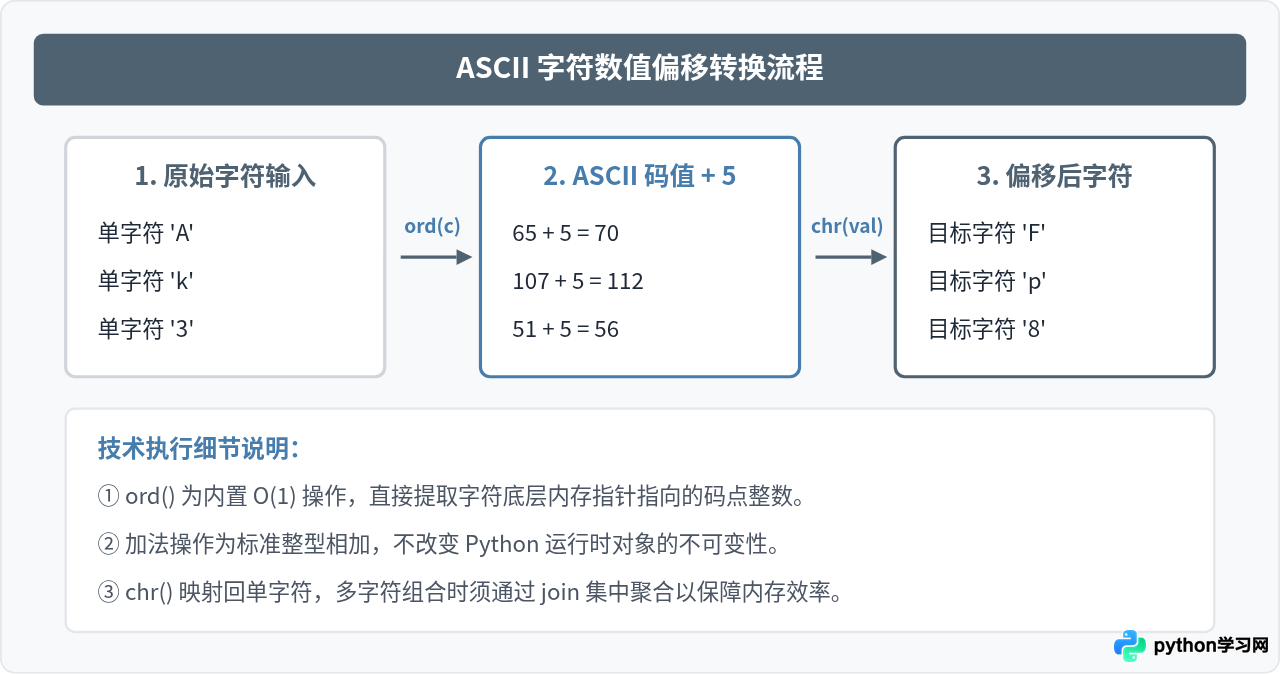
在 Python 中对字符串进行 ASCII+5 偏移,核心是将每个字符通过内置函数 ord() 转换为对应的 ASCII 整数码点,执行数值加 5 操作,再用 chr() 函数还原为字符。当面对包含多个字符串的数据集时,结合列表推导式与 str.join() 可以在内存中高效完成无副作用的批量转换,无需编写繁琐的多层嵌套循环。
一、核心原理:ord() 与 chr() 的数值转换
计算机内部使用数值编码存储字符,标准 ASCII 码为英文字符、数字和常用控制符分配了 0 至 127 的整数编号。例如大写字母 'A' 的编码为 65,字符 '3' 的编码为 51。进行 ASCII+5 偏移本质上是离散码点的平移运算。
Python 提供了两个互逆的原生函数来完成这一底层转换:
ord(c):接收一个长度为 1 的字符串,返回对应的 Unicode/ASCII 整数值。chr(i):接收一个整数码点,返回对应的单字符字符串。
二、单字符串处理:列表推导式与 str.join()
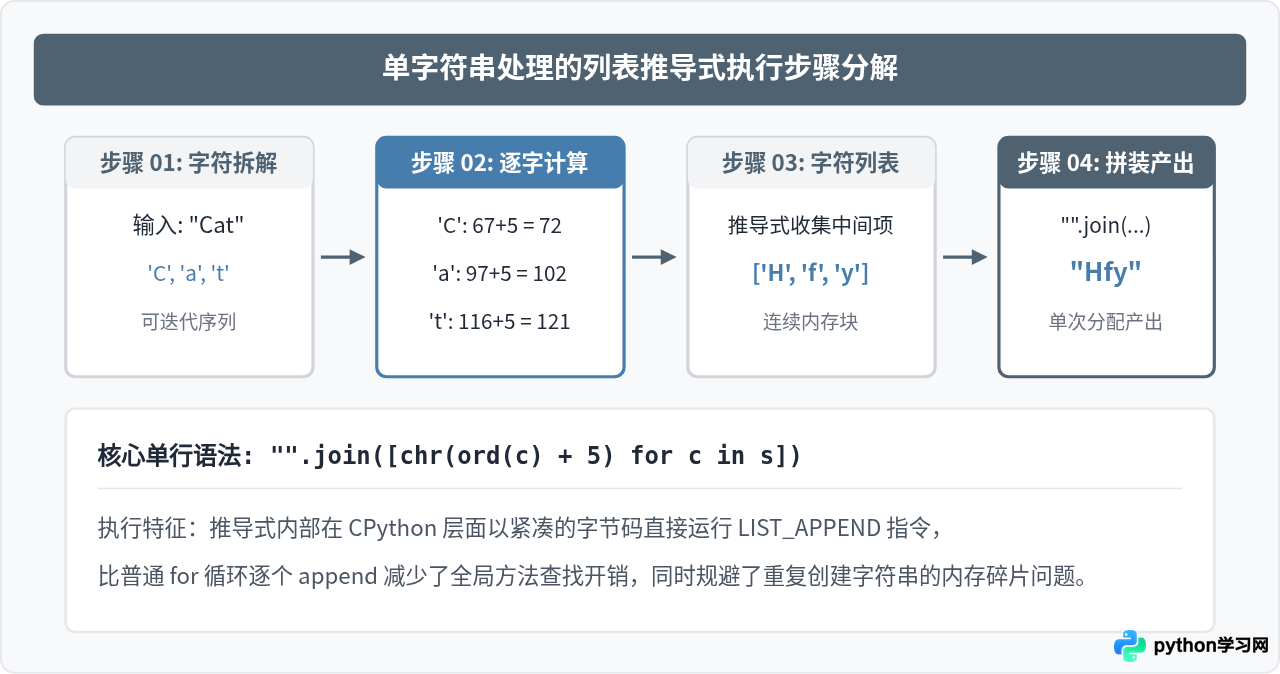
由于 Python 中的 str 是不可变对象,如果在循环中使用 res += chr(ord(c) + 5),每次拼接都会开辟新的内存块并复制旧内容,整体时间复杂度为 O(N²)。
利用列表推导式 [chr(ord(c) + 5) for c in text] 可以将各个字符的偏移结果收集在连续列表容器中,最后调用 "".join(...) 完成单次内存申请与组装,执行效率大幅提升。
# 单个字符串处理示例
source_text = "Python"

# 1. 列表推导式遍历每个字符并偏移
shifted_chars = [chr(ord(c) + 5) for c in source_text]

# 2. 合并为新字符串
result_text = "".join(shifted_chars)

# 示例输出:U~ymts
print("原始字符串:", source_text)
print("偏移后结果:", result_text)
三、批量处理:嵌套列表推导式的工业化写法
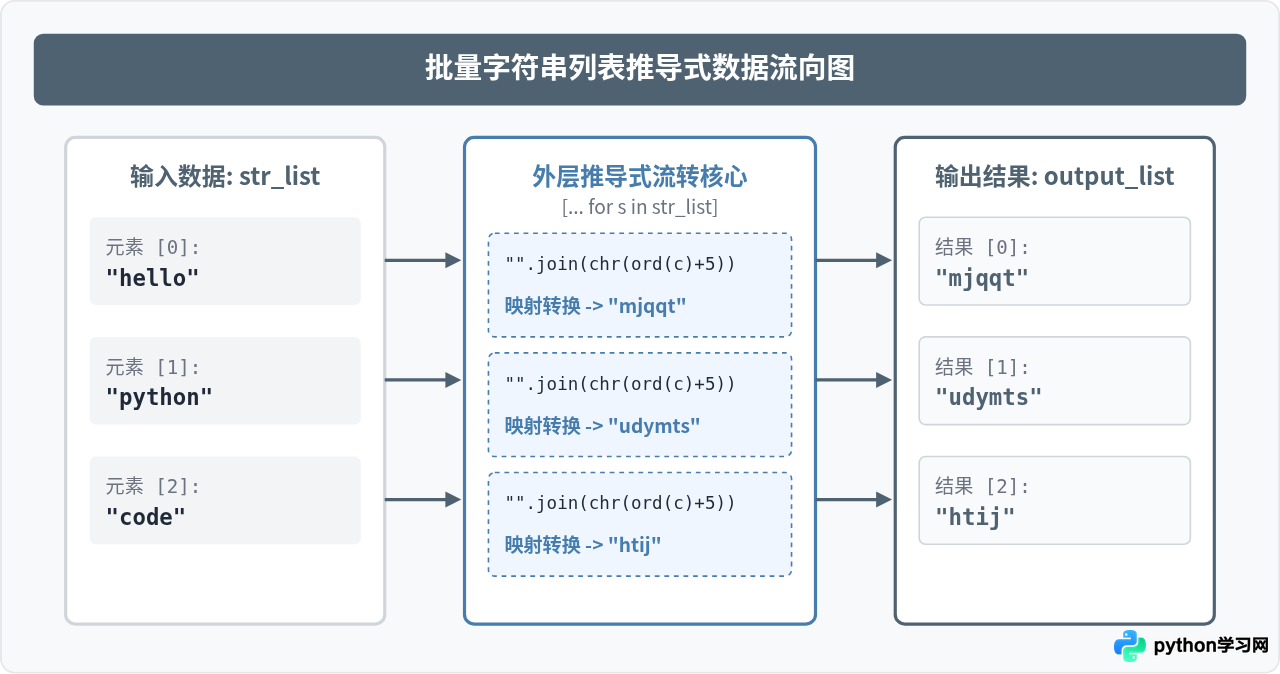
在实际数据预处理、协议编解码或简易文本混淆场景中,待处理的数据通常以列表形式组织(例如 ["hello", "python", "ascii"])。此时可以采用二维嵌套推导式完成批量映射。
# 批量字符串处理完整示例
dataset = ["admin", "server", "data2026"]

# 嵌套列表推导式:外层遍历列表,内层处理单串字符并合并
encrypted_dataset = [
    "".join([chr(ord(c) + 5) for c in text])
    for text in dataset
]

# 示例输出:
# 原数据: ['admin', 'server', 'data2026']
# 转换后: ['firns', 'xjwsjw', 'ifyf757;']
print("原数据:", dataset)
print("转换后:", encrypted_dataset)
语法解析:外层 for text in dataset 负责产出新的列表元素;内层 "".join([chr(ord(c) + 5) for c in text]) 负责将当前字符串转换为偏移后的新字符串。整段代码既保持了声明式语法的精炼,又在单次迭代中完成了全量数据的转换。
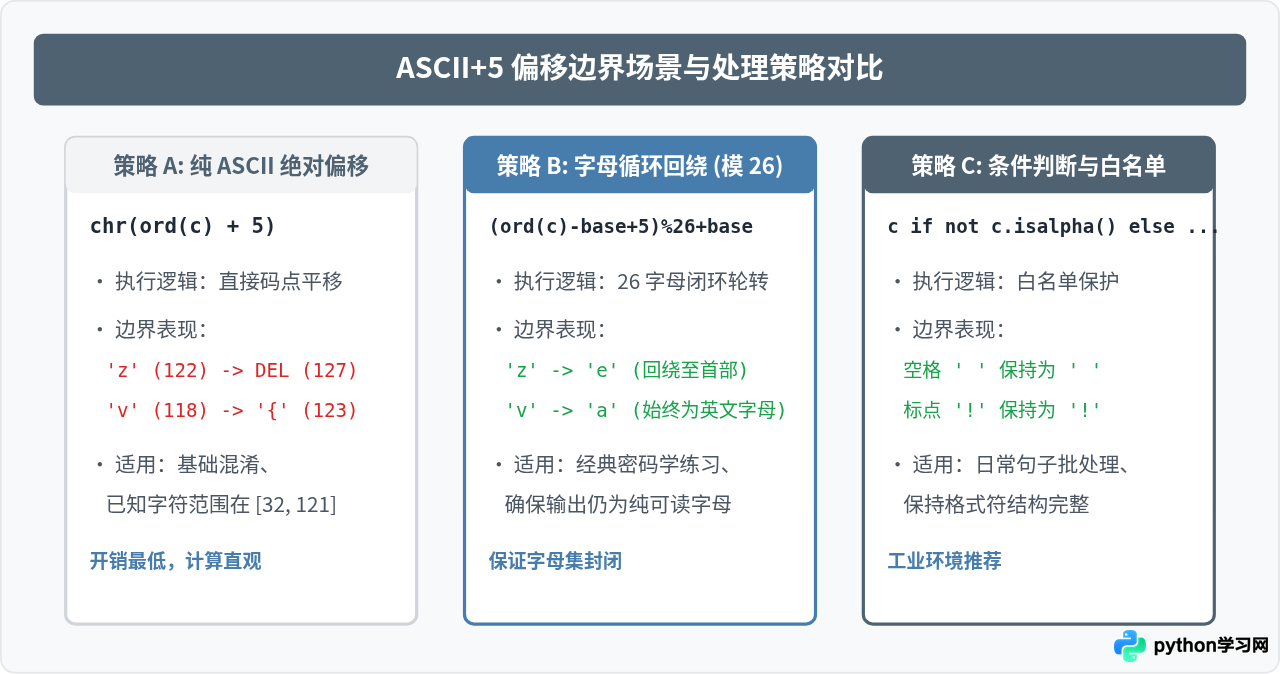
四、边界场景与防御性设计
在直接执行 chr(ord(c) + 5) 时,读者需要注意以下边界与特殊字符行为:
1. ASCII 字符边界溢出
标准 ASCII 编码范围为 0 到 127。小写字母 'z' 的 ASCII 值为 122,加 5 偏移后得到 127(对应删除控制符 DEL);小写字母 'v' 为 118,加 5 后得到 123(对应符号 {)。
- 如果需求是纯数值平移,直接使用
chr(ord(c) + 5)即可; - 如果需求是字母循环(经典凯撒密码),需要在小写
'a'-'z'或大写'A'-'Z'区间内进行模 26 取模计算。
2. 忽略或保留非字母字符
如果文本中含有空格、中文、标点符号或数字,往往不希望其被平移破坏。可以在推导式中引入三元条件表达式 val if condition else fallback 进行条件过滤:
# 带有条件保护的偏移处理
raw_list = ["Hello World!", "Status: 200 OK"]

def shift_char(c, offset=5):
    # 只对英文字母做偏移,其余字符保持原样
    if 'a' <= c <= 'z':
        return chr((ord(c) - ord('a') + offset) % 26 + ord('a'))
    elif 'A' <= c <= 'Z':
        return chr((ord(c) - ord('A') + offset) % 26 + ord('A'))
    return c

safe_shifted = [
    "".join([shift_char(c, 5) for c in item])
    for item in raw_list
]

# 示例输出:['Mjqqt Btwqi!', 'Xyfyzx: 200 TP']
print("安全偏移结果:", safe_shifted)
五、性能与使用建议
在面对数万至数十万级别的大规模文本数据时,推荐读者关注以下实操准则:
- 优先使用列表推导式而非 map + lambda:虽然
list(map(lambda c: chr(ord(c)+5), s))同样可以实现映射,但lambda会引入额外的 Python 函数栈帧调用开销,执行速度比推导式慢约 30% 到 50%。 - 超长文本预转换:若处理 GB 级别的离散文本流,可以考虑使用标准库的
str.maketrans()和str.translate()结合预先生成的映射表,在 C 语言层完成零额外栈消耗的替换。但在常规脚本、配置解析和日常数据转换中,列表推导式配合ord()与chr()是代码清晰度与运行性能兼顾的最佳实践。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









