

Python字符串find与index、strip与lstrip有什么区别?
详细对比Python中find与index、strip与lstrip的核心区别,涵盖返回值差异、异常抛出机制、修剪方向及字符集匹配陷阱,并附有直观图解和选型建议。
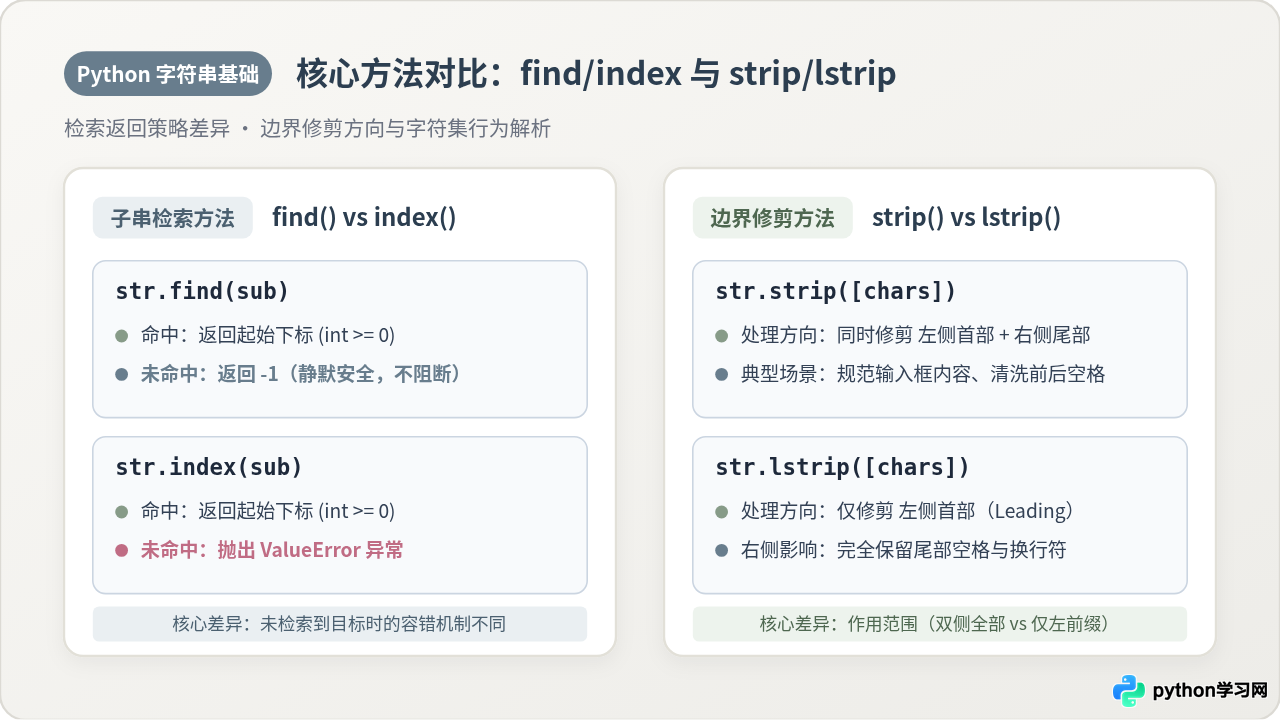
在 Python 字符串处理中,两组方法常常被初学者混淆:一类用于子串定位(find 与 index),另一类用于边界清洗(strip 与 lstrip)。直接给出核心结论:find() 与 index() 的唯一本质区别在于“未找到目标子串”时的处理方式,find() 返回 -1,而 index() 会抛出 ValueError 异常;strip() 与 lstrip() 的核心区别在于修剪方向,strip() 同时剥离字符串首尾两端的字符,而 lstrip() 仅处理左侧(开头部份),保留右侧尾部内容。本文通过具体示例、场景对比与执行图解,彻底厘清它们的设计初衷与使用边界。
一、find 与 index:未命中时的返回值与异常策略
Python 提供了多种查找子串位置的方式。当我们需要获取某个子串在母串中第一次出现的索引下标时,str.find() 与 str.index() 都可以完成任务,它们的入参格式完全相同:
# 方法签名
str.find(sub[, start[, end]])
str.index(sub[, start[, end]])
参数 sub 表示要查找的目标子串,可选的 start 和 end 表示在切片区间 [start:end] 内进行搜索。
1. 成功匹配时的表现
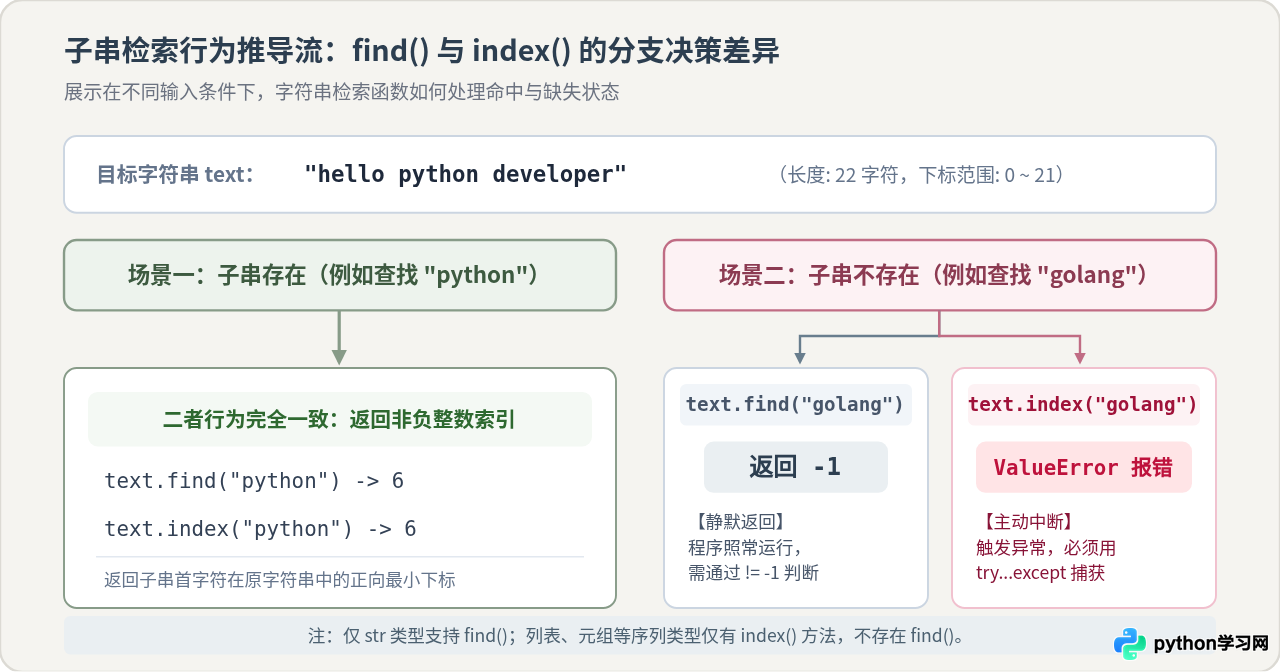
当目标子串存在于母串中时,两者的行为没有任何差别,都会返回子串首字符在母串中从左往右首次出现的正向整数下标(从 0 开始计数):
text = "hello python developer"

# 示例:查找存在的子串
print(text.find("python"))   # 示例输出: 6
print(text.index("python"))  # 示例输出: 6
2. 未检索到目标时的本质分歧
关键差异出现在“未命中”时:
find()采取宽容容错策略,返回数值-1,程序不会因此中断。index()采取严格断言策略,直接触发ValueError: substring not found异常,若未捕获将导致整个程序终止。
text = "hello python developer"

# 1. 使用 find() 查找不存在的子串
res_find = text.find("golang")
print(res_find)  # 示例输出: -1 (安全返回,流程继续)

# 2. 使用 index() 查找不存在的子串
try:
    res_index = text.index("golang")
except ValueError as e:
    print(f"捕获到异常: {e}")  # 示例输出: 捕获到异常: substring not found
初学者容易写出形如 if text.find("hello"): 的代码。当目标位于字符串开头(索引为 0)时,由于数字 0 在 Python 中会被隐式转换为 False,会导致分支判断失误。如果需要判断是否存在,应明确写为 if text.find("hello") != -1:,或者直接使用最优雅的 if "hello" in text:。
二、strip 与 lstrip:清洗方向与字符集合匹配机制
字符串在接收外部输入(如文件读取、控制台输入或网络请求)时,两端往往携带多余的空格、制表符或换行符。Python 的 strip() 与 lstrip() 便是专门处理这类边界冗余的内置方法。
1. 默认参数下的空白字符剥离
如果不传入任何实参,两者都会默认剔除所有的标准 ASCII 空白符(包括空格 ' '、制表符 ' '、换行符 '
'、回车符 '
' 等):
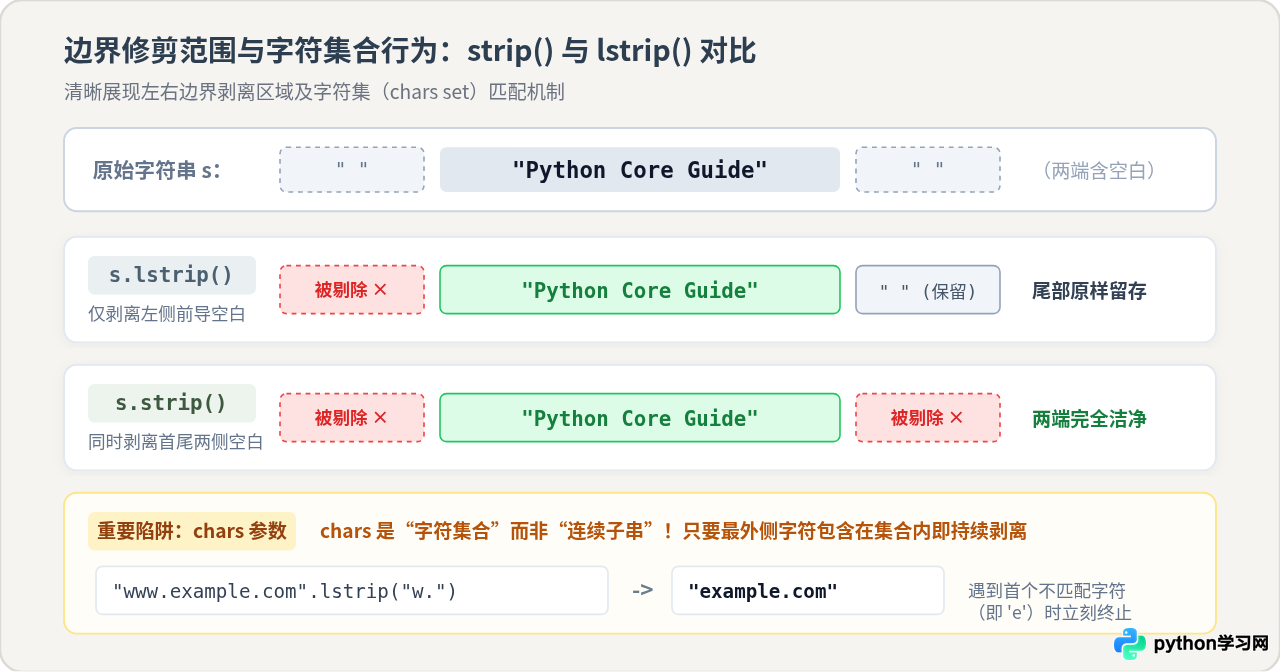
lstrip()(Left Strip):仅扫描字符串左侧(头部),剔除所有连续出现的空白,直到遇到第一个非空白字符即停止;右侧所有的空白原封不动保留。strip():同时从左端和右端向内收拢扫描,两端的连续空白全部剔除,仅保留中间的正文区域。
raw_text = "  	  python_guide
  "

# lstrip: 仅清左侧
left_cleaned = raw_text.lstrip()
print(repr(left_cleaned))
# 示例输出: 'python_guide
  '

# strip: 两侧通清
both_cleaned = raw_text.strip()
print(repr(both_cleaned))
# 示例输出: 'python_guide'
2. 指定 chars 参数时的“字符集合”陷阱
很多开发者误以为 s.strip("abc") 或 s.lstrip("abc") 是将整个单词 "abc" 当作固定前缀或后缀切除。这是严重的理解误区。
chars 参数在底层被解释为一个无序的字符集合(Character Set)。解释器会从边缘逐个检查当前字符是否存在于该集合内,只要存在就继续剥离,直到遇到第一个不在集合中的字符为止:
url = "www.example.com"

# chars 传入 "w.",包含字符 'w' 和 '.'
print(url.lstrip("w."))
# 示例输出: 'example.com' (连续的 'w' 和 '.' 均被剔除,遇到 'e' 时停止)

path = "spams.txt"
# 如果误以为是去掉前缀 "spam",实际上会剔除字符 's', 'p', 'a', 'm'
print(path.lstrip("spam"))
# 示例输出: '.txt' (前四个字符均在集合中)
如果业务需求是“精准去除固定的前缀或后缀子串”(而不是字符集),在 Python 3.9 及以上版本中,应使用官方新增的专属方法:str.removeprefix(prefix) 与 str.removesuffix(suffix)。它们严格按照整体字符串匹配,绝不会误删额外字符。
三、选型决策指南:不同业务场景该如何选用?
了解了机理后,在实际项目中如何做出清晰规范的选择?以下是标准决策路径:
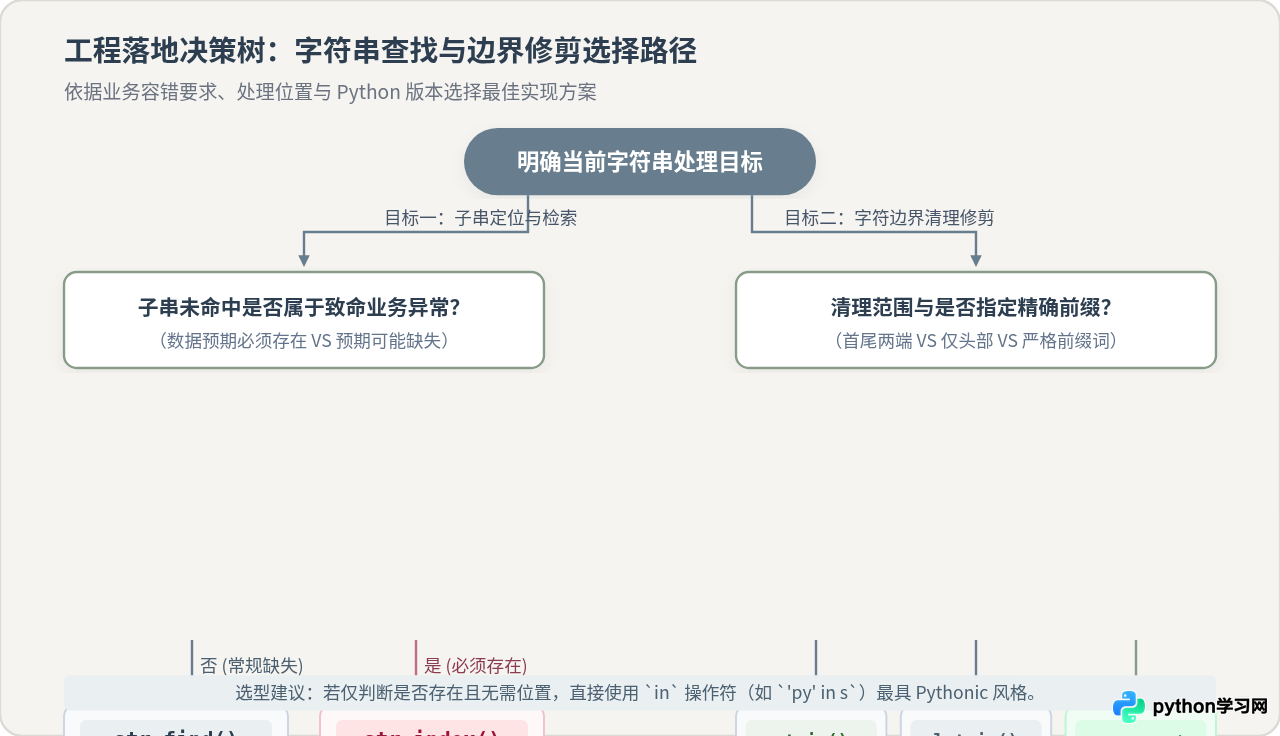
1. find 与 index 的选型条件
- 使用 find() 的场景:
- 需要知道子串所在的具**置(下标),但子串是否出现是不确定的;
- 希望通过轻量的
idx != -1进行简单分支分流,不希望在正常业务逻辑中引入try...except结构。
- 使用 index() 的场景:
- 按照业务规则,子串必须存在。若缺失说明数据严重畸变或协议损坏,需要第一时间阻断并抛错排查;
- 在编写通用序列处理逻辑时,与列表(
list.index)或元组(tuple.index)保持统一的异常处理接口(列表等类型没有 find 方法)。
2. strip 与 lstrip 的选型条件
- 使用 strip() 的场景:
- 用户表单、配置文本、CLI 参数等外部输入的标准化清洗;
- 文件按行读取(
line.strip())且不需要保留行尾回车符的场景。
- 使用 lstrip() 的场景:
- 仅需要消除前导缩进空格或制表符,但必须严格保留行尾的换行符(如代码格式化、日志重构);
- 剔除数字字符串前多余的填充字符(如
"00042".lstrip("0"))。
四、全维度对比速查
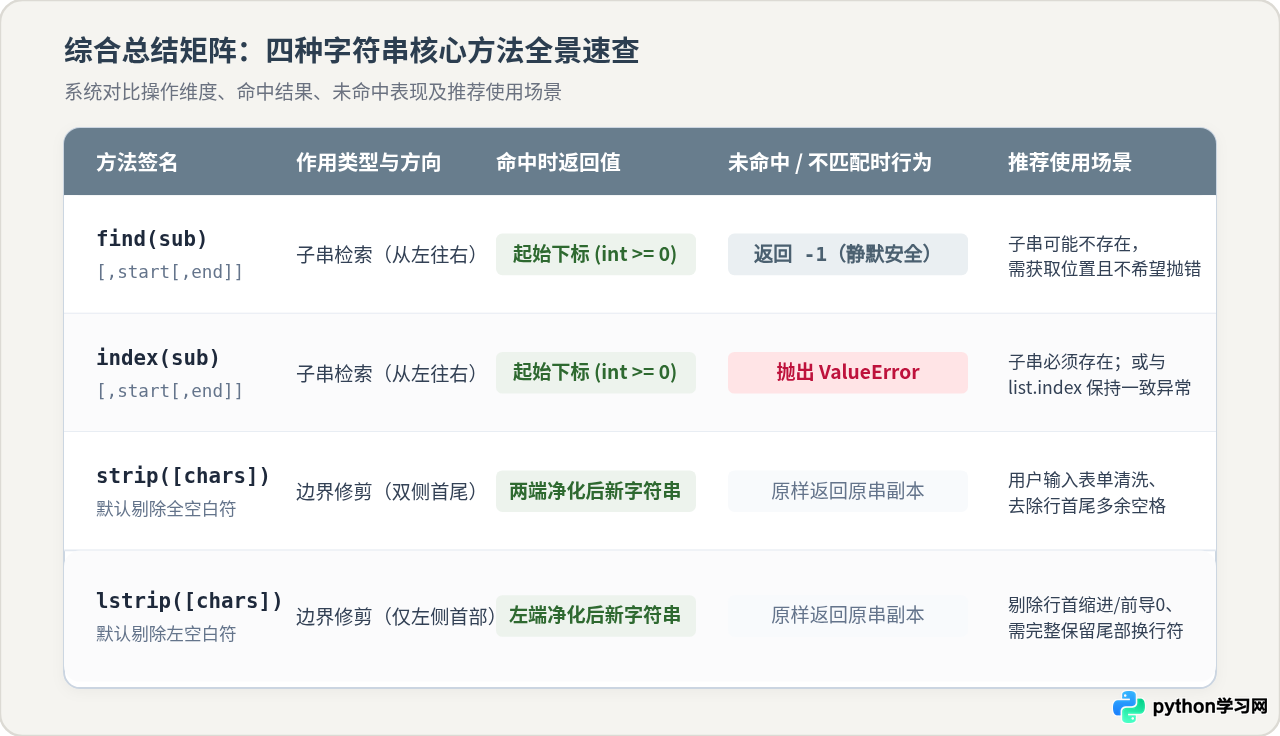
为了便于日常编码快速查阅,下表总结了这四种方法的关键差异:
| 方法名称 | 所属功能类别 | 参数说明 | 匹配成功结果 | 未命中 / 不匹配表现 | 对应反向方法 |
|---|---|---|---|---|---|
find() |
子串定位 | sub[, start[, end]] |
首字符整数索引 (int >= 0) | 返回 -1(静默安全) | rfind() |
index() |
子串定位 | sub[, start[, end]] |
首字符整数索引 (int >= 0) | 抛出 ValueError 异常 |
rindex() |
strip() |
边界修剪 | [chars] 默认为空白字符 |
返回去除首尾字符后的新字符串 | 未命中则原样返回原串副本 | 双向无反向 |
lstrip() |
边界修剪 | [chars] 默认为空白字符 |
仅去除左侧字符后的新字符串 | 未命中则原样返回原串副本 | rstrip() |
五、常见问题解答与注意事项
问:只判断字符串是否包含某单词,既不想得到 -1,也不想捕获异常,该用什么?
答:直接使用 Python 的成员运算符 in。例如 if "python" in text:。这是官方最推崇、执行速度最快、语义最直观的写法。
问:strip() 与 lstrip() 会修改原字符串吗?
答:绝对不会。在 Python 中,字符串是不可变对象(Immutable)。无论调用哪个方法,原字符串对象都不会发生任何改变,函数总是返回一个处理后的全新字符串对象。
问:除了 lstrip,右侧单独修剪对应什么方法?
答:对应 rstrip()(Right Strip),它仅修剪右侧尾部,保留左侧所有空白或符号。同理,查找右侧最后一次出现的索引对应的是 rfind() 与 rindex()。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









