

Python数据可视化库选型:Matplotlib、Seaborn与Plotly对比

在 Python 数据分析与可视化技术栈中,Matplotlib、Seaborn 和 Plotly 是认知度最高、应用最广泛的三大类库。做选型时,最核心的依据并不是“谁的技术更先进”,而是交付成果的展示媒介与业务场景的交互需求:如果目标是学术论文印刷或追求像素级的图元排版细节,选择 Matplotlib;如果聚焦于探索性数据分析(EDA)、需要面向表格数据快速产出严谨美观的统计分布图,选择 Seaborn;如果交付物是业务仪表板、Web 页面或需要读者自助完成缩放、下钻与悬停提示的富交互场景,选择 Plotly。
一、三大可视化库的核心架构与设计哲学
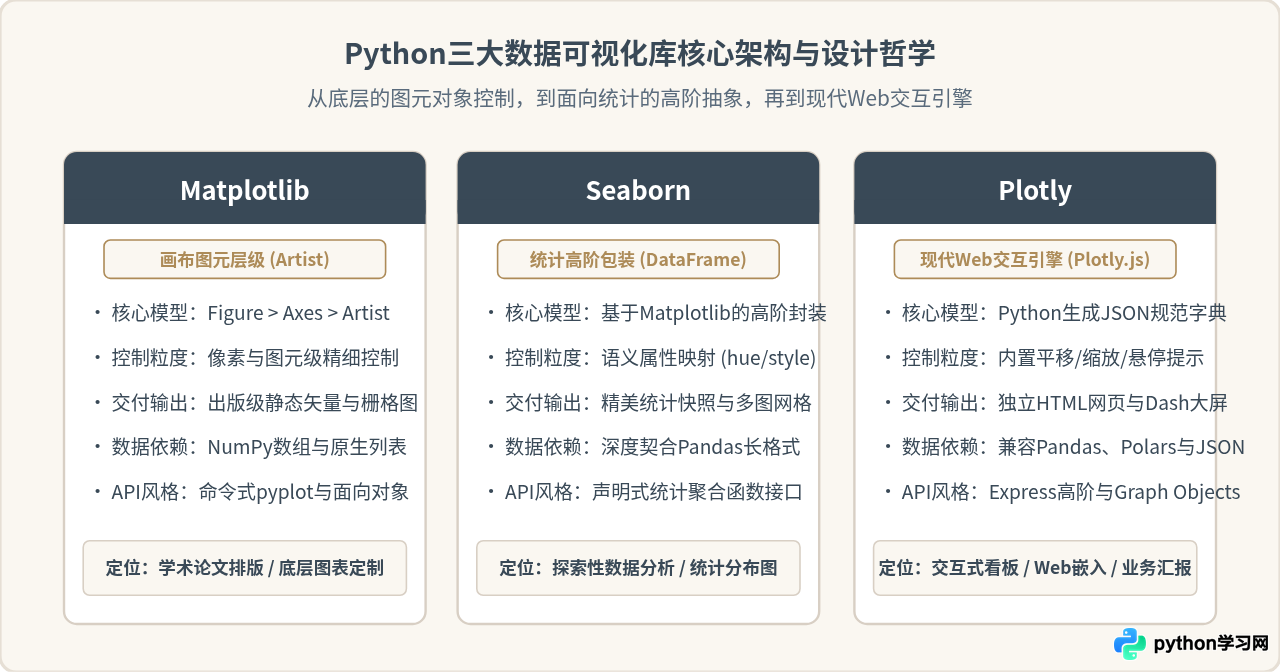
理解库的底层实现方式,能够从根源上解释为什么某些图表在一个库中只需一行代码,而在另一个库中却需要编写大量配置。这三个库分别代表了三种不同的图形构建范式。
Matplotlib 采用经典的面向对象画布体系。它的底层核心是 Figure(画布)、Axes(坐标轴容器)以及具体的 Artist(基本图元,如折线、矩形、文字等)。Matplotlib 将图像看作一张图纸,开发者通过坐标定位将线条、网格和标签绘制在指定区域。它提供了两套接口:一套是模仿 MATLAB 的命令式 pyplot 状态机,另一套是更严谨的显式面向对象接口。这种设计赋予了开发者掌控每一个像素位置的能力,但也带来了繁冗的代码量。
Seaborn 是构建在 Matplotlib 之上的高级统计绘图封装。它的设计哲学是“面向数据表格(DataFrame)的语义映射”。在 Seaborn 中,开发者无需手动计算误差棒、核密度曲线或循环切分分组数据,而是直接将列名映射到视觉通道(例如 x、y、hue、style 和 size)。Seaborn 会在后台自动完成统计聚合与置信区间运算,并套用符合现代审美的主题配置,极大地降低了统计制图的心智负担。
Plotly 则属于现代 Web 时代的图形体系。它的 Python 库本质上是一套面向 Plotly.js 引擎的配置生成器。无论使用简洁的 Plotly Express 还是底层的 graph_objects,Python 代码执行后都会输出一个描述图形特征的标准 JSON 规范。该规范由前端的 WebGL 和 D3.js 渲染引擎解析并呈现在浏览器中。因此,Plotly 图表天然具备平移、框选放大、动态高亮与悬停提示等交互能力。
二、核心评测维度深度横向对比
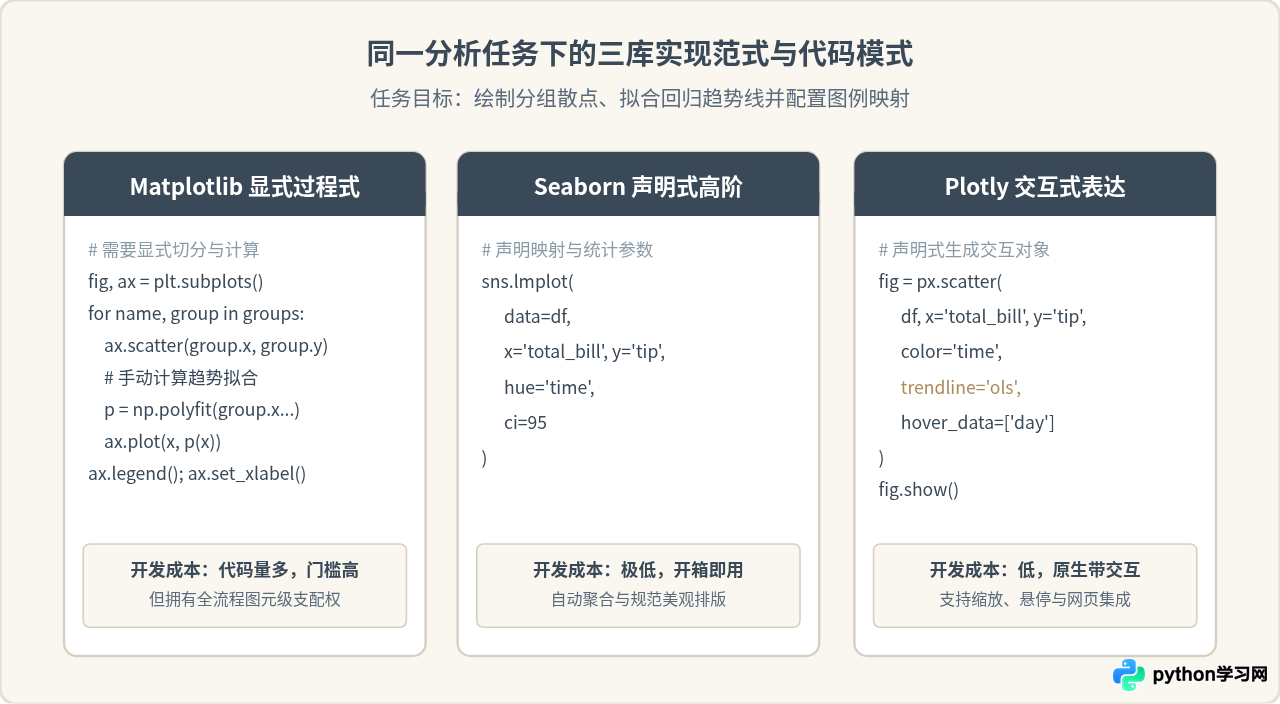
为了直观展示三者在日常开发中的体验差异,我们以一个典型的业务场景为例:根据消费金额与小费金额绘制散点图,按用餐时段分组着色,并自动计算各组的线性趋势线与图例。
1. 代码实现效率与 API 表达范式
在完成上述任务时,不同库的代码量和逻辑复杂度呈现出明显的断层:
- Matplotlib 需要显式循环与手动数学拟合:开发者必须先按分类对数据进行
groupby遍历,为每个分组手动调用ax.scatter;为了画出趋势线,还需借助 NumPy 计算回归参数,再调用ax.plot连线,最后手动开启图例并设置坐标轴标签。 - Seaborn 只需声明数据与语义通道:通过
sns.lmplot(data=df, x='total_bill', y='tip', hue='time'),单行代码即可自动完成分组散点、线性拟合、置信区间半透明填充带以及图例创建。 - Plotly 在极简代码下直接赋予动态能力:通过
px.scatter(df, x='total_bill', y='tip', color='time', trendline='ols'),不仅在两行内完成统计拟合,生成的图表还直接附带鼠标悬停数据标签与图例点击过滤功能。
2. 静态交付物与交互式体验的取舍
交付物的形态往往是选型的“硬性边界”。
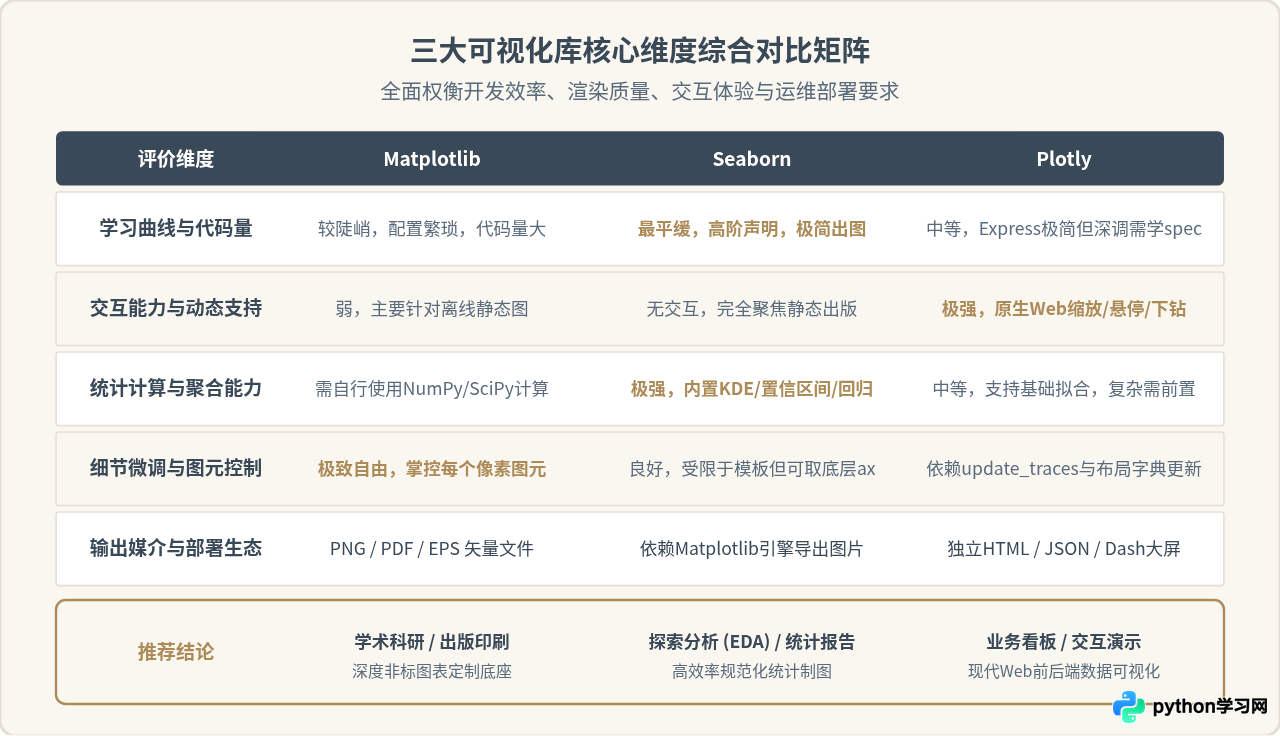
Matplotlib 和 Seaborn 默认针对静态媒介设计。它们支持导出高分辨率 PNG、JPG 以及不失真的 PDF、EPS 和 SVG 矢量文件。学术期刊、纸质出版物和 PDF 报告对排版尺寸有严格要求,例如要求双栏排版宽度固定为 3.3 英寸、字体必须内嵌且分辨率达到 300 DPI 以上。在这些严苛的印刷场景下,Matplotlib 是无可争议的标准。
然而,在需要向业务方汇报、或者嵌入内部管理后台时,静态图片无法满足下钻探索的需求。Plotly 生成的是包含数据与渲染逻辑的 HTML,读者可以在图表上滑动放大特定时间区间、双击重置、悬停查看具体数值、或者点击图例单独隐藏某一类别。这种自主探索体验是静态图片完全无法提供的。
3. 统计表达与复杂数据关系挖掘
在统计学图形(如小提琴图、箱线图、联合分布图 jointplot、成对关系矩阵 pairplot)的表达上,Seaborn 展现出最强大的专业性。它原生整合了 SciPy 与 Statsmodels,在绘图时不仅展示数据点,还直接完成核密度估计(KDE)、局部加权回归(LOWESS)以及自举法置信区间(Bootstrap CI)计算。
Matplotlib 绘制这类图表需要用户自己先运行统计计算库,准备好均值与方差后再组装图元;而 Plotly 虽然也支持部分统计图,但在处理复杂的成对矩阵与高级统计密度估计时,配置参数明显不如 Seaborn 完备自然。
三、选型决策工作流:4步确定最优方案
面对实际项目需求,建议按照以下由浅入深的四步工作流进行筛选,避免在后期因架构不匹配而推倒重来。
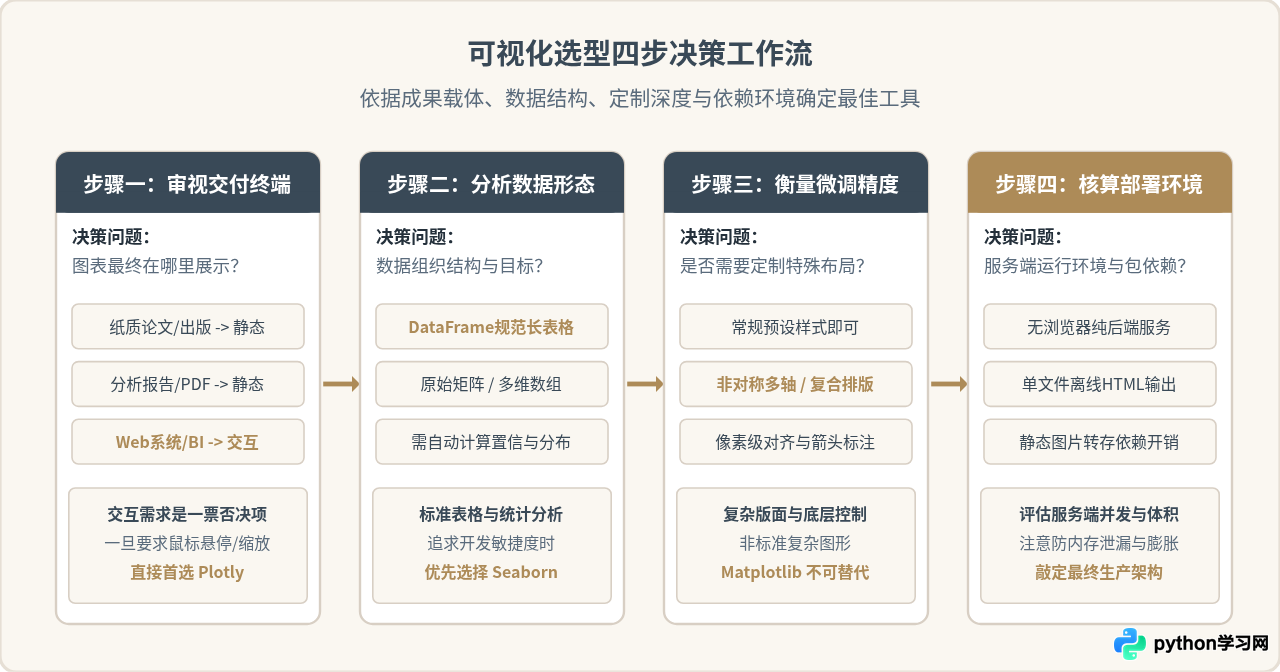
步骤一:审视交付终端与读者角色
这是最高优先级的前置条件。如果受众需要直接在网页上缩放曲线查看细节,无论 Matplotlib 的微调能力多么强大,都不应强行使用它生成静态图片并自建刷新接口,应当直接选择 Plotly;反之,如果文章需要向严谨的学术期刊投稿,投稿系统明确要求提交 EPS 或 PDF 格式的矢量源文件,则应直接排除 Plotly,优先选用 Matplotlib。
步骤二:分析输入数据形态与处理开销
如果数据已经清洗为标准的“整洁数据(Tidy Data / 长格式 DataFrame)”,且任务是探究两列数值在不同分类下的中位数、置信区间或分布密度,Seaborn 是效率最高的选择;如果数据来源于物理仿真、深度学习模型输出的多维 Tensor 或无标签的原始矩阵,Matplotlib 能够直接对数组切片进行像素化映射,省去了转构为 DataFrame 的性能损耗。
步骤三:衡量个性化排版与细节定制需求
当面对高度定制化的特殊视觉设计时(例如双 Y 轴且刻度非线性对齐、主图内嵌放大局部子图、特定位置绘制指示箭头与公式注记),Seaborn 的高阶 API 往往无法完全覆盖。此时的最佳实践是:利用 Seaborn 生成基础统计图并获取其返回的 Axes 对象,再调用 Matplotlib 的底层方法进行微调,或者直接使用纯 Matplotlib 进行面向对象绘制。
步骤四:核算生产环境依赖与渲染性能
在自动化任务中必须考虑运行环境的约束:
- Plotly 的静态导出代价:在 Python 后端将 Plotly 图表导出为静态图片(如 PNG/PDF)需要安装
kaleido依赖或 Chromium 引擎无头服务。如果生产容器环境对镜像体积敏感,这会带来额外开销。 - 数据量瓶颈:Plotly 会将数据以 JSON 形式完整嵌入页面中。当数据量超过数十万个点时,生成的 HTML 文件体积可能高达数十兆,导致浏览器渲染卡顿甚至崩溃。此时更适合用 Matplotlib/Datashader 在服务端完成栅格化后再传输。
四、综合选型决策矩阵与实战场景速查
综合评估各项工程指标,三大可视化库的横向对比如下表与速查矩阵所示:
实战避坑与工程注意事项
在 Django 或 Flask 等 Web 服务中,如果使用
import matplotlib.pyplot as plt 绘图并保存,默认的 pyplot 状态机不是线程安全的,多请求并发时极易引发图像错乱与内存持续泄漏。正确做法是在入口处指定非交互式后端 matplotlib.use('Agg'),并且务必显式调用 fig.clf() 与 plt.close(fig) 释放句柄。
调用
fig.write_html('report.html') 时,默认会将约 3MB 的 plotly.js 完整代码内嵌到每一个 HTML 文件中。如果需要生成成百上千个报告,建议配置参数 include_plotlyjs='cdn',使生成的 HTML 体积从数兆骤降至数十 KB。
Seaborn 的绘图函数分为两类:轴级函数(如
sns.scatterplot,返回 Axes)与图级函数(如 sns.relplot、sns.lmplot,返回 FacetGrid)。若需定制标题间距或坐标轴范围,轴级函数可直接使用 ax.set_title(),而图级函数必须通过 g.fig.subplots_adjust() 或 g.set_axis_labels() 进行操作。
总结
成熟的 Python 数据工程师很少局限于某一个库,而是形成组合拳:在数据探索阶段,用 Seaborn 快速验证分布假设;在学术发表或需要精雕细琢的高质量报告中,以 Matplotlib 作为图元定制基石;在需要交付给客户、产品经理或嵌入业务系统的场景下,依托 Plotly 输出生动立体的交互图形。根据交付载体和定制深度的不同做出合理选型,能够以最小的代码成本实现最优的信息传达效果。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









