

Python格式化输出符号大全:从%占位符到f-string语法
系统梳理Python从%占位符、str.format()到f-string的格式化输出语法体系,详解常用符号、对齐补零、精度控制、进阶技巧与避坑指南。
在Python开发过程中,构建结构清晰、格式对齐的数据输出是日常高频需求。从早期的C语言风格 % 占位符,到Python 2.6引入的 str.format() 方法,再到Python 3.6成为行业标准的 f-string(格式化字符串字面量),Python的字符串格式化机制经历过三次重大演进。本文直接拆解这三代语法的核心符号体系,详细说明类型说明符、宽度填充、对齐规则与精度控制,并提供选型依据与避坑建议。
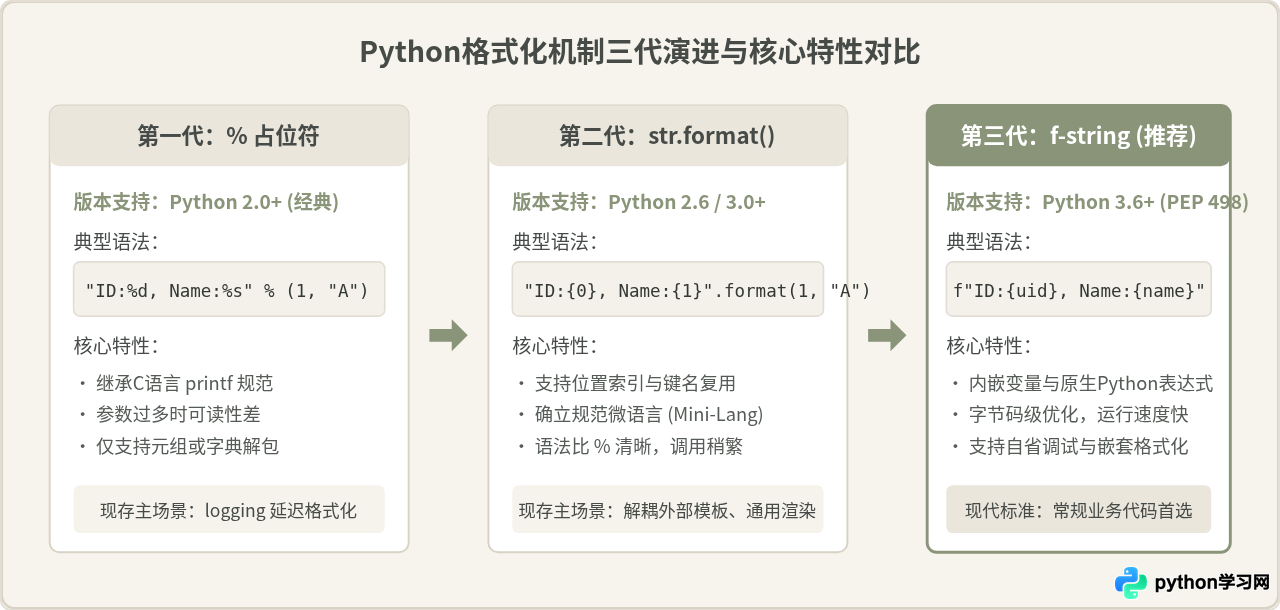
一、Python三代格式化机制演进与特性对比
理解符号的作用前,需要清楚不同写法适用的场景。三种方式在底层机制、语法表达与运行性能上均有明确区别:
- % 占位符运算符(经典风格):基于类C语言的
printf语法模型。语法紧凑,但多个参数时必须严格打包为元组,参数类型与位置必须精确对应,遇到字典或复杂对象时书写冗长。 - str.format() 方法(现代过渡):引入了“格式规范微语言”(Format Specification Mini-Language),通过
{}区分占位符,支持按索引、关键字解包传参,摆脱了元组绑定的限制。 - f-string 格式化字面量(现代标准):PEP 498引入的原生语法。字符串以
f或F为前缀,大括号内直接写入变量或有效表达式,在Python编译期解析为高效的字符串构建字节码,运行速度相比前两者提升约2到3倍。
二、常用格式化转换符号大全(Type Specifiers)
类型转换符号指定了数据应以何种格式(文本、整数、定点小数、二进制、科学计数等)呈现。在 % 语法中,符号紧跟 %;而在 format() 与 f-string 中,符号写在冒号 : 之后。
| 类型符号 | 含义解释 | % 占位符示例 | f-string 对应示例 | 格式化结果输出 |
|---|---|---|---|---|
s |
字符串(调用对象的 __str__()) |
"%s" % "Python" |
f"{'Python':s}" |
Python |
r |
原始表现形式(调用 __repr__()) |
"%r" % "Python" |
f"{'Python'!r}" |
'Python'(带外层引号) |
a |
ASCII安全字符(调用 ascii()) |
"%a" % "中文" |
f"{'中文'!a}" |
'\u4e2d\u6587' |
d / i |
十进制有符号整数 | "%d" % 42 |
f"{42:d}" |
42 |
b |
二进制整数(%不支持,现代语法专属) | 不支持 | f"{10:b}" |
1010 |
o |
八进制无符号整数 | "%o" % 10 |
f"{10:o}" |
12 |
x / X |
十六进制整数(小写 / 大写) | "%x, %X" % (255, 255) |
f"{255:x}, {255:X}" |
ff, FF |
f / F |
定点浮点数(默认保留6位小数) | "%.2f" % 3.14159 |
f"{3.14159:.2f}" |
3.14 |
e / E |
科学计数法指数输出 | "%.2e" % 10000 |
f"{10000:.2e}" |
1.00e+04 |
g / G |
通用格式(大数值切指数,小数值切定点) | "%g" % 1234567 |
f"{1234567:g}" |
1.23457e+06 |
% |
百分比格式(数值自动乘以100并带%) | 无直接对应 | f"{0.8525:.1%}" |
85.3% |
c |
单个字符(可接受整型编码或单字符) | "%c" % 97 |
f"{97:c}" |
a |
% 语法中,输出字面量 % 符号必须双写为 %%;而在 f-string 中,百分号是纯普通文本,如需输出文本百分号直接写 % 即可,例如 f"{rate*100:.1f}%"。
三、进阶控制:宽度、对齐、补零与千分位实战
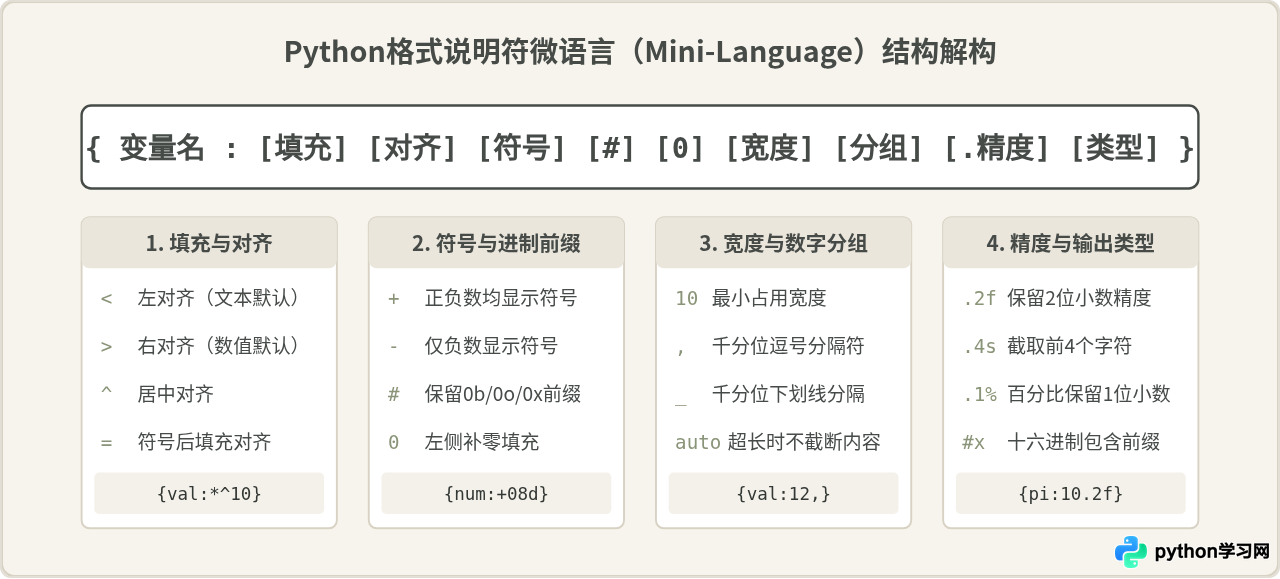
日常业务开发中,格式化不仅为了替换变量,更为了对齐输出表格或规范金额展示。通过组合上述修饰符号,可以实现精确的排版效果:
1. 字段宽度与对齐方式
# 默认对齐规则:字符串默认左对齐,数值默认右对齐
name = "Alice"
score = 95.5

# 设定宽度为10
print(f"|{name:<10}|")    # 显式左对齐输出: |Alice     |
print(f"|{name:>10}|")    # 显式右对齐输出: |     Alice|
print(f"|{name:^10}|")    # 居中对齐输出:   |  Alice   |

# 指定填充符号(填充字符写在对齐符号之前)
print(f"|{name:*^10}|")   # 输出: |**Alice***|
print(f"|{score:->10.1f}|") # 输出: |------95.5|
2. 数字补零与符号控制
n = 42
neg = -42

# 补零:固定8位数字,不足在左侧填0
print(f"{n:08d}")         # 输出: 00000042

# 符号修饰符:
print(f"{n:+d}")          # 输出: +42 (正负数均带符号)
print(f"{n: d}")          # 输出:  42 (正数保留一个空格作为占位)
print(f"{neg:+d}")        # 输出: -42 (负数正常带负号)

# 符号后填充(=修饰符,符号固定在最左端,填充在符号与数字之间)
print(f"{neg:0=8d}")      # 输出: -0000042
3. 千分位金额与数字分组
amount = 1234567890.75

# 使用逗号作为千分位分隔符
print(f"{amount:,.2f}")   # 输出: 1,234,567,890.75

# 使用下划线作为千分位分隔符(PEP 515)
print(f"{amount:_.2f}")   # 输出: 1_234_567_890.75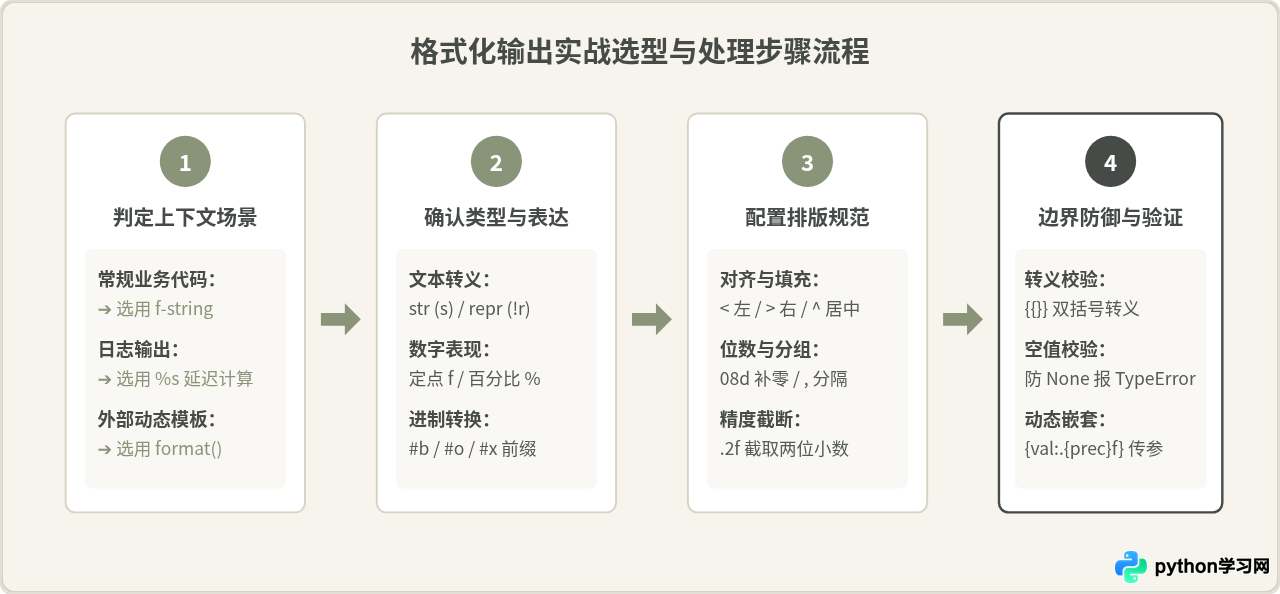
四、f-string 专属高阶用法
除了常规的替换与对齐,现代Python(尤其是Python 3.8及更高版本)为 f-string 增加了多项显著提升生产力的特性:
1. 自省调试表达式(= 语法)
从Python 3.8开始,在表达式后追加 = 符号,可在输出时同时打印“表达式文本”和“求值结果”。在打印排查变量时无需再重复书写变量名:
user_id = 10086
status = "ACTIVE"

# 传统写法: print(f"user_id={user_id}, status={status}")
# 现代等号自省语法:
print(f"{user_id=}, {status=}")
# 运行输出结果: user_id=10086, status='ACTIVE'

# 同时支持格式控制修饰符
score = 89.236
print(f"{score=:.1f}")
# 运行输出结果: score=89.2
2. 日期时间直接格式化
处理 datetime 对象时,不需要先调用 strftime(),可以直接在大括号内部声明时间格式化符号:
from datetime import datetime
now = datetime(2026, 10, 20, 15, 30, 45)

# 直接在 f-string 中内联时间指令
print(f"当前时间: {now:%Y-%m-%d %H:%M:%S}")
# 输出: 当前时间: 2026-10-20 15:30:45
3. 动态嵌套格式化
格式规范修饰符自身也可以是动态表达式。例如将保留的小数位数或宽度交由变量控制:
pi = 3.1415926535
decimals = 3
width = 12

# 格式控制符中的大括号表示二次求值
print(f"|{pi:{width}.{decimals}f}|")
# 输出: |       3.142|
五、常见认知误区与避坑指南
在讨论格式化方案时,开发者常有一些看似合理但存在偏差的认知,需要结合具体工程场景辨析:
1. 误区一:“% 格式化已经彻底过时,应当全面弃用?”
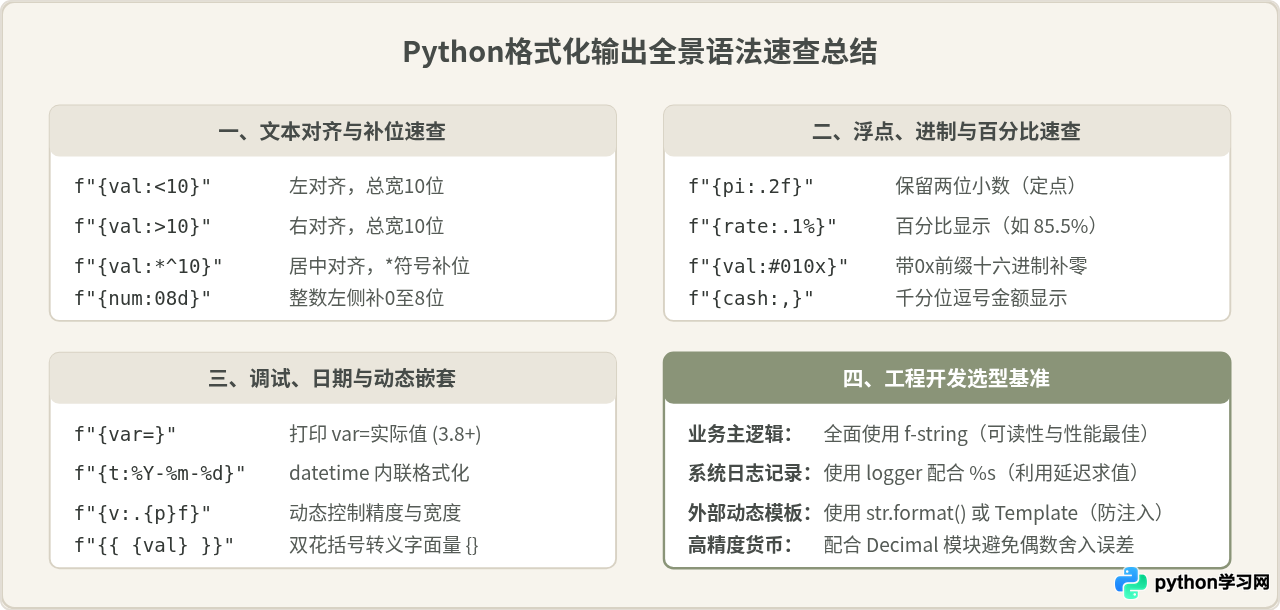
辨析:在普通业务逻辑拼接中,f-string 确实全面优于 % 占位符。但在 Python 标准 logging 模块 中,官方依然强烈建议使用 logger.info("用户登录失败: %s, 尝试次数: %d", user, count) 的 % 语法。原因在于日志框架具有级别过滤机制(如生产环境只打 WARNING),如果使用 logger.info(f"..."),不论该条日志最终是否写入文件,f-string 都会在被调用前立即执行字符串格式化与表达式求值,造成无谓的性能开销;而传给 logging 的 %s 占位符只在日志级别被激活时才进行延迟求值。
2. 误区二:“f-string 可以完全替代外部模板渲染?”
辨析:f-string 是“硬编码代码级”的即时求值语法,表达式必须在当前代码作用域内有效。如果开发邮件通知、代码生成器或允许运营人员自定义输出文案,模板文本往往保存在数据库或配置文件中。由于不能将不可信的外部文本直接放入 eval() 执行,f-string 无法作为外部模板使用。此时应使用 str.format() 或标准库的 string.Template(通过 $variable 占位),能够有效防范恶意代码注入。
3. 误区三:“浮点数格式化 .2f 的四舍五入总是准确的?”
辨析:Python 默认采用 IEEE 754 双精度二进制浮点数,底层存储存在精度截断;同时,Python 遵循“奇进偶舍”(Round half to even,银行家舍入法)原则,当舍入部分恰为 0.5 时,优先向最接近的偶数舍入。例如:
print(f"{2.5:.0f}")  # 输出 2 (向偶数舍入)
print(f"{3.5:.0f}")  # 输出 4 (向偶数舍入)
若在金融、计费等必须满足严格四舍五入的场景中,切勿直接依赖浮点数的格式化截断,必须引入标准库的 decimal.Decimal 配合 ROUND_HALF_UP 舍入模式。
六、总结
Python 字符串格式化的演进是一部从“语言外部借用(C语言语法)”走向“原生深度整合”的历程。掌握 %、str.format() 和 f-string 的语法符号对应关系,不仅能让日常代码中的文本拼接更具可读性与健壮性,也能在面对性能要求极高的服务、日志体系构建或复杂的动态报表时,做出准确合理的架构选型。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









