

pandas读取非逗号分隔CSV:sep参数处理Tab或竖线数据
详细讲解如何使用pandas的read_csv函数配合sep参数正确读取Tab制表符、竖线及其他非逗号分隔文本数据,涵盖单字符配置、正则表达式处理、引擎选择与数据校验。
在数据分析与工程处理中,虽然数据文件最常保存为带有 .csv 后缀的文本,但实际业务场景里的数据并非全部采用英文逗号进行分割。数据库导出备份、系统运行日志以及各类数仓明细,为了避免文本内容本身包含逗号引起字段错位,往往大量采用制表符(Tab \t)或竖线符号(Pipe |)作为列分隔符。当开发者直接调用 pd.read_csv('filename.csv') 时,pandas 默认使用英文逗号切分,结果会导致整行数据被错误地塞进单列中。解决该问题的关键就在于合理配置 sep 参数,向解析器明确传递具体的分隔规则。
一、分隔符机制与 sep 参数的作用原理
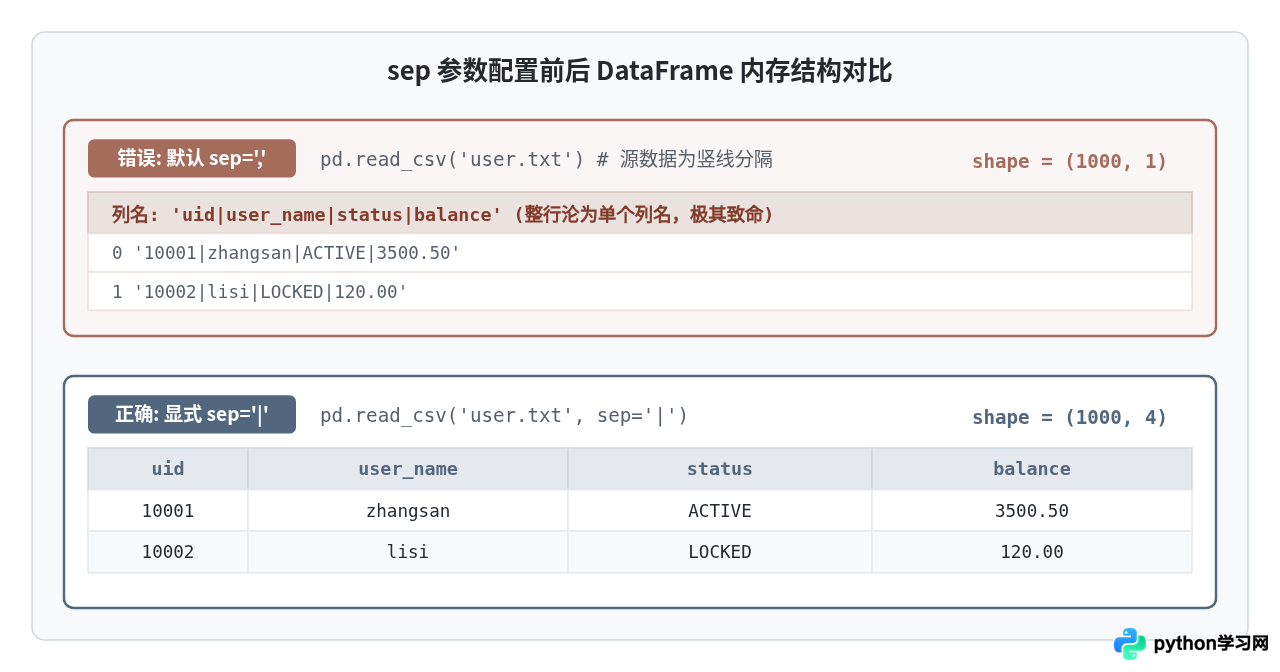
pandas.read_csv() 函数底层依赖高效的解析引擎(默认是基于 C 语言编写的高性能解析器)。解析器在扫描纯文本输入流时,必须依赖明确的字符标记来切分字段边界。当未指定参数时,内部的 sep 默认值为 ','。一旦物理文件使用的是其他字符,C 引擎在整行中找不到逗号,便会将整行文本视为一个完整的字符串字段,生成形状为 (N, 1) 的异常 DataFrame。
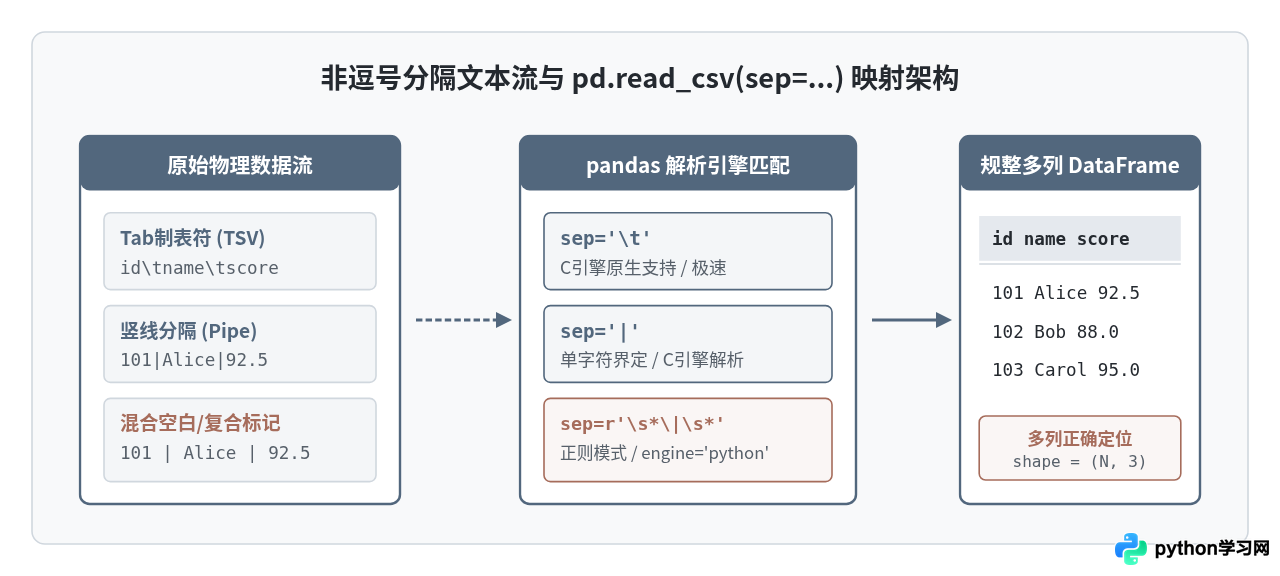
通过传入 sep 参数(亦可使用同义参数 delimiter),我们可以直接重写解析器的切分行为。不仅支持传入单字符如 \t 或 |,在需要处理复杂或不规则空白的场景下,还可以传入正则表达式,使 pandas 能够精确还原多列矩阵结构。
二、读取 Tab 制表符分隔数据(TSV)
制表符分隔格式通常拥有 .tsv 或 .tab 后缀,但也经常直接套用 .csv 或 .txt 后缀存储。在 Python 字符串中,制表符用标准转义符 \t 表示。
读取此类文件时,只需将 sep 设置为 '\t' 即可:
import pandas as pd

# 读取以 Tab 分隔的文件
df_tab = pd.read_csv('orders_tab.csv', sep='\t')

# 查看前 5 行及维度信息
print(df_tab.head())
print("数据维度:", df_tab.shape)
由于 \t 属于单字符定界符,pandas 会完全走底层的 C 解析引擎。这意味着即使处理数吉字节(GB)级别的超大文件,解析速度也与标准逗号 CSV 相当,内存占用可控且吞吐量极佳。
三、读取竖线分隔数据(Pipe 符号)
竖线(|)分隔符常见于金融对账、运营商详单或从传统关系数据库导出的文本转储。在纯文本中,竖线是普通 ASCII 字符(ASCII 124)。
直接读取纯竖线文件时,代码同样极为简练:
import pandas as pd

# 读取以竖线分隔的文本数据
df_pipe = pd.read_csv('billing_pipe.txt', sep='|')

# 检查列名与数据类型
print(df_pipe.columns.tolist())
print(df_pipe.dtypes)
需要特别注意一种实际生产中的变形:许多导出程序在生成竖线时,会在竖线左右人为保留对齐用的空格(例如 item1 | item2 | item3)。如果仅仅使用 sep='|',字段内部前后的空格会被保留下来,导致列名变成 ' item2 ' 或字符串数值变成 ' 100 ',对后续按列名索引或类型转换产生阻碍。解决该问题有两种方式:
- 配合
skipinitialspace=True:如果空格主要存在于分隔符右侧,可以忽略分隔符后的前导空白。 - 使用正则表达式作为
sep:使用sep=r'\s*\|\s*'彻底消除竖线两侧的所有游离空白。但注意一旦sep的长度超过 1 个字符或包含正则语法,pandas 将自动回退到 Python 解析引擎,或者要求明确声明engine='python'。
# 包含不规则空白的竖线数据,指定正则与 python 引擎
df_pipe_clean = pd.read_csv(
    'billing_spaced_pipe.txt',
    sep=r'\s*\|\s*',
    engine='python'
)
四、从源文件排查到加载输出的标准执行流程
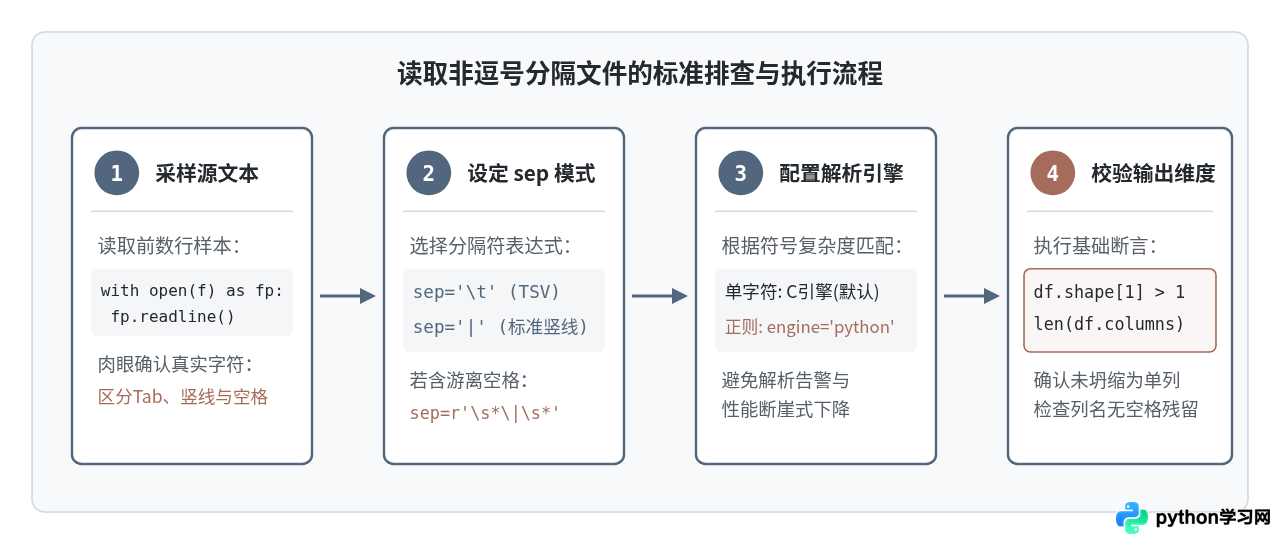
面对未知的非逗号分隔文件时,不建议直接凭感觉调用 read_csv()。推荐遵循标准化的“采样-确认-加载-校验”四步操作流程,以避免因编码或不可见字符导致的静默解析失败。
五、结构对比:默认解析失败与指定 sep 解析成功
初学者容易忽略的一个隐藏隐患是:当默认逗号解析失败时,pandas 通常不会直接抛出异常报错。因为从语法上讲,把整行文本视为单个无逗号的字符串完全符合 CSV 规范,因此程序会正常返回一个单列 DataFrame。这种“静默解析异常”如果直接流入下游的数据清洗、计算或合并链路,会导致后续由于 KeyError 或字段缺失而全面崩溃。
通过对比解析前后的内存数据结构,可以清晰看清参数修正前后的本质区别:
六、复杂场景与易踩陷阱排查
1. 竖线字符在正则表达式中的语义冲突
在正则表达式中,竖线 | 拥有特殊的语法含义,表示“逻辑或”(OR)。如果在使用复杂正则匹配分隔符时(如既想匹配逗号又想匹配竖线),必须对竖线进行转义:
# 允许逗号或竖线均作为列边界,必须使用 \| 转义
df = pd.read_csv('mixed.txt', sep=r',|\|', engine='python')
如果仅仅是单纯按单个竖线切分,直接写 sep='|' 即可。此时 pandas 会将其识别为单字符字面量,自动交由 C 引擎处理,不会触发正则编译,因此无需转义。
2. 包含任意数量空白符的日志文件
在 Linux 系统日志、Nginx 日志或旧式 Fortran 输出中,字段之间常常使用数量不定的连续空格或制表符对齐。此时单个 sep=' ' 会导致多余的空列出现。可以使用代表连续空白符的正则表达式:
# 匹配一个或多个空白字符(包括空格与Tab)
df_logs = pd.read_csv('system.log', sep=r'\s+', engine='python')

# 或者在较新版本 pandas 中使用专门参数
df_logs = pd.read_csv('system.log', delim_whitespace=True)
C 引擎执行效率高,内存开销低,但仅支持单字符定界符;一旦 sep 包含多字符或正则表达式,必须依赖 Python 引擎(engine='python')。在处理千万级超大文件时,如果可能,优先对源文件进行单字符预清洗,尽量让 pandas 运行在 C 引擎模式下。
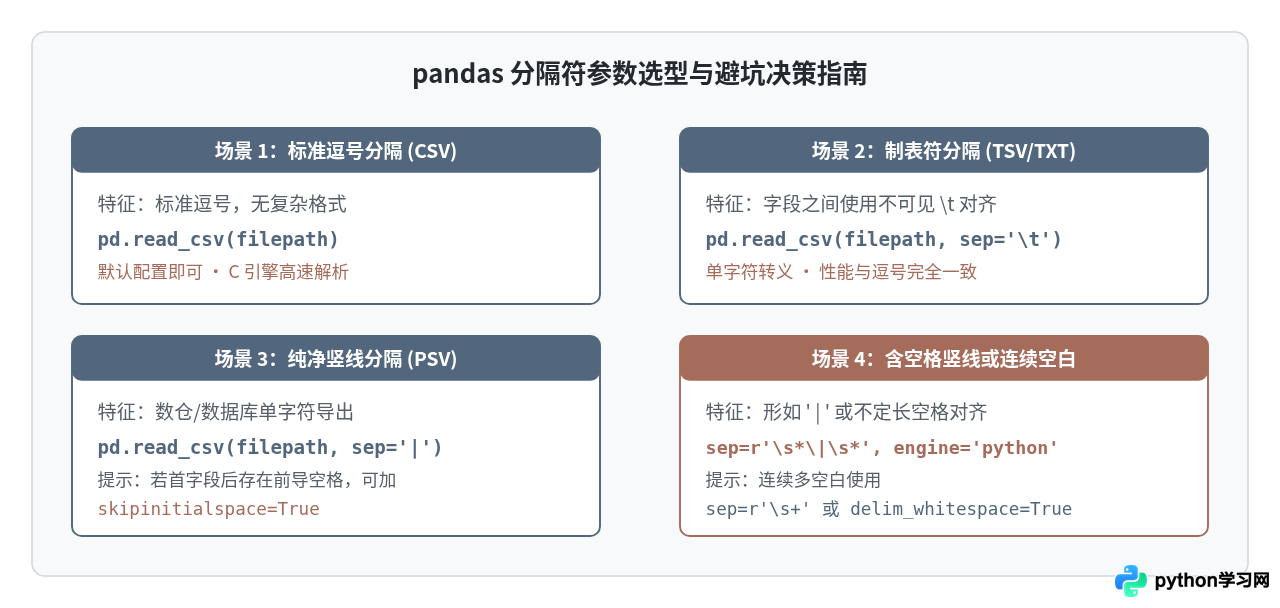
七、常用分隔符选型与避坑决策指南
在实际编码时,根据文件特性选择正确的参数组合可以快速避坑。下方的决策导图总结了主流场景下的推荐配置:
八、总结与最佳实践
处理非逗号分隔文本时,sep 参数是连接物理原始数据与内存二维表格的核心桥梁。掌握以下三项原则,即可稳妥应对绝大多数文本数据载入需求:
- 善用小切片采样:遇到陌生或格式存疑的文件,先在终端或使用 Python 文件对象读取前三行,确定其物理分隔符是单个
\t、纯|还是包含两侧空格的复合形式。 - 明确引擎边界:单字符使用默认 C 引擎兼顾高吞吐;多字符正则务必显式指定
engine='python',避免被动警告。 - 严守维度断言:在数据加载完毕后,立刻检查
df.shape与df.columns,保证列数大于 1 且列名纯净,在源头截断“单列挤压”故障向后蔓延。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









